由香港科技大学(广州)、KlingAI Research、北京大学等多所顶尖机构联合推出的 EgoCaptioner,是一款专为第一人称(Egocentric)视频设计的细粒度字幕生成模型。
- 项目主页:https://cactusqq.github.io/EgoCaptioner/
- GitHub:https://github.com/cactusqq/EgoCaptioner
- 模型:https://huggingface.co/Vickyinmyheart824/EgoCaptioner
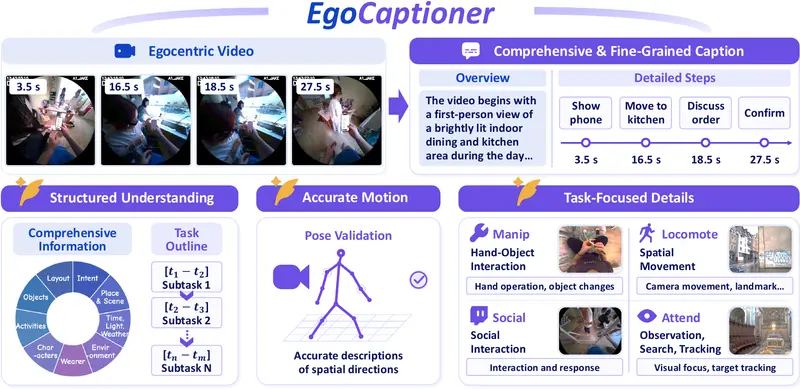
基于 Qwen3.5-9B 构建,EgoCaptioner 创新性地采用了“视频级概览 + 带时间戳步骤”的双层叙事结构,并通过从粗到细的监督机制与组相对策略优化(GRPO),在事实准确性、时间对齐及叙事连贯性上取得了突破性进展。在多个基准测试中,它不仅领先于所有评估的开源模型,更在 PhysCapBench 上超越了 Gemini 3.1 Pro,在 Minerva-Ego 的字幕到 QA 任务中超越了所有专有基线。
核心突破:解决第一人称视频的“短暂动作”与“时序混乱”难题
第一人称视频具有视角动态变化快、手部交互频繁、动作短暂且隐蔽等特点,传统多模态大语言模型(MLLM)往往难以捕捉细节或理清动作顺序。EgoCaptioner 通过以下三大创新解决了这些痛点:
1. 🎬 双层叙事结构:概览与步骤的完美融合
- 视频级概览(Overview):建立场景背景、识别参与者并概括相机佩戴者的整体活动意图,为观众提供宏观上下文。
- 带时间戳的步骤(Timestamped Steps):详细描述活动如何展开,精确标记关键时刻。叙述内容根据感知需求自适应调整,涵盖手-物体交互、空间移动、社交互动及视觉注意力转移。
2. 📈 从粗到细的注释流水线
- 研究团队利用 Gemini 3.1 Pro 和 Seed 2.1 Pro 构建了包含 50,000 个高质量示例的训练集。
- 流程遵循“全局概览 → 事件大纲 → 带时间戳的详细步骤”的逻辑,确保模型先理解整体结构,再填充微观细节,显著提升了监督的有效性。
3. 🏆 GRPO 强化学习与多维奖励机制
- 事实准确性奖励:通过评判者对提取事实的 F1 分数进行评分,确保内容真实可靠。
- 时间对齐奖励:使用时间 IoU(Intersection over Union)匹配预测步骤与参考步骤的时间戳,保证动作描述的精准同步。
- 风格一致性奖励:惩罚碎片化或冗余的叙述,鼓励生成流畅、自然的语言。
- 传感器辅助验证:当可用时,利用身体和相机姿态数据导出的运动事实来补充和校验字幕参考,进一步夯实事实基础。
卓越的性能表现
EgoCaptioner 在五个主流第一人称视频基准测试中展现了统治级的性能:
| 基准测试 | EgoCaptioner 表现 | 对比模型 | 备注 |
|---|---|---|---|
| PhysCapBench | 领先 | 超越 Gemini 3.1 Pro | 物理常识与动作理解能力突出 |
| Minerva-Ego (QA) | 领先 | 超越所有专有基线 | 字幕支持下的问答准确率最高 |
| 其他开源基准 | 全面领先 | 优于所有评估的开源 MLLM | 在字幕质量、时间对齐及条件 QA 上均占优 |
应用场景
- 智能眼镜与 AR 助手:为佩戴者提供实时的环境理解与行动记录,辅助记忆回溯。
- 技能学习与培训:自动生成带有详细步骤和时间标记的操作教程(如烹饪、维修、手术模拟)。
- 视频内容索引与检索:通过细粒度的时间戳字幕,实现视频内容的秒级定位与精准搜索。
- 具身智能训练:为机器人提供高质量的第一人称视觉-语言对齐数据,提升其对人类操作的理解能力。
© 版权声明
文章版权归作者所有,未经允许请勿转载。