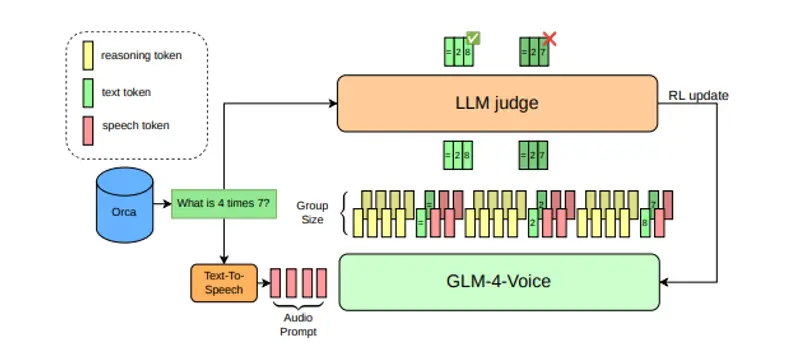
Kyutai 发布 Voice of Reason:语音原生模型用强化学习攻克口头数学,GSM8K 准确率从 27.3% 升至 77.1%Kyutai 开源 Voice of Reason 系列两个 9B 参数语音到语音模型,首次在语音原生架构中应用强化学习(RL)解决数学推理问题。模型基于 GLM-4-Voice-9B,经监督微调(S...语音模型# Kyutai# Voice of Reason1个月前540
阿里千问发布Qwen-Audio-3.1系列五大语音模型,打通音频理解、生成、实时交互全链路,并下调全线产品价格阿里千问正式发布 Qwen-Audio-3.1 系列语音大模型,一次性推出五款全新模型,覆盖语音识别、语音合成、实时语音交互,新增音频创作模型Qwen-Audio-3.1-TTS-Next、音频理解模...早报语音模型# Qwen-Audio-3.1# 阿里千问1个月前1340
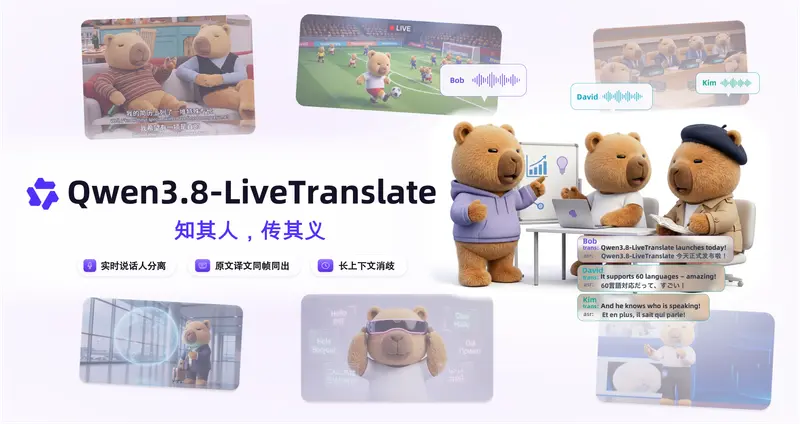
阿里千问发布同声传译大模型 Qwen3.8-LiveTranslate:Interleave 架构重构同传,字均延迟低至 2.3 秒阿里千问今日正式发布同声传译大模型 Qwen3.8-LiveTranslate。该模型采用 Interleave 架构对实时同传流程进行重构,在忠实度、流畅度与简洁度三项核心指标上实现全面提升,字均延...早报语音模型# Qwen3.8-LiveTranslate# 同声传译大模型# 阿里千问1个月前1010
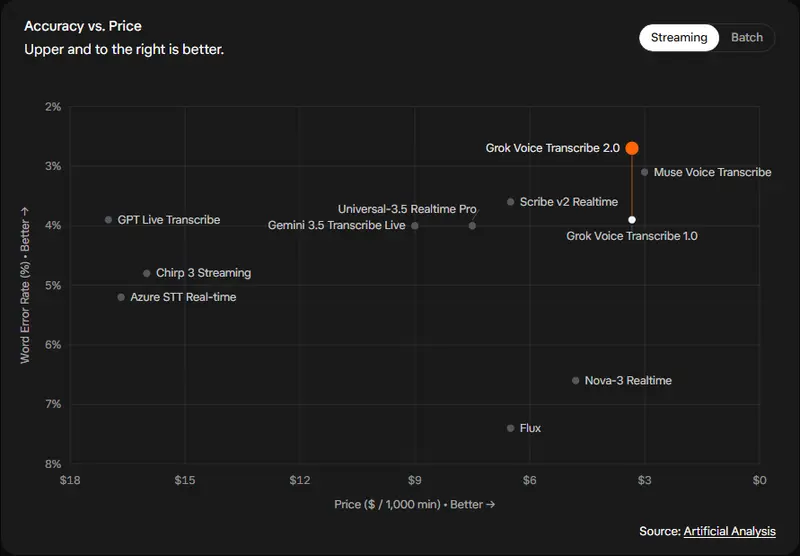
SpaceXAI 推出 Grok Voice Transcribe 2.0:准确率翻倍,批处理转录 0.1 美元 / 小时SpaceXAI 正式推出语音转文本模型 Grok Voice Transcribe 2.0,模型 ID 为 grok-voice-transcribe-2.0。该版本基于 Grok Voice 音频...早报语音模型# Grok Voice Transcribe 2.0# SpaceXAI1个月前620
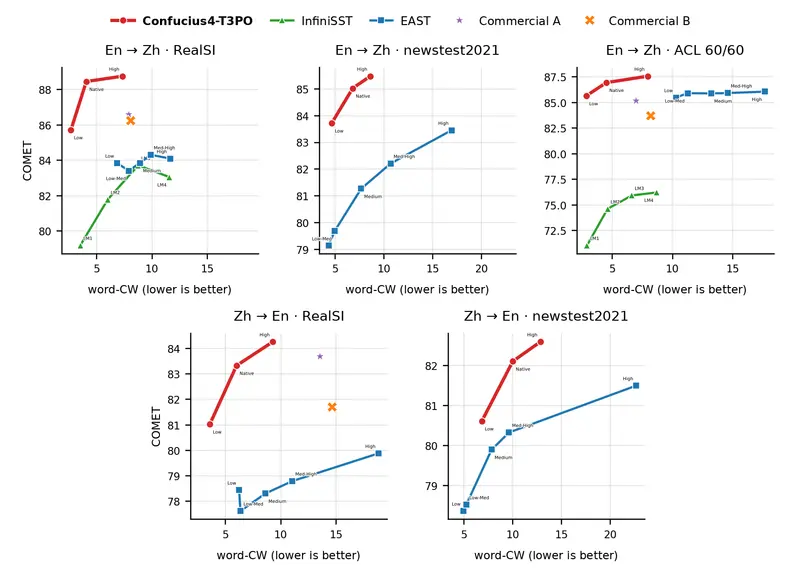
兼顾翻译质量与延迟!网易有道发布Confucius4-T3PO:基于帕累托前沿策略优化的文本同声翻译模型网易有道 AI 团队正式发布了 Confucius4-T3PO,一款拥有 140 亿参数的文本到文本(Text-to-Text, T2T)同声机器翻译(SiMT)模型。该模型通过创新的帕累托前沿策略优...语音模型# Confucius4-T3PO# 网易有道1个月前710
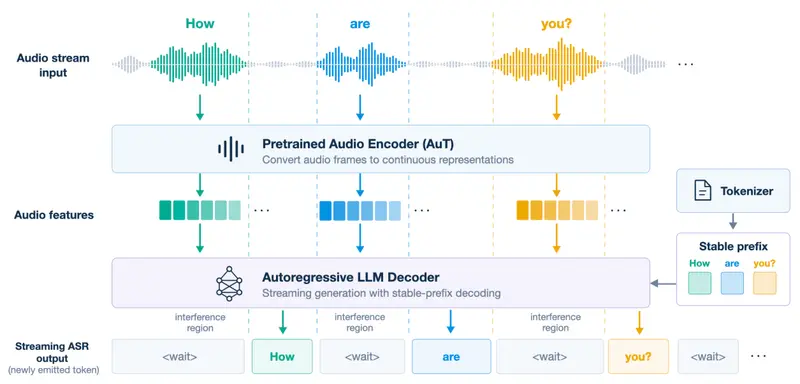
网易有道发布 Confucius4-R2T2:低延迟高准确率实时语音识别模型,适配实时字幕与 AI 智能体网易有道正式发布了 Confucius4-R2T2,一款基于 Qwen3-ASR 架构的低延迟、高准确率真流式(True Streaming)自动语音识别模型。该模型的核心突破在于解决了传统流式 AS...语音模型# Confucius4-R2T2# 实时语音识别模型# 网易有道1个月前1140
Nari Labs推出Nari Qwen3-TTS:基于 Qwen3-TTS 1.7B 定制的高性能 TTS 推理服务Nari AI 正式推出了 Nari Qwen3-TTS,一款基于阿里云 Qwen3-TTS 1.7B 模型的高性能文本转语音(TTS)服务。通过自研的专用推理引擎,Nari 在单张英伟达H100 S...早报语音模型# Nari Qwen3-TTS1个月前550
谷歌发布 Gemini 3.8 Live 系列:支持后台思考,边聊天边调用工具不打断对话谷歌正式推出了 Gemini 3.8 Live 和 Gemini 3.8 Live Extended Thinking 两款全新模型。这标志着语音交互 AI 从“简单的问答”迈向了“复杂的并行任务处理...早报语音模型# Gemini 3.8 Live# Gemini 3.8 Live Extended Thinking# 谷歌1个月前510
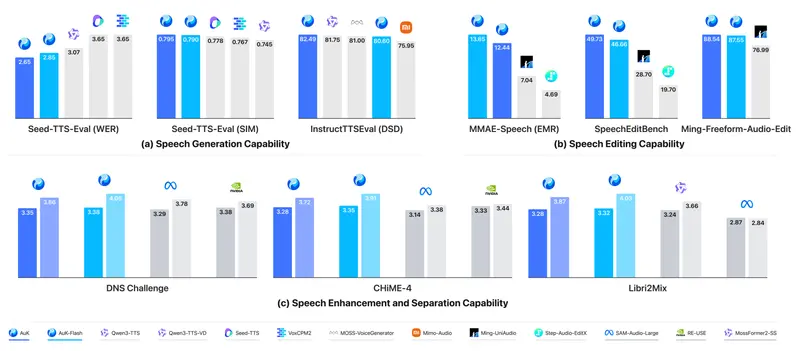
腾讯开源 AuK:单一大模型一站式搞定语音生成、音频编辑与人声分离在当前的 AI 音频领域,工具往往是割裂的:想配音用 TTS 模型,想降噪用增强模型,想分离人声又得换另一个软件。这种“工具箱”式的工作流不仅繁琐,还容易导致音色不统一、风格冲突。 腾讯最新开源的 A...语音模型# AuK# AuK-Flash# 腾讯1个月前1060
DiffSynth-Music:用“声音”指挥 AI 写歌,阿里与上交大推出插件式可控音乐生成框架现在的 AI 音乐工具大多依赖文字描述(如“悲伤的钢琴曲”),但文字很难精准传达节奏的快慢、旋律的起伏或乐器的具体编排。如果你想复刻某段鼓点,或者沿用一段哼唱的旋律,打字往往词不达意。 阿里巴巴通义实...语音模型# ACE-Step 1.5# DiffSynth-Music1个月前790
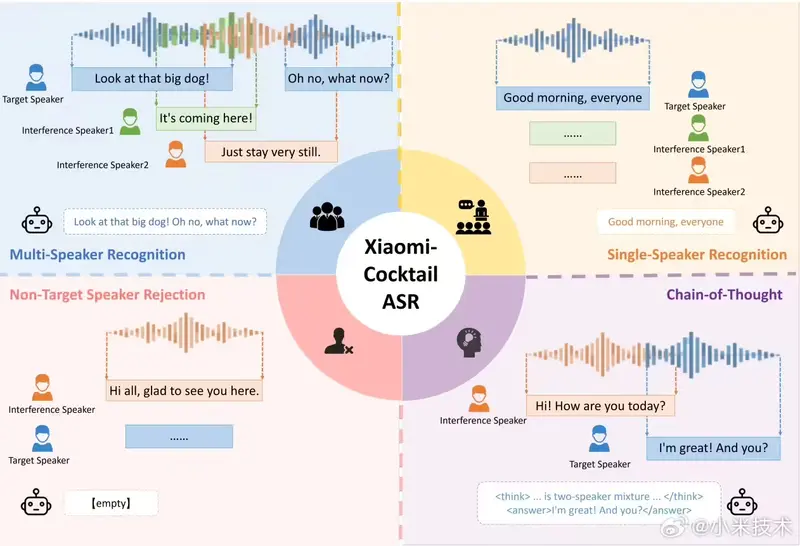
小米开源 Xiaomi-CocktailASR-1:攻克“鸡尾酒会”难题的工业级目标说话人语音识别大模型小米技术团队今日正式宣布开源 Xiaomi-CocktailASR-1,这是一款基于端到端 LLM 架构的工业级目标说话人语音识别(Target Speaker ASR)大模型。该模型旨在解决复杂的...语音模型# Xiaomi-CocktailASR-1# 小米# 语音识别大模型2个月前750
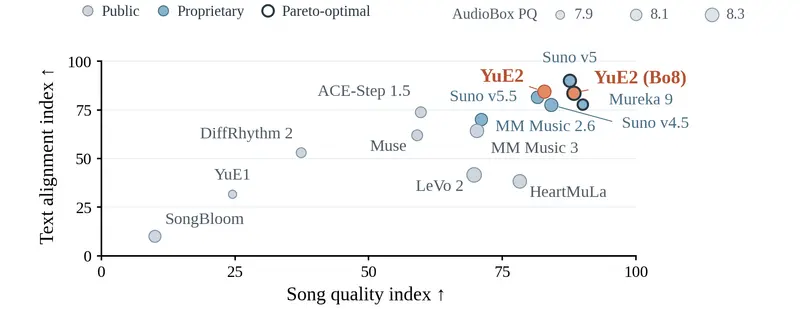
超越 Suno v5!港科大开源 YuE2 问世,AI 音乐终于支持「乐谱级可控创作」香港科技大学研究团队在2024年推出 YuE 后,近日发布了其升级版 YuE2。这是一款开源的音乐生成模型,不仅在质量上足以与 Suno v5 等顶尖专有模型媲美,更通过引入可编辑的符号乐谱(Symb...语音模型# YuE2# 香港科技大学2个月前1880