SD百科导航
  • 首页
  • 快讯
  • 早报
  • 模型
  • ComfyUI
  • 新技术
  • 百科
    • 教程
    • 硬件
    • 科普
  • 百科工具
    • 工具
  • 排行榜
    • 首页
    • 快讯
    • 早报
    • 模型
    • ComfyUI
    • 新技术
    • 百科
      • 教程
      • 硬件
      • 科普
    • 百科工具
      • 工具
    • 排行榜

    语音模型

    共 222 篇文章
    包括文本生成音频、音乐生成模型
    百科工具模型ComfyUIAI合集web UI提示词
    大语言模型多模态模型图像模型语音模型3D模型Flux衍生视频模型世界模型决策模型
    排序
    发布更新浏览点赞
    谷歌发布TTS模型 Gemini 3.8 Flash / Flash-Lite :动态语音创意工作室,支持自然语言创声与逐行表演指导

    谷歌发布TTS模型 Gemini 3.8 Flash / Flash-Lite :动态语音创意工作室,支持自然语言创声与逐行表演指导

    谷歌今天发布两款全新文本转语音模型 Gemini 3.8 Flash TTS 与 Gemini 3.8 Flash-Lite TTS,将语音生成从固定预设音色升级为动态声音创意工作台,赋能创作者、开发...
    早报语音模型# Gemini# Gemini 3.8 Flash TTS# Gemini 3.8 Flash-Lite TTS
    2个月前
    950
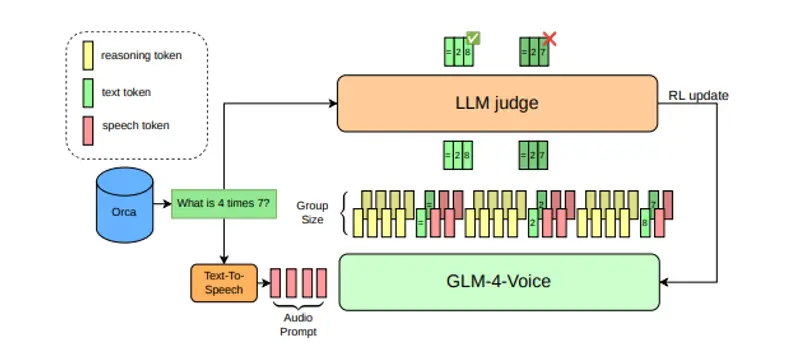
    Kyutai 发布 Voice of Reason:语音原生模型用强化学习攻克口头数学,GSM8K 准确率从 27.3% 升至 77.1%

    Kyutai 发布 Voice of Reason:语音原生模型用强化学习攻克口头数学,GSM8K 准确率从 27.3% 升至 77.1%

    Kyutai 开源 Voice of Reason 系列两个 9B 参数语音到语音模型,首次在语音原生架构中应用强化学习(RL)解决数学推理问题。模型基于 GLM-4-Voice-9B,经监督微调(S...
    语音模型# Kyutai# Voice of Reason
    2个月前
    860
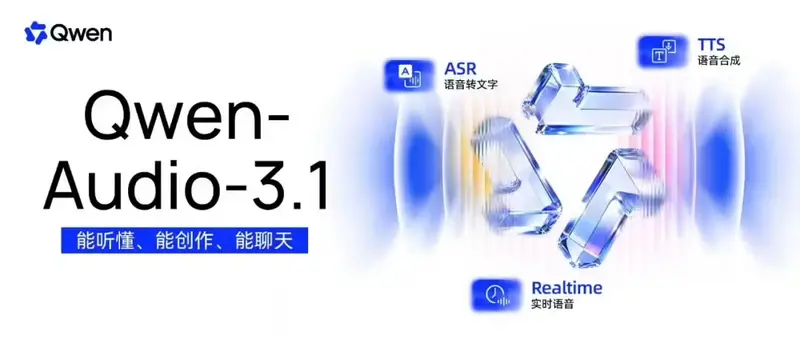
    阿里千问发布Qwen-Audio-3.1系列五大语音模型,打通音频理解、生成、实时交互全链路,并下调全线产品价格

    阿里千问发布Qwen-Audio-3.1系列五大语音模型,打通音频理解、生成、实时交互全链路,并下调全线产品价格

    阿里千问正式发布 Qwen-Audio-3.1 系列语音大模型,一次性推出五款全新模型,覆盖语音识别、语音合成、实时语音交互,新增音频创作模型Qwen-Audio-3.1-TTS-Next、音频理解模...
    早报语音模型# Qwen-Audio-3.1# 阿里千问
    2个月前
    1680
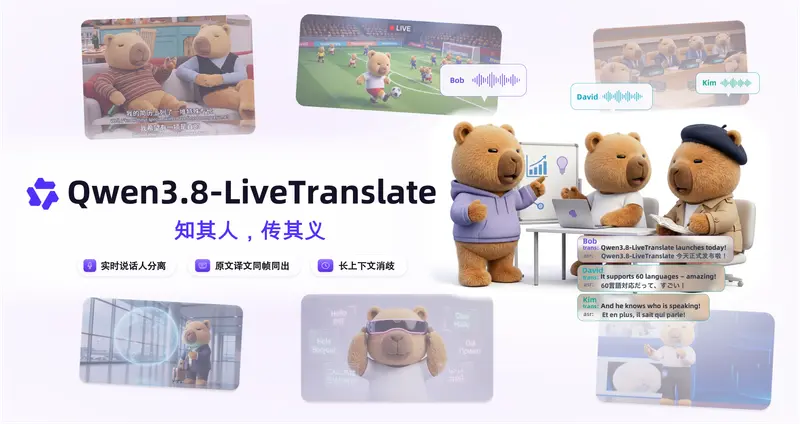
    阿里千问发布同声传译大模型 Qwen3.8-LiveTranslate:Interleave 架构重构同传,字均延迟低至 2.3 秒

    阿里千问发布同声传译大模型 Qwen3.8-LiveTranslate:Interleave 架构重构同传,字均延迟低至 2.3 秒

    阿里千问今日正式发布同声传译大模型 Qwen3.8-LiveTranslate。该模型采用 Interleave 架构对实时同传流程进行重构,在忠实度、流畅度与简洁度三项核心指标上实现全面提升,字均延...
    早报语音模型# Qwen3.8-LiveTranslate# 同声传译大模型# 阿里千问
    2个月前
    1360
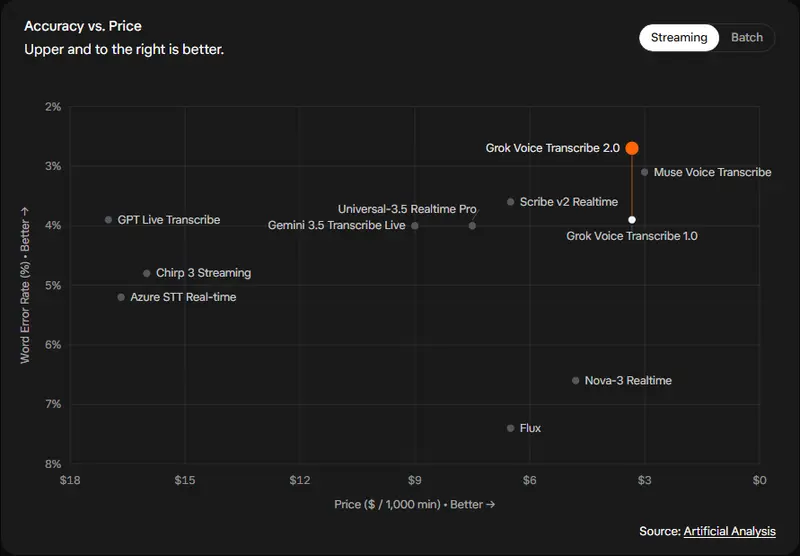
    SpaceXAI 推出 Grok Voice Transcribe 2.0:准确率翻倍,批处理转录 0.1 美元 / 小时

    SpaceXAI 推出 Grok Voice Transcribe 2.0:准确率翻倍,批处理转录 0.1 美元 / 小时

    SpaceXAI 正式推出语音转文本模型 Grok Voice Transcribe 2.0,模型 ID 为 grok-voice-transcribe-2.0。该版本基于 Grok Voice 音频...
    早报语音模型# Grok Voice Transcribe 2.0# SpaceXAI
    2个月前
    840
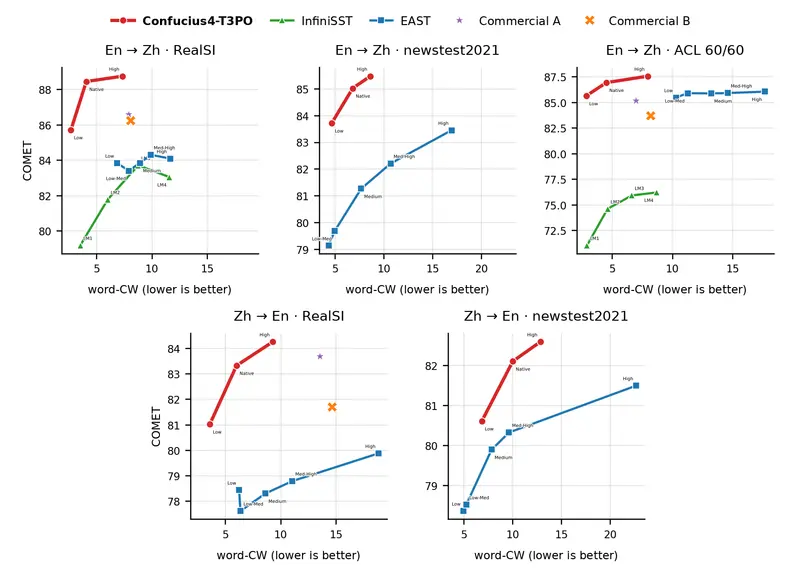
    兼顾翻译质量与延迟!网易有道发布Confucius4-T3PO:基于帕累托前沿策略优化的文本同声翻译模型

    兼顾翻译质量与延迟!网易有道发布Confucius4-T3PO:基于帕累托前沿策略优化的文本同声翻译模型

    网易有道 AI 团队正式发布了 Confucius4-T3PO,一款拥有 140 亿参数的文本到文本(Text-to-Text, T2T)同声机器翻译(SiMT)模型。该模型通过创新的帕累托前沿策略优...
    语音模型# Confucius4-T3PO# 网易有道
    2个月前
    980
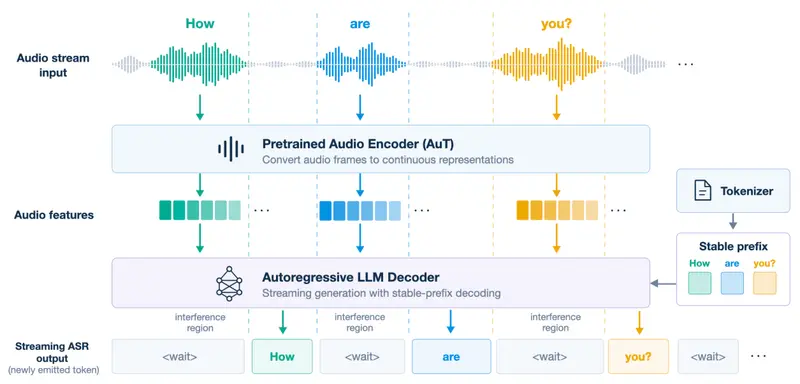
    网易有道发布 Confucius4-R2T2:低延迟高准确率实时语音识别模型,适配实时字幕与 AI 智能体

    网易有道发布 Confucius4-R2T2:低延迟高准确率实时语音识别模型,适配实时字幕与 AI 智能体

    网易有道正式发布了 Confucius4-R2T2,一款基于 Qwen3-ASR 架构的低延迟、高准确率真流式(True Streaming)自动语音识别模型。该模型的核心突破在于解决了传统流式 AS...
    语音模型# Confucius4-R2T2# 实时语音识别模型# 网易有道
    2个月前
    1500
    Nari Labs推出Nari Qwen3-TTS:基于 Qwen3-TTS 1.7B 定制的高性能 TTS 推理服务

    Nari Labs推出Nari Qwen3-TTS:基于 Qwen3-TTS 1.7B 定制的高性能 TTS 推理服务

    Nari AI 正式推出了 Nari Qwen3-TTS,一款基于阿里云 Qwen3-TTS 1.7B 模型的高性能文本转语音(TTS)服务。通过自研的专用推理引擎,Nari 在单张英伟达H100 S...
    早报语音模型# Nari Qwen3-TTS
    2个月前
    760
    谷歌发布 Gemini 3.8 Live 系列:支持后台思考,边聊天边调用工具不打断对话

    谷歌发布 Gemini 3.8 Live 系列:支持后台思考,边聊天边调用工具不打断对话

    谷歌正式推出了 Gemini 3.8 Live 和 Gemini 3.8 Live Extended Thinking 两款全新模型。这标志着语音交互 AI 从“简单的问答”迈向了“复杂的并行任务处理...
    早报语音模型# Gemini 3.8 Live# Gemini 3.8 Live Extended Thinking# 谷歌
    2个月前
    710
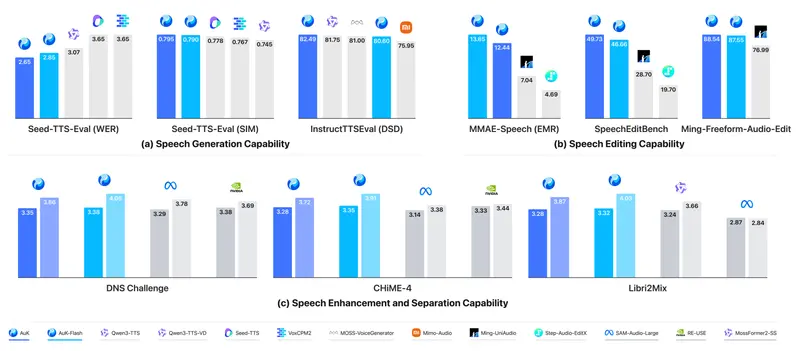
    腾讯开源 AuK:单一大模型一站式搞定语音生成、音频编辑与人声分离

    腾讯开源 AuK:单一大模型一站式搞定语音生成、音频编辑与人声分离

    在当前的 AI 音频领域,工具往往是割裂的:想配音用 TTS 模型,想降噪用增强模型,想分离人声又得换另一个软件。这种“工具箱”式的工作流不仅繁琐,还容易导致音色不统一、风格冲突。 腾讯最新开源的 A...
    语音模型# AuK# AuK-Flash# 腾讯
    2个月前
    1410
    DiffSynth-Music:用“声音”指挥 AI 写歌,阿里与上交大推出插件式可控音乐生成框架

    DiffSynth-Music:用“声音”指挥 AI 写歌,阿里与上交大推出插件式可控音乐生成框架

    现在的 AI 音乐工具大多依赖文字描述(如“悲伤的钢琴曲”),但文字很难精准传达节奏的快慢、旋律的起伏或乐器的具体编排。如果你想复刻某段鼓点,或者沿用一段哼唱的旋律,打字往往词不达意。 阿里巴巴通义实...
    语音模型# ACE-Step 1.5# DiffSynth-Music
    2个月前
    1060
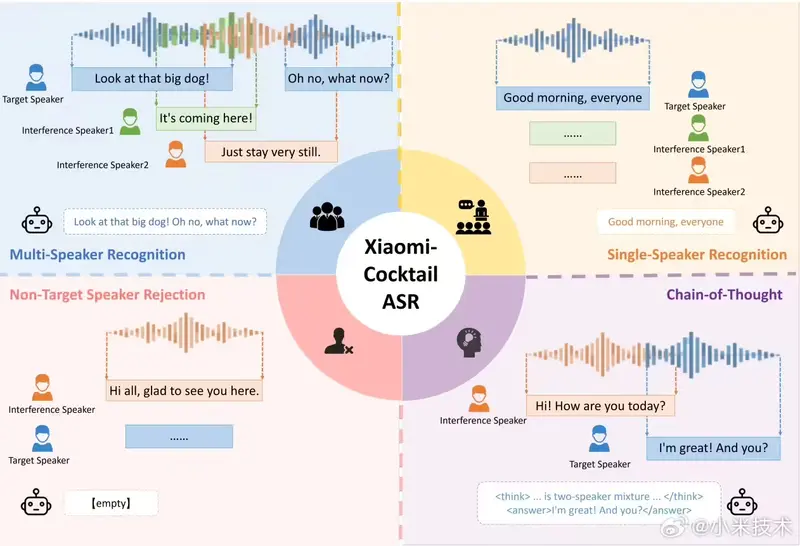
    小米开源 Xiaomi-CocktailASR-1:攻克“鸡尾酒会”难题的工业级目标说话人语音识别大模型

    小米开源 Xiaomi-CocktailASR-1:攻克“鸡尾酒会”难题的工业级目标说话人语音识别大模型

    小米技术团队今日正式宣布开源 Xiaomi-CocktailASR-1,这是一款基于端到端 LLM 架构的工业级目标说话人语音识别(Target Speaker ASR)大模型。该模型旨在解决复杂的...
    语音模型# Xiaomi-CocktailASR-1# 小米# 语音识别大模型
    2个月前
    1000
    加载更多

    网址

    日榜周榜月榜
    LoginFlip

    LoginFlip

    LoginFlip 是一款专为 Chrome 浏览器设计的轻量级扩展,解决多账号管理痛点。它通过保存和恢复网站的登录状态(Cookie + localStorage),让你在不同身份(工作号、测试号、个人号等)之间实现秒级切换,彻底告别反复输入密码和退出登录的繁琐流程。
    Medeo

    Medeo

    Medeo 允许用户通过简单的文本描述生成视频,无需复杂的编辑界面。它提供超过数百万的高清视频素材,AI 自动匹配场景素材,并优化脚本、添加配音和背景音乐,完美处理过渡和节奏。此外,它能将网页或文章转为专业视频,支持创建动画故事,并提供个人和社区资产库,方便 A/B 测试和多语言配音。
    RAPTOR

    RAPTOR

    RAPTOR 是一个基于 Claude Code 的自主攻防安全研究框架。它通过智能体工作流与自动化赋能安全研究。
    RSS-AIGC

    RSS-AIGC

    RSS-AIGC是一个非常简易的现代化的 RSS 订阅与 AI 内容聚合平台,专为内容创作者、研究人员和知识工作者设计。系统集成了 AI 报告生成、飞书机器人推送、多源内容聚合等高级功能,帮助用户高效地获取、管理和分析来自 Hacker News、GitHub、ArXiv 等专业平台的内容
    FeedCraft

    FeedCraft

    FeedCraft 是一个简单、强大的 RSS 源处理工具. 他可以作为一个中间件处理你的RSS源, 你可以用它来提取正文、智能翻译、通过AI生成文章摘要、通过自然语言筛选文章等. 它内置了可视化 RSS 生成器 (HTML/Curl/Search to RSS),支持将网页、API (Curl) 或搜索结果转换为 RSS 订阅源。
    ChromeClaw 

    ChromeClaw 

    ChromeClaw是一个轻量级的、受 OpenClaw 启发的 AI 智能体,完全在 Chrome 浏览器沙箱中运行——支持多提供商大语言模型、消息渠道、语音、记忆、智能体和浏览器自动化。
    查看完整榜单
    SD百科导航
    SD百科导航是专注于AI创作领域的专业导航网站。我们全面涵盖Stable Diffusion、Flux、AI绘画、AI视频、AI音乐以及大语言模型等前沿内容。

    关于我们友链申请广告合作

    扫码关注微信公众号SD百科导航
    扫码关注微信公众号
    Copyright © 2026 SD百科导航 皖ICP备18025588号-5  皖公网安备34040002000401 
    网址
    网址文章软件模型
      ↵ENTER↓↑NAV

      网址

      日榜周榜月榜
      LoginFlip

      LoginFlip

      LoginFlip 是一款专为 Chrome 浏览器设计的轻量级扩展,解决多账号管理痛点。它通过保存和恢复网站的登录状态(Cookie + localStorage),让你在不同身份(工作号、测试号、个人号等)之间实现秒级切换,彻底告别反复输入密码和退出登录的繁琐流程。
      Medeo

      Medeo

      Medeo 允许用户通过简单的文本描述生成视频,无需复杂的编辑界面。它提供超过数百万的高清视频素材,AI 自动匹配场景素材,并优化脚本、添加配音和背景音乐,完美处理过渡和节奏。此外,它能将网页或文章转为专业视频,支持创建动画故事,并提供个人和社区资产库,方便 A/B 测试和多语言配音。
      RAPTOR

      RAPTOR

      RAPTOR 是一个基于 Claude Code 的自主攻防安全研究框架。它通过智能体工作流与自动化赋能安全研究。
      RSS-AIGC

      RSS-AIGC

      RSS-AIGC是一个非常简易的现代化的 RSS 订阅与 AI 内容聚合平台,专为内容创作者、研究人员和知识工作者设计。系统集成了 AI 报告生成、飞书机器人推送、多源内容聚合等高级功能,帮助用户高效地获取、管理和分析来自 Hacker News、GitHub、ArXiv 等专业平台的内容
      FeedCraft

      FeedCraft

      FeedCraft 是一个简单、强大的 RSS 源处理工具. 他可以作为一个中间件处理你的RSS源, 你可以用它来提取正文、智能翻译、通过AI生成文章摘要、通过自然语言筛选文章等. 它内置了可视化 RSS 生成器 (HTML/Curl/Search to RSS),支持将网页、API (Curl) 或搜索结果转换为 RSS 订阅源。
      ChromeClaw 

      ChromeClaw 

      ChromeClaw是一个轻量级的、受 OpenClaw 启发的 AI 智能体,完全在 Chrome 浏览器沙箱中运行——支持多提供商大语言模型、消息渠道、语音、记忆、智能体和浏览器自动化。
      查看完整榜单