B站 Index 项目组正式推出 Qwen3.5 构建的Index-Translate 系列多语言翻译模型家族,以主力文本翻译模型为核心,延伸出语音翻译、配音长度控制、长文档翻译三大衍生模型,构建覆盖“文字→声音”全链路的翻译能力。
- 项目主页:https://index-translate.bilibili.com
- GitHub:https://github.com/bilibili/Index-Translate
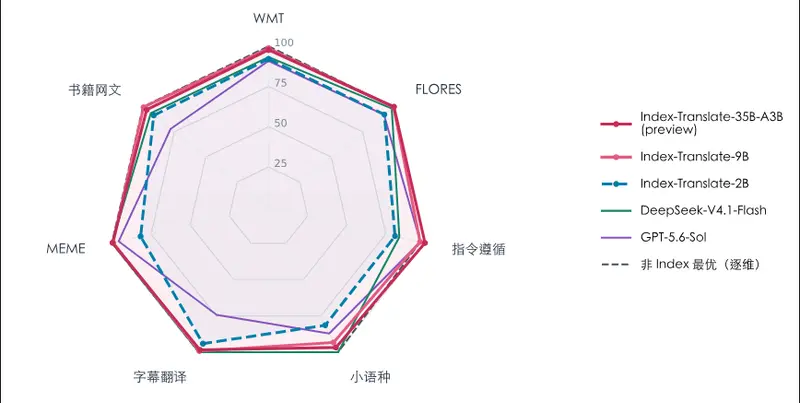
主力模型 Index-Translate(2B/9B/35A3B)支持 148 种语言,在通用翻译、指令遵循、梗翻译、小语种翻译等维度达到同级别 SOTA;衍生模型 Index-Echo 实现端到端语音到语音翻译并保留原说话人音色,Index-Homura 支持音节级译文长度控制适配配音节奏,Index-Native Long(Nailong)可一次生成整本小说完整译文。所有模型均强调真实场景泛化能力,而非仅追求基准分数。
模型下载
下表提供 2B、9B 与 35B-A3B(preview) 文本模型权重。
| 模型 | 任务与发布包覆盖 | Hugging Face | ModelScope |
|---|---|---|---|
| Index-Translate | 150 种语言的文本翻译与指令遵循 | 2B · 9B · 35B-A3B (preview) | 2B · 9B · 35B-A3B (preview) |
| Index-Echo S2TT | 语音转字幕;发布脚本支持中→英/日/西 | 2B · 9B | 2B · 9B |
| Index-Echo S2ST | 语音配音;中→英/西/日,英→中/西/日 | 2B · 9B | 2B · 9B |
| Index-Homura | 按指定目标音节数翻译 | 2B · 9B | 2B · 9B |
| Index-NativeLong | 长文档;固定模板支持中↔英、中↔日 | 2B · 9B | 2B · 9B |
命名说明: Index-NativeLong 的实际模型仓库 ID 为 IndexTeam/Index-Nailong-2B 和 IndexTeam/Index-Nailong-9B,运行命令请使用这两个 ID。语音与长文档发布包的语言覆盖见上表,文本模型的 150 种语言覆盖不等同于每个专门模型的接口覆盖。
模型家族全景
| 模型 | 规模 | 核心能力 | 支持语言 |
|---|---|---|---|
| Index-Translate | 2B / 9B / 35A3B | 148 语种文本翻译 + 指令遵循 + 梗翻译 | 148 种 |
| Index-Echo | 2B / 9B | S2TT(语音→译文文本)+ S2ST(语音→语音配音,保留音色) | 中英 → 6 种 |
| Index-Homura | 9B | 按目标音节比控制译文长度,适配配音时间窗 | 中 → 4 种 |
| Index-Native Long | 9B | 超长输入输出,一次生成整本小说连贯译文 | 中英互译 |
Index-Translate:译出意思,也听懂要求
三阶段训练范式
- Mid-train:WSD scheduler + 多语种/平行/中转语料混合,退火阶段提高中转语料比例,建立跨语言语义对应
- Post-train:分别训练通用翻译、指令遵循、梗翻译三个专家模型(SFT + RaR RL / RLVR)
- Model-merge:线性插值 / MOPD / Mix-RL 整合多版本能力至统一模型
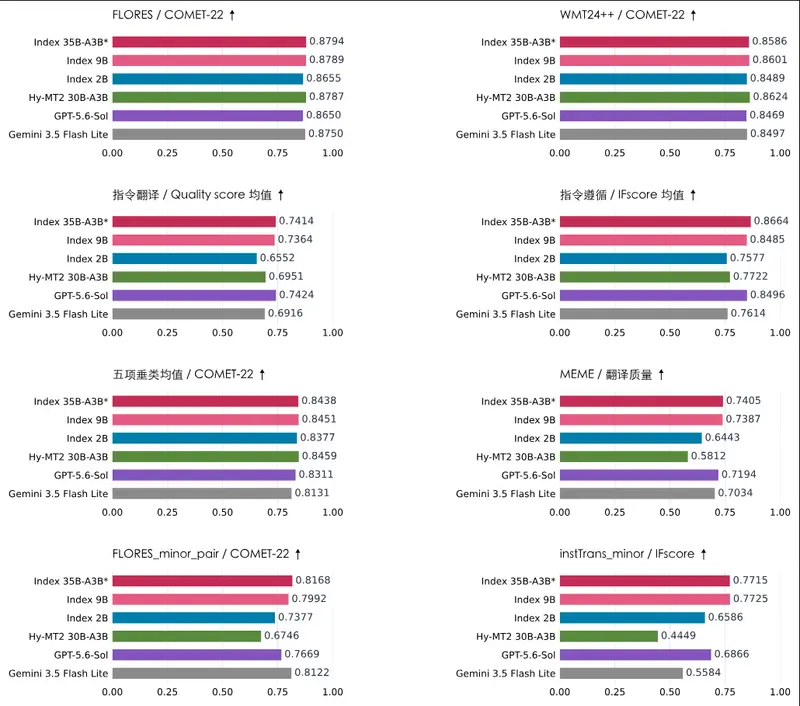
七维评测表现(后训练主表)
| 指标 | Index-Translate-35B | 排名 |
|---|---|---|
| FLORES-200 | 0.8794 | 🥇 全场第一 |
| instTrans IFscore | 0.8336 | 🥇 全场第一 |
| MEME 梗翻译 | 0.7405 | 🥇 全场第一 |
| 小语种 FLORES_minor_pair | 0.8168 | Top 2 |
| WMT24++ | — | Top 2 |
| 字幕翻译 MuST-Cinema (9B) | 0.8979 | 🥇 顶尖 |
| IFMTBench IFscore (9B) | 0.8760 | 🥇 顶尖 |
💡 小语种专项:FLORES_minor_pair 覆盖 62 语种 1,040 方向;instTrans_minor 含 2,793 条指令任务。9B 在 instTrans_minor 取得最高 IFscore(0.7725)与最低 off-target(3.47%)。
Index-Echo:端到端语音翻译,保留原声音色
双链路架构
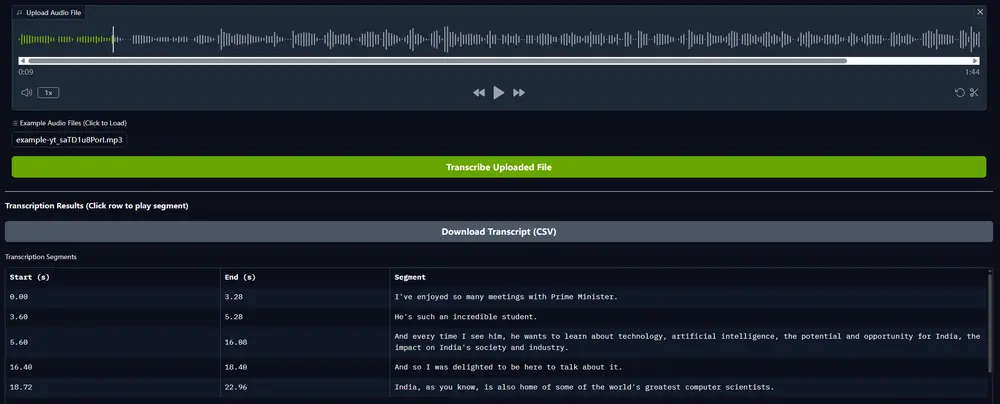
- S2TT:AuT encoder + Index-Translate 解码器,输出带时间戳译文文本,支持字幕同步
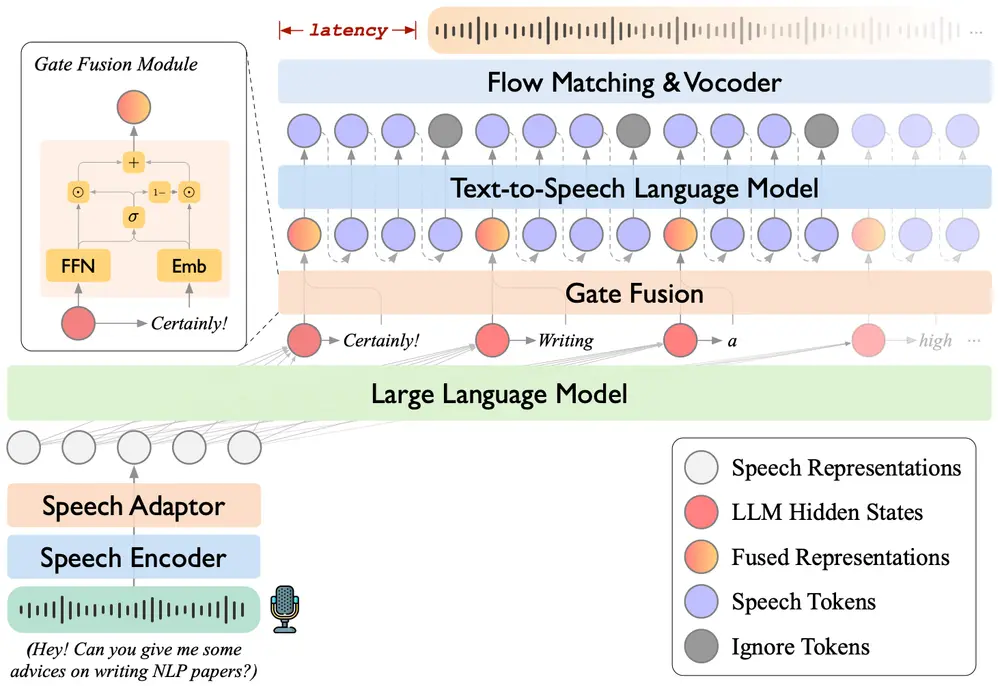
- S2ST:完全端到端,移除 CosyVoice3 tokenizer,将 LLM last hidden 表征与 CosyVoice3 语义层对齐;两阶段训练(冻结主干蒸馏映射器 → DiffRO 全链路微调);源音频提取 CampPlus 音色嵌入注入生成链路
S2ST 评测亮点
- 全方向平均内容错误率 优于级联 Pipeline(9B: 0.0551 vs 0.0596)
- 英→中 2B 端到端相对 Pipeline 错误率 降低近 40%
- 音色保真度全面持平(~0.72),端到端映射不损音色
- S2TT 时间偏差最低 0.395(2B),MT judge 0.857(9B,对比模型第一)
Index-Homura:音节可控翻译,适配配音节奏
- HOMURA 方法:GRPO 强化学习,动态音节比奖励 + 翻译质量奖励联合优化
- Sandglass 评测:9B 综合分 0.8660(20 个模型总榜第一);81.92% 输出音节偏差 ≤10%;控制斜率 0.968(接近理想值 1)
- 覆盖 300 句真实字幕、4 目标语种、3 档长度
Index-Native Long:整本小说一次译完
- 解决痛点:专用翻译模型在长文档上性能骤降(Hy-MT2-7B 在 GuoFeng 64K 降至 0.0001)
- 64K tokens 档位:GuoFeng 0.7382、BWB 0.7440、跨领域书籍英→中 0.8514,五档均值均为全场最高
- 检查输出完整性、人物称谓一致性、前后文衔接
适用场景
- 多语言内容本地化(视频字幕、配音、网文出海)
- 需要指令控制的翻译(保留称谓、口语化、格式要求)
- 网络热梗/文化表达翻译
- 小语种翻译(62 语种对)
- 视频配音制作(长度控制 + 音色保留)
- 长篇文学/技术文档完整翻译
© 版权声明
文章版权归作者所有,未经允许请勿转载。