微软扩充自研MAI语音模型产品线,一次性推出三款面向低延迟实时对话智能体的全新模型:MAI-Transcribe-2-Streaming、MAI-Voice-2.1、MAI-Voice-2.1-Flash,三者可以协同工作,构成完整语音交互链路。
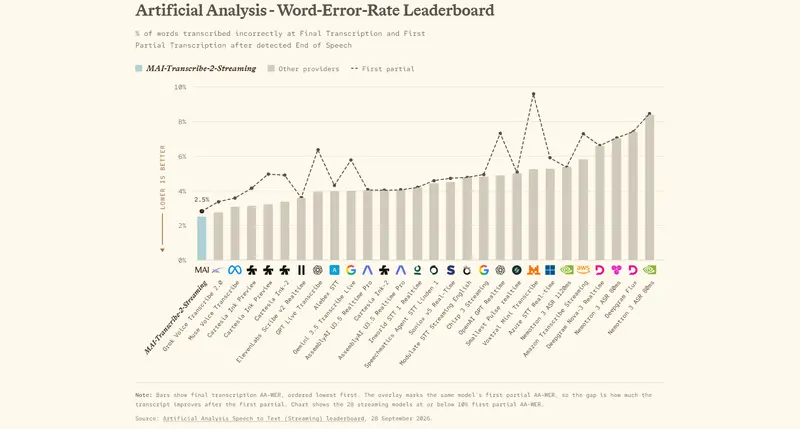
MAI-Transcribe-2-Streaming|流式实时转录
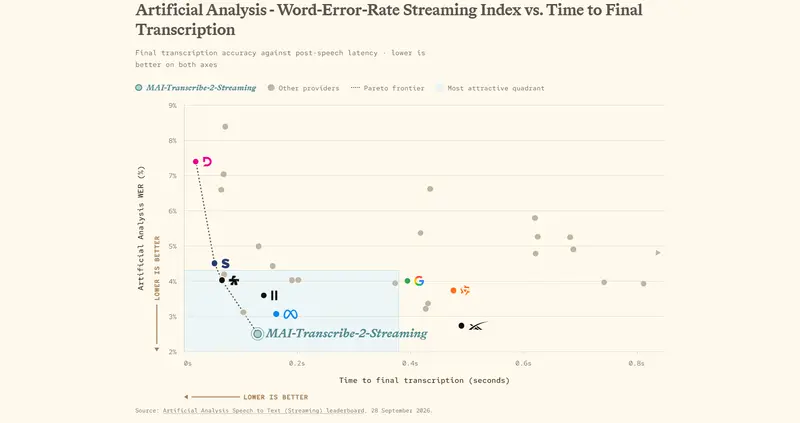
不同于仅处理离线录音的MAI-Transcribe-2,Streaming版本专为实时场景打造。音频流入后仅需100多毫秒就输出初步转录文本,后续随上下文持续修正,产出稳定终版文字。
- 支持60种语言,附带连续自动语种检测;微软宣称该模型在Artificial Analysis的部分转录、最终转录两项准确率榜单排名第一。
- 内部测试显示,字幕听写场景下,文字出现速度相比竞品快两倍。
- 限时引入价:每小时音频0.54美元(非流式MAI-Transcribe-2促销价0.1美元/小时)。
MAI-Voice-2.1|多语言TTS主模型
MAI-Voice-2.1是新一代多语言文本转语音模型,覆盖23种语言、26个地区。
亮点:同一个音色可以跨语言切换,切换语种时保留说话人特征,并且自动适配对应地区原生口音,不会带着固定口音跨语种朗读。
定价:22美元 / 百万字符。
MAI-Voice-2.1-Flash|高速低成本变体
面向高并发、强低延迟需求场景,和2.1基础版语言能力完全一致:
- 生成45秒音频,端到端延迟约150ms,推理速度提升55%,价格比同类模型低约60%。
- 定价:15美元 / 百万字符。
两款语音模型均支持几秒参考音频完成音色克隆,内置权限护栏,防范滥用风险。
部署渠道与适用场景
三款模型可通过Microsoft Foundry、MAI Playground、Vercel调用;MAI-Voice系列同时上架OpenRouter,LiveKit支持即将上线,也可接入Azure Voice Live。配套演示Demo「Chatter」放在MAI Playground,直观展示整套实时语音智能体的联动效果。
典型落地场景:客服语音智能体、多语言对话助手、语言教学、模拟演练与多媒体旁白。
© 版权声明
文章版权归作者所有,未经允许请勿转载。