SD百科导航
  • 首页
  • 快讯
  • 早报
  • 模型
  • ComfyUI
  • 新技术
  • 百科
    • 教程
    • 硬件
    • 科普
  • 百科工具
    • 工具
  • 排行榜
    • 首页
    • 快讯
    • 早报
    • 模型
    • ComfyUI
    • 新技术
    • 百科
      • 教程
      • 硬件
      • 科普
    • 百科工具
      • 工具
    • 排行榜

    TTS

    共 20 篇文章
    排序
    发布更新浏览点赞
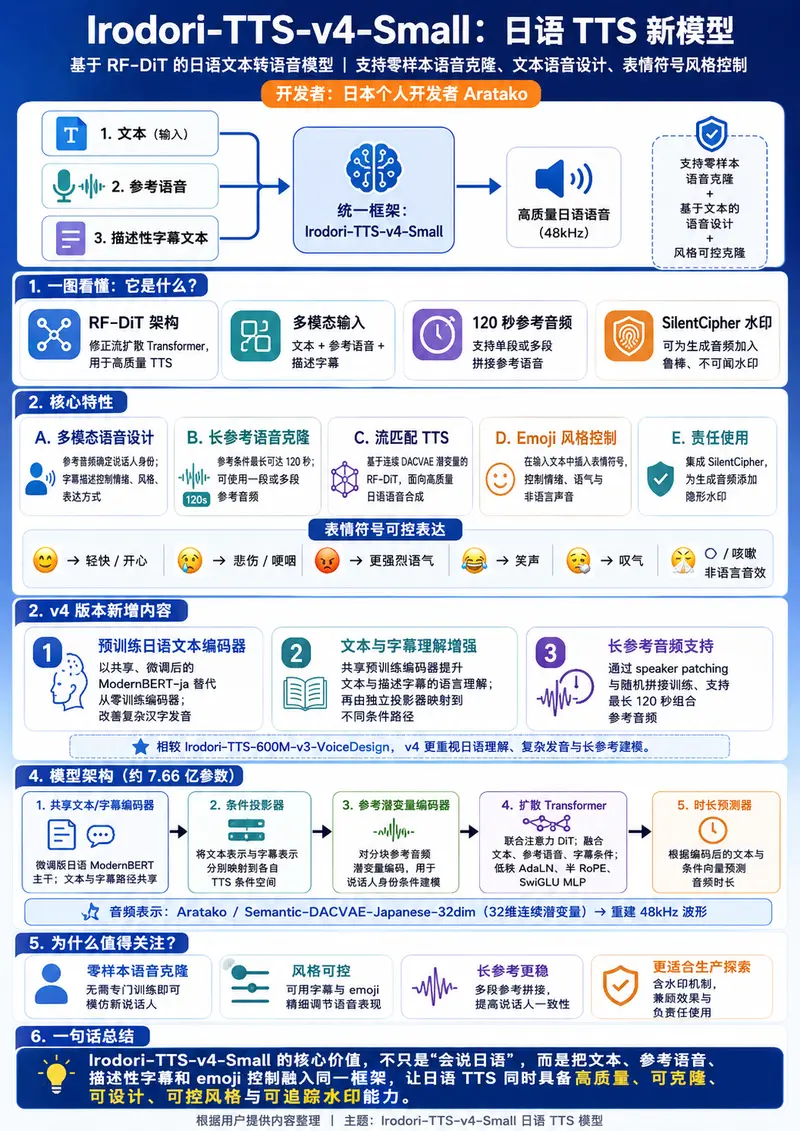
    Irodori-TTS-v4-Small:用 Emoji 控制语气的日语零样本语音克隆模型

    Irodori-TTS-v4-Small:用 Emoji 控制语气的日语零样本语音克隆模型

    日本个人开发者 Aratako 最新推出了 Irodori-TTS-v4-Small,这是一个基于修正流扩散 Transformer(RF-DiT)架构的日语文本转语音(TTS)模型。 GitHub...
    语音模型# Irodori-TTS-v4-Small# TTS# 日语
    3个月前
    1330
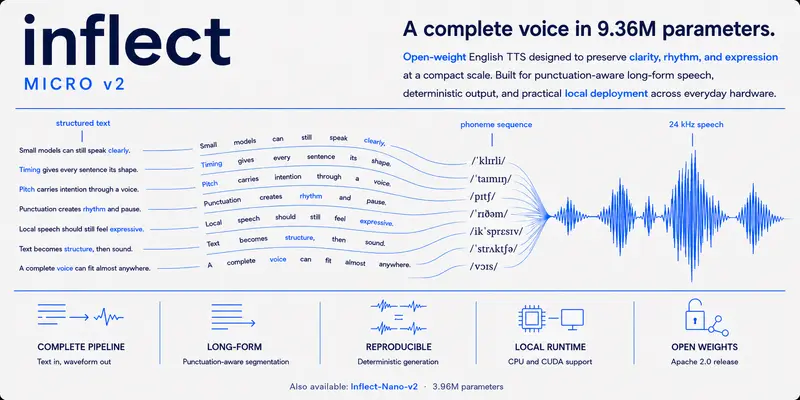
    Inflect v2:权重仅 16MB 的本地高质量英文 TTS 模型

    Inflect v2:权重仅 16MB 的本地高质量英文 TTS 模型

    在文本转语音(TTS)领域,我们通常需要在“音质”和“体积”之间做妥协。高质量的模型往往动辄几百 MB 甚至 GB,且依赖复杂的外部声码器或云端推理。 GitHub:https://github.co...
    语音模型# Inflect v2# TTS
    3个月前
    1020
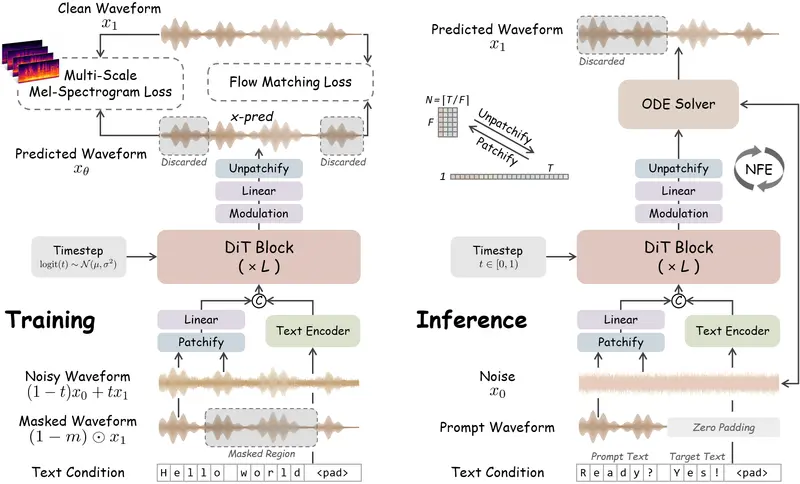
    WavTTS:首个高性能零样本原生波形 TTS,基于流匹配与 DiT 直接生成原始音频,摒弃梅尔频谱与声码器,中英双语性能比肩 SOTA

    WavTTS:首个高性能零样本原生波形 TTS,基于流匹配与 DiT 直接生成原始音频,摒弃梅尔频谱与声码器,中英双语性能比肩 SOTA

    上海交大、上海创新研究院与字节跳动 Seed 团队联合发布了 WavTTS,这是首个在性能上显著缩小与主流隐空间/梅尔谱模型差距的端到端零样本原始波形 TTS 框架。WavTTS 基于流匹配(Flow...
    语音模型# TTS# WavTTS
    5个月前
    2140
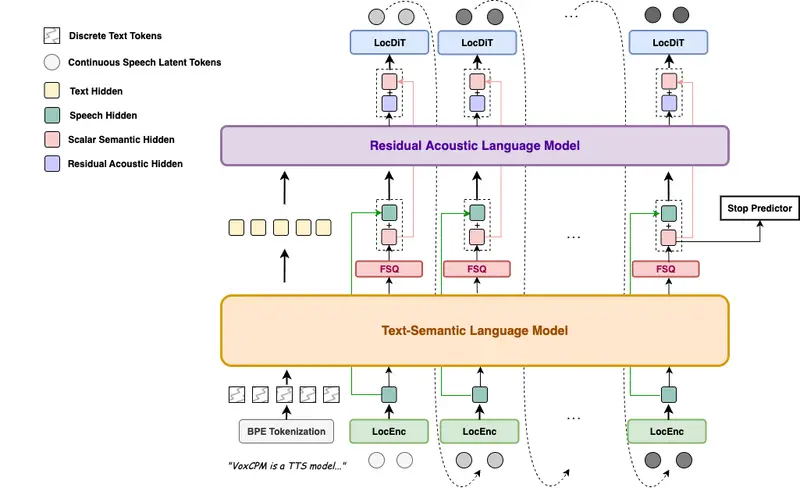
    面壁智能发布 VoxCPM2:20亿参数、无离散 Tokenizer 的开源语音合成新标杆

    面壁智能发布 VoxCPM2:20亿参数、无离散 Tokenizer 的开源语音合成新标杆

    面壁智能 (ModelBest) 正式发布了 VoxCPM2,一款基于连续表征(Continuous Representation)的多语言语音合成模型。作为 VoxCPM 系列的最新迭代,VoxCP...
    语音模型# TTS# VoxCPM2# 面壁智能
    7个月前
    5100
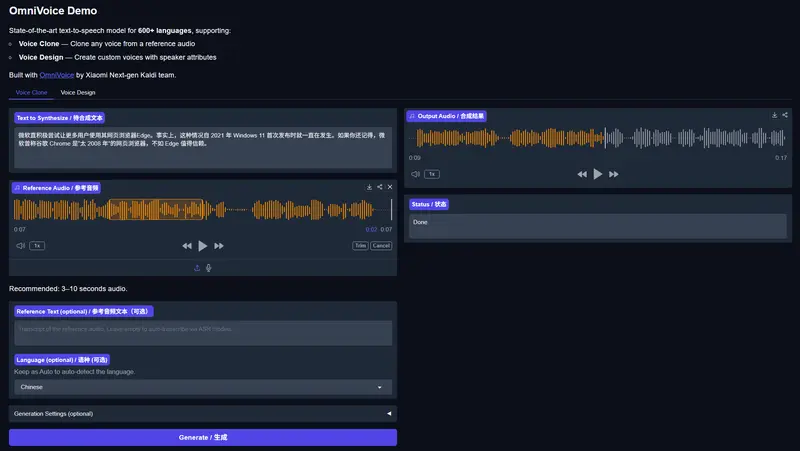
    OmniVoice:小米 K2-FSA 团队开源 600+ 语言零样本 TTS,一句话复刻全球声音

    OmniVoice:小米 K2-FSA 团队开源 600+ 语言零样本 TTS,一句话复刻全球声音

    OmniVoice 是由 小米 K2-Fsa 团队 最新推出的文本转语音(TTS)模型。它打破了传统 TTS 的语言壁垒,支持超过 600 种语言(包括大量低资源语言和方言),并凭借创新的 扩散语言模...
    语音模型# OmniVoice# TTS
    7个月前
    5450
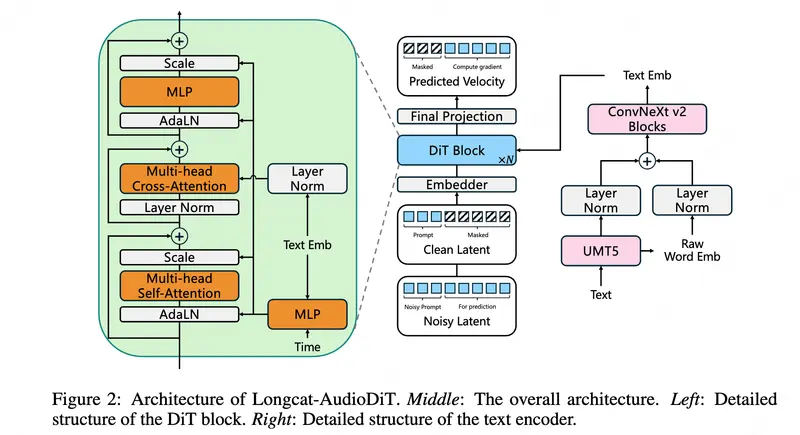
    LongCat-AudioDiT:美团开源的端到端语音合成模型,直接在波形潜空间生成高保真语音

    LongCat-AudioDiT:美团开源的端到端语音合成模型,直接在波形潜空间生成高保真语音

    美团 LongCat 团队推出了 LongCat-AudioDiT,这是一种基于扩散模型的最新文本转语音(TTS)系统。该模型的核心创新在于摒弃了传统的中间声学特征(如梅尔频谱图),直接在波形潜空间...
    语音模型# LongCat-AudioDiT# TTS# 美团
    7个月前
    2900
    Hume AI 开源 TTS 模型 TADA:文本 – 声学一对一同步,推理速度提升 5 倍且零幻觉

    Hume AI 开源 TTS 模型 TADA:文本 – 声学一对一同步,推理速度提升 5 倍且零幻觉

    在基于大语言模型(LLM)的文本转语音(TTS)领域,开发者长期面临一个“不可能三角”:速度、质量与可靠性难以兼得。传统的 LLM-TTS 系统往往因为文本与音频表示的不匹配,导致推理缓慢、内存消耗巨...
    语音模型# Hume AI# TADA# TTS
    8个月前
    3530
    别再盲目搜索了!2026语音克隆指南,本地开源模型与在线平台实测盘点

    别再盲目搜索了!2026语音克隆指南,本地开源模型与在线平台实测盘点

    “有没有真正免费且好用的语音克隆工具?” 这是Reddit网友Novel_Leading_7541在技术社区每周都会看到的提问。现实情况往往令人沮丧:大多数所谓的“免费工具”要么限制重重,要么音质堪忧...
    AI合集# TTS# 语音克隆
    8个月前
    6140
    阿里开源Marco-Voice:说话人-情感独立调控,语音克隆相似度0.8275碾压同类

    阿里开源Marco-Voice:说话人-情感独立调控,语音克隆相似度0.8275碾压同类

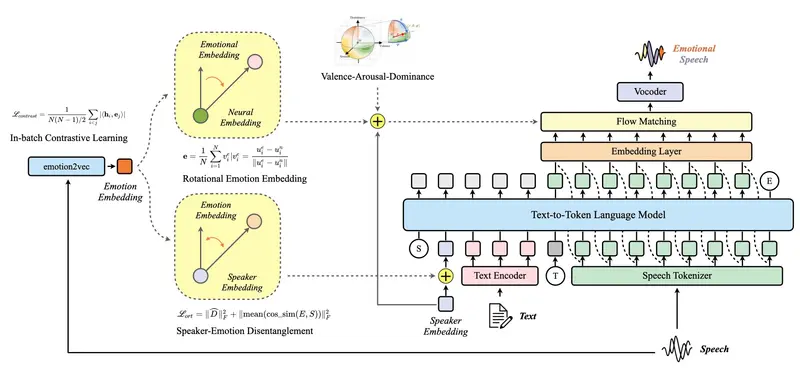
    阿里巴巴国际数字商务团队推出的开源语音合成框架 Marco-Voice,以“说话人-情感解耦”为核心创新,整合语音克隆、情感可控合成、跨语言生成三大功能,构建了统一且高效的文本转语音系统。该框架通过批...
    语音模型# Marco-Voice# TTS
    11个月前
    3100
    ComfyUI-VoxCPM:集成 VoxCPM 的上下文感知语音合成节点

    ComfyUI-VoxCPM:集成 VoxCPM 的上下文感知语音合成节点

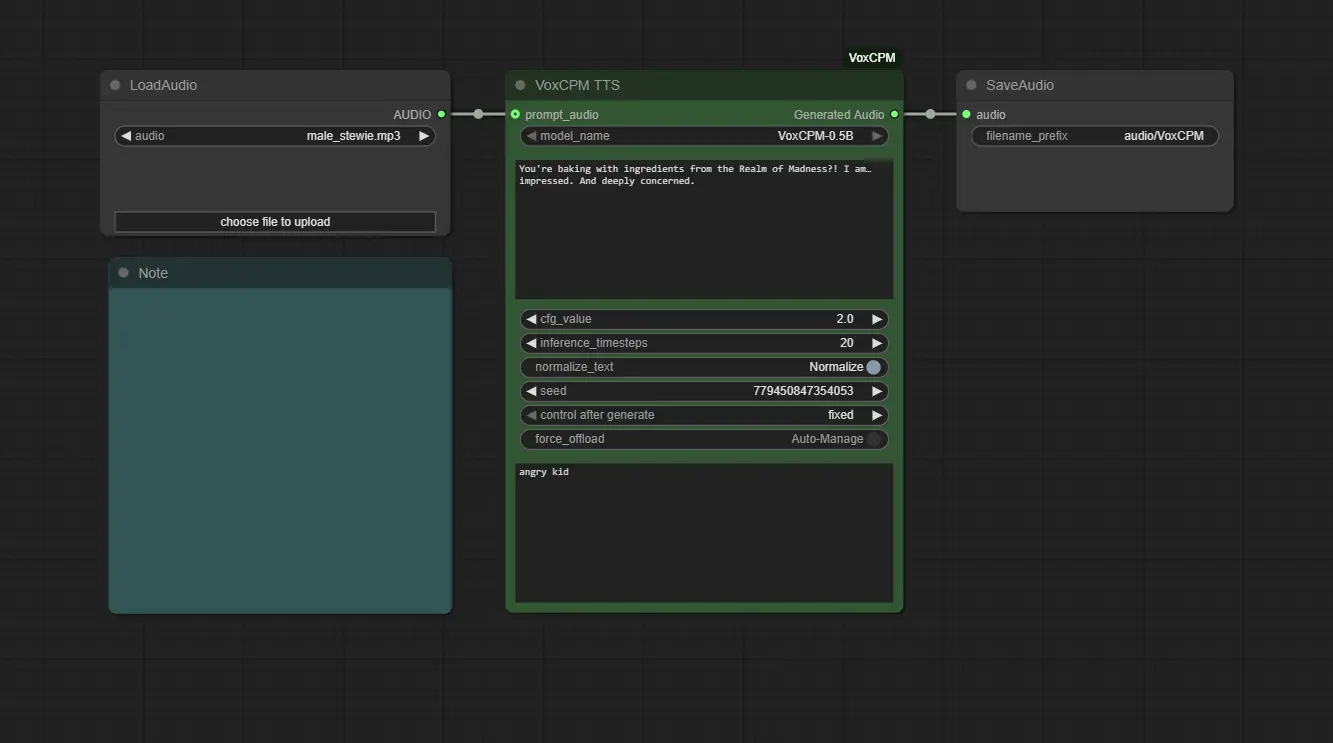
    ComfyUI-VoxCPM 是一个为 ComfyUI 设计的自定义节点,集成了 VoxCPM —— 一种基于 MiniCPM-4 架构的新型无分词器(tokenizer-free)文本到语音(TTS...
    插件# ComfyUI-VoxCPM# TTS# VoxCPM
    11个月前
    7790
    面壁智能发布VoxCPM:无需分词器的TTS,用于上下文感知的语音生成和真实感声音克隆

    面壁智能发布VoxCPM:无需分词器的TTS,用于上下文感知的语音生成和真实感声音克隆

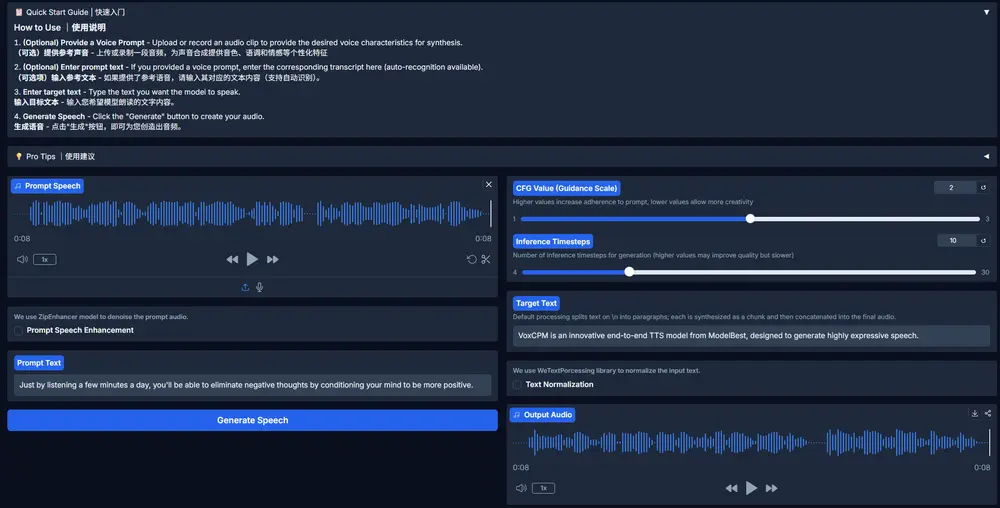
    在语音合成领域,大多数主流 TTS(Text-to-Speech)模型依赖于将语音信号离散化为“音素”或“语音标记”——这一过程虽然便于建模,但也带来了固有局限: 声音细节丢失、韵律不自然、跨说话人迁...
    语音模型# TTS# VoxCPM# 面壁智能
    1年前
    8100
    VibeVoice-ComfyUI :将微软高质量TTS模型VibeVoice深度集成至 ComfyUI

    VibeVoice-ComfyUI :将微软高质量TTS模型VibeVoice深度集成至 ComfyUI

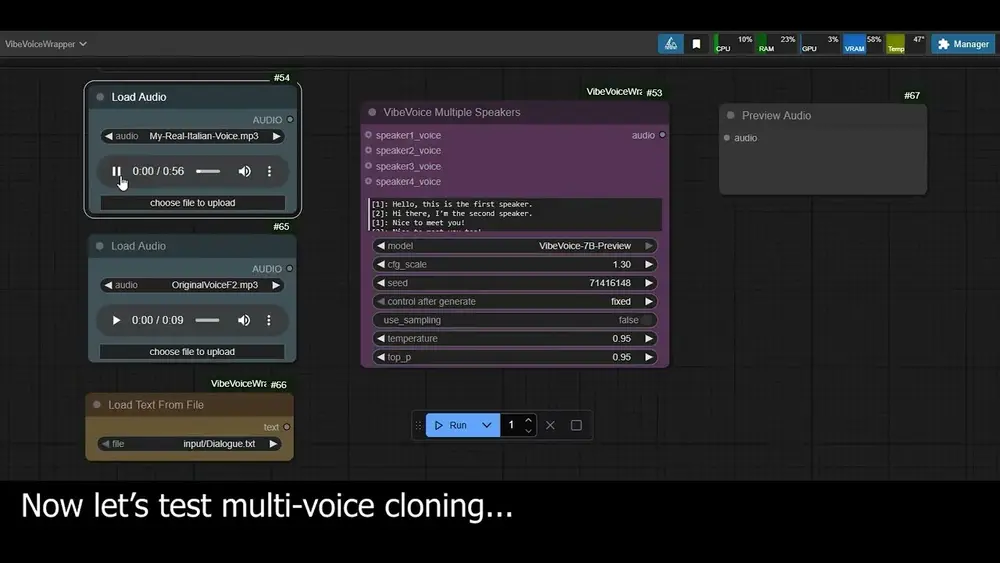
    VibeVoice-ComfyUI 是一款文本转语音(TTS)插件,将微软最新的 VibeVoice 语音合成模型深度集成至 ComfyUI 工作流中。 它不仅支持自然流畅的单人语音生成,更实现了 多...
    插件# TTS# VibeVoice# 微软
    1年前
    8760
    加载更多

    网址

    日榜周榜月榜
    LoginFlip

    LoginFlip

    LoginFlip 是一款专为 Chrome 浏览器设计的轻量级扩展,解决多账号管理痛点。它通过保存和恢复网站的登录状态(Cookie + localStorage),让你在不同身份(工作号、测试号、个人号等)之间实现秒级切换,彻底告别反复输入密码和退出登录的繁琐流程。
    BlitzBrowser

    BlitzBrowser

    BlitzBrowser是一款开源无头浏览器管理项目,核心价值在于将各类浏览器封装进Docker容器中,实现便捷的部署、运行与管理,支持本地或云端部署,同时兼容Chrome DevTools协议(CDP)。
    海绵音乐

    海绵音乐

    海绵音乐是由字节跳动最新推出的免费AI音乐创作和分享平台。它旨在利用AI技术生成个性化音乐,让用户能够轻松创作出符合自己风格的音乐作品。
    SentrySearch

    SentrySearch

    SentrySearch 将你的 mp4 视频分割成重叠的片段,使用 Google 的 Gemini Embedding API 或本地的 Qwen3-VL 模型将每个片段嵌入为视频,并将向量存储在本地 ChromaDB 数据库中。当你搜索时,你的文本查询被嵌入到同一向量空间中,并与存储的视频嵌入进行匹配。最佳匹配会自动从原始文件中裁剪出来,并保存为一个片段。
    Adobe Firefly Video

    Adobe Firefly Video

    由 Firefly 视频模型支持,创意专业人士可以从文本提示或图像生成视频片段,控制镜头角度,创建专业质量的图像,并开发自定义运动设计元素。该功能支持 1080p 分辨率,并即将推出 4K 模型。
    WorkflowAI

    WorkflowAI

    WorkflowAI是一个开源平台,供产品和工程团队合作构建和迭代AI功能,可以并行测试和比较80多种领先的人工智能模型,并评估其质量、成本和速度。
    查看完整榜单
    SD百科导航
    SD百科导航是专注于AI创作领域的专业导航网站。我们全面涵盖Stable Diffusion、Flux、AI绘画、AI视频、AI音乐以及大语言模型等前沿内容。

    关于我们友链申请广告合作

    扫码关注微信公众号SD百科导航
    扫码关注微信公众号
    Copyright © 2026 SD百科导航 皖ICP备18025588号-5  皖公网安备34040002000401 
    网址
    网址文章软件模型
      ↵ENTER↓↑NAV

      网址

      日榜周榜月榜
      LoginFlip

      LoginFlip

      LoginFlip 是一款专为 Chrome 浏览器设计的轻量级扩展,解决多账号管理痛点。它通过保存和恢复网站的登录状态(Cookie + localStorage),让你在不同身份(工作号、测试号、个人号等)之间实现秒级切换,彻底告别反复输入密码和退出登录的繁琐流程。
      BlitzBrowser

      BlitzBrowser

      BlitzBrowser是一款开源无头浏览器管理项目,核心价值在于将各类浏览器封装进Docker容器中,实现便捷的部署、运行与管理,支持本地或云端部署,同时兼容Chrome DevTools协议(CDP)。
      海绵音乐

      海绵音乐

      海绵音乐是由字节跳动最新推出的免费AI音乐创作和分享平台。它旨在利用AI技术生成个性化音乐,让用户能够轻松创作出符合自己风格的音乐作品。
      SentrySearch

      SentrySearch

      SentrySearch 将你的 mp4 视频分割成重叠的片段,使用 Google 的 Gemini Embedding API 或本地的 Qwen3-VL 模型将每个片段嵌入为视频,并将向量存储在本地 ChromaDB 数据库中。当你搜索时,你的文本查询被嵌入到同一向量空间中,并与存储的视频嵌入进行匹配。最佳匹配会自动从原始文件中裁剪出来,并保存为一个片段。
      Adobe Firefly Video

      Adobe Firefly Video

      由 Firefly 视频模型支持,创意专业人士可以从文本提示或图像生成视频片段,控制镜头角度,创建专业质量的图像,并开发自定义运动设计元素。该功能支持 1080p 分辨率,并即将推出 4K 模型。
      WorkflowAI

      WorkflowAI

      WorkflowAI是一个开源平台,供产品和工程团队合作构建和迭代AI功能,可以并行测试和比较80多种领先的人工智能模型,并评估其质量、成本和速度。
      查看完整榜单