Edge0 开源 Audio8-ASR-Infinite,一款面向实时场景的原生流式中英双语语音识别模型,主打超低延迟+无限时长持续转写,依靠循环滑动缓存,解决长时间音频识别出现的文本漂移、显存溢出问题。
- GitHub:https://github.com/Edge0-AI/Audio8-ASR-Infinite
- 模型:https://huggingface.co/Edge0/Audio8-ASR-Infinite
其核心突破在于通过循环滑动 KV Cache 机制实现计算延迟与显存占用恒定,彻底解决长音频转写漂移与内存溢出问题,支持 7×24 小时不间断运行。
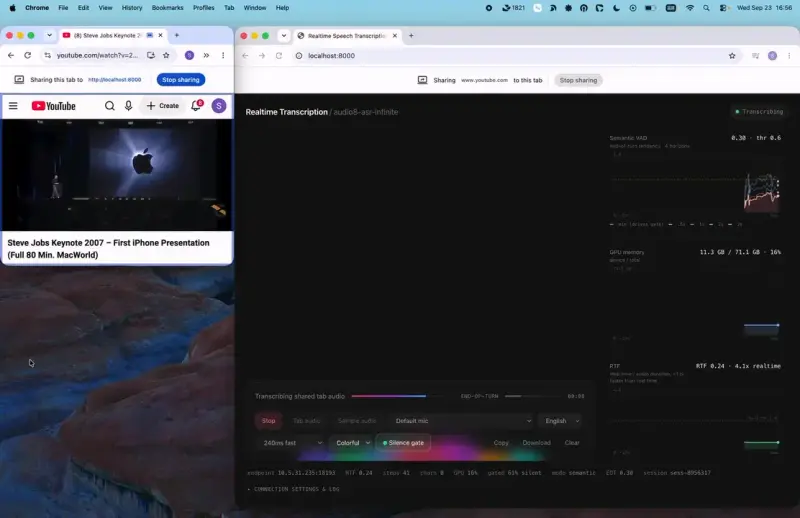
模型提供 80/120/160 ms 三档音频时钟,转写延迟可在 240–560 ms 间灵活配置;内置语义级 VAD(非声学),精准区分真实停顿、结巴与话语结束,避免误截断。在 480ms 延迟、80ms 帧长下,AISHELL-1 CER 仅 1.75%,显著优于 Voxtral-Mini-4B(16.8%)与 Nemotron-3.5-ASR(12.9%)。当前为预览版,仅交付转写能力;正式版将基于同一帧网格扩展实时语义感知。
核心亮点
- 原生流式、可调延迟
支持80 / 120 / 160ms三档音频时钟,转写延迟区间 240–560ms,可灵活取舍延迟与识别准确率;最高每秒解码12.5次,逐token输出。 - 7×24小时不间断长音频转写
采用滚动KV Cache窗口,显存占用、计算延迟维持恒定。长时间直播、持续对话场景下模型性能不会随音频累积逐步劣化,不会出现文本漂移。 - 语义VAD(语义活动检测)
依靠语义判断语句是否结束,不是单纯依靠音量阈值。思考停顿、结巴、短暂静默不会被误判定为说话结束,很适合直播听写、实时语音交互。 - 中英双语支持
模型架构
音频主干基于Voxtral Realtime 4B,流式方案采用DSM;解码器使用Qwen2.5-3B-Instruct。
| 组件 | 初始权重 | 是否训练 |
|---|---|---|
| Causal Audio Tower | Voxtral Realtime 4B | ✅ |
| Audio Projector | 随机初始化 | ✅ |
| Frame Length Embedding | 随机初始化 | ✅ |
| Decoder | Qwen2.5-3B-Instruct | ✅ |
| LM Head | Qwen2.5-3B-Instruct | ✅ |
帧长与延迟配置
target_delay_ms 需要是当前音频时钟的整数倍
音频时钟 frame_len streaming_n_left_pad_tokens 可选 target_delay_ms 80 ms 4 18 240 / 320 / 480 / 560 120 ms 6 12 240 / 480 160 ms 8 9 320 / 480
评测结果(480ms延迟,80ms帧长)
| 测试集 | 指标 | Audio8 ASR Infinite | Voxtral-Mini-4B-Realtime-2602 | nemotron-3.5-asr-streaming-0.6b |
|---|---|---|---|---|
| aishell1/test | CER | 1.750 | 16.795 | 12.927@560ms |
| aishell4/test | CER | 2.893 | 16.456 | 14.677@560ms |
| librispeech test.clean | WER | 3.042 | 2.210 | 3.353@560ms |
| librispeech test.other | WER | 6.808 | 5.552 | 7.140@560ms |
| 平均 | 3.623 | 10.253(2库) | 9.524 |
在中文Aishell1、Aishell4数据集上,Audio8-ASR-Infinite字符错误率大幅优于另外两款流式ASR;英文Librispeech上略弱于Voxtral-Mini。
路线图
- 预览版 ✅:仅提供ASR转写能力,支持滚动KV长音频、多档时钟与目标延迟配置
- 正式版 🏃开发中:在同一帧网格、同一声学前向链路,增加帧级语义感知能力
适用场景
直播实时字幕、线上会议不间断听写、长时语音交互、客服持续通话录音转写,对低延迟、长时间稳定识别有强需求的场景。
© 版权声明
文章版权归作者所有,未经允许请勿转载。