SpaceXAI 正式推出语音转文本模型 Grok Voice Transcribe 2.0,模型 ID 为 grok-voice-transcribe-2.0。该版本基于 Grok Voice 音频基础模型构建,针对嘈杂电话线路、重叠人声、地方口音及口头凭证等高难度音频场景进行了专项优化。开发团队表示,在维持原有定价的前提下,2.0 版本的准确率较 1.0 版本提升了一倍。
- 官方介绍:https://x.ai/news/grok-voice-transcribe-2
目前该模型仅以托管 API 形式提供服务,支持批处理与实时流式两种调用模式。SpaceXAI 尚未开放模型权重,因此用户无法自行部署或微调。对于需要集成语音转录能力的开发者而言,这是当前唯一可用的接入方式。
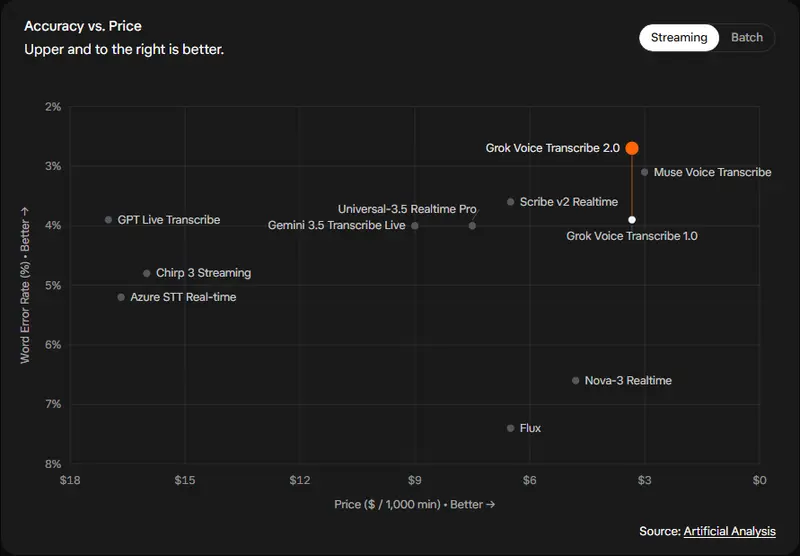
基准测试表现与内部验证数据
在第三方平台 Artificial Analysis 的流式语音识别排行榜上,Grok Voice Transcribe 2.0 在 32 个参评模型中位列第一。该榜单使用的 AA-WER Streaming 基准包含约 8 小时音频,权重分配为 AA-AgentTalk 50%、VoxPopuli 25%、Earnings22 25%。
SpaceXAI 还公布了从生产流量中抽取的四个内部测试集的词错误率(WER)结果:
- 电话(8 kHz):英语客户支持通话,官方称领先于其测试过的所有竞品模型。
- 对话:用户与 Grok 助手的英语交互录音。
- 凭证:电话号码、邮箱、地址等结构化口语信息。
- 短短语:覆盖 19 种语言的语音助手指令。
在所有四个集合上,2.0 版本均优于 1.0 版本。其中短短语集合的 WER 从 20.6% 降至 6.8%,降幅约 67%。需注意的是,这些内部数据由供应商自行报告,尚未经过独立第三方复现验证。
多语言能力与开发者功能集
多语言准确性是此次升级的重点改进方向。模型支持数十种语言的自动检测与转录,并能在单次处理中识别录音中途的语言切换。文档明确列出了 25 种语言用于数字、货币和单位的书面格式化输出。
API 层面提供了以下核心功能,均包含在基础定价内,无额外费用:
- 双模式接入:批处理支持最大 500 MB 文件及 12 种音频格式;流式传输通过 WebSocket (
wss://api.x.ai/v1/stt) 接入,支持 Opus 编码(约 4 KB/s)。 - 词级时间戳:每个词附带起止时间与置信度分数。
- 说话人分离:自动标注不同发言者身份。
- 多通道转录:最多支持 8 个音频通道独立处理。
- 关键术语偏置:每请求可指定最多 100 个领域术语(每个≤50 字符),提升专有名词识别率。
- 智能文本格式化:自动将数字、日期、货币、电话、邮箱转为规范书面形式。
- 填充词过滤:默认移除 “um”、”uh” 等语气词。
- 轮次结束预测:内置 ML 模型为语音代理预判发言结束时机。
定价结构与 Atlassian Loom 集成案例
Grok Voice Transcribe 2.0 延续了 1.0 版本的定价策略:
- 批处理转录:每小时音频 $0.10(约合每 1000 分钟 $1.67)
- 实时流式转录:每小时音频 $0.20(约合每 1000 分钟 $3.33)
说话人分离、时间戳、术语偏置等功能均包含在内,不另行计费。
Atlassian Loom 已将该模型作为其视频转录的默认后端。据 Atlassian 团队协作集合高级副总裁 Sanchan Saxena 介绍,实际工作流为“录制→转录→编码”:用户在 Loom 中录制行动计划后,转录文本被直接传入 Cursor 进行代码更新,形成“从上下文到代码的闭环”。Atlassian 方面表示,新模型在准确率上优于其原有解决方案。
使用注意事项与局限性
尽管性能指标亮眼,使用者仍需注意以下几点:
- 仅限 API 调用:必须显式设置
model=grok-voice-transcribe-2.0,无本地部署选项。 - 基准数据待验证:Artificial Analysis 排名虽具参考价值,但内部 WER 数据缺乏独立审计。
- 多语言格式化范围有限:仅 25 种语言支持结构化输出,其余语种可能返回原始转录文本。
- 流式带宽差异显著:Opus 编码仅需 4 KB/s,而 24 kHz PCM 需 48 KB/s,选型直接影响成本与延迟。
对于正在评估 STT 服务的团队,建议结合自身业务音频特征进行小规模实测,而非仅依赖公开基准排名。尤其在非英语、强噪声或高密度术语场景下,实际表现可能与实验室数据存在偏差。
© 版权声明
文章版权归作者所有,未经允许请勿转载。