蚂蚁百灵发布 Realtime-Venus,一套支持异步任务委派的全双工音视频交互系统。核心设计是将实时全双工对话模型与异步任务执行框架解耦,用户可以在下达任务之后继续和助手交谈,后台并行处理耗时工作;任务完成后,结果会汇入同一会话,由模型用语音播报反馈。项目配套论文、源码、网页Demo一同公开。
- 项目主页:https://realtime-venus.github.io
- GitHub:https://github.com/inclusionAI/Realtime-Venus
- 模型:https://huggingface.co/inclusionAI/Realtime-Venus
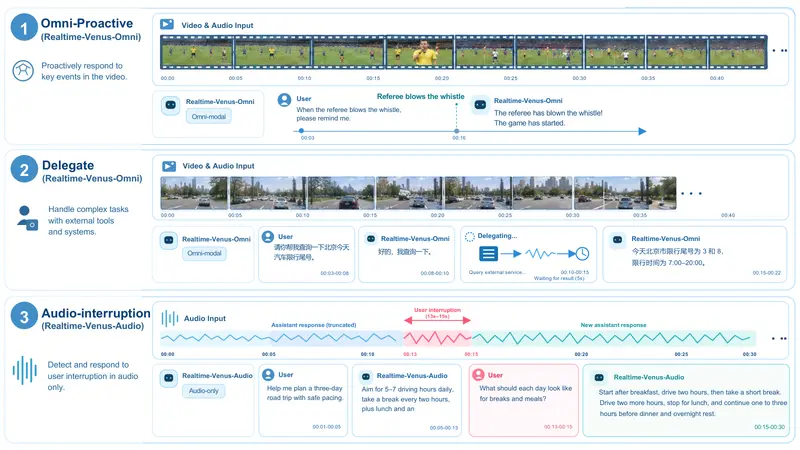
三大组件
| 组件 | 规格 | 能力说明 |
|---|---|---|
| Realtime-Venus-Omni | 9B | 流式音视频对话模型,持续感知画面+语音,原生语音生成,支持主动交互 |
| Realtime-Venus-Audio | 9B | 纯语音对话模型,音频理解、全双工交互、原生语音输出 |
| Realtime-Venus-Harness | 执行框架 | 两套模型共用,接收任务委派、调度后台工具执行,将结果回传原始对话会话 |
核心能力
- 持续视听交互:Omni持续读取摄像头+麦克风输入,感知环境画面动态变化,依据场景主动发起回应。
- 原生全双工对话:模型自身说话的同时持续接收用户语音,可区分附和语气、背景人声,识别并合理处理用户打断。
- 异步任务委派:遇到复杂推理、工具调用任务,模型把需求交给Harness后台运行,前台对话不会中断。
- 会话内结果交付:后台任务就绪后,交由前端模型选择合适时机,把结果用语音自然输出;任务完成时刻、语音播放时刻分开独立跟踪。
核心原理:双循环架构
系统采用两套独立循环并行运行:
- 前台循环:负责实时视听对话,维持不间断交流,处理插话、附和、画面变化;
- 后台循环:承载耗时推理、工具调用、长任务处理。
前台对话与后台任务共享同一条对话时间线与上下文。前台模型判断任务是否需要委派,一旦下发,用户可以继续聊天、随时打断,不必等待任务跑完。后台任务完成之后,结果重新并入对话流,由模型挑选自然时机播报,不会生硬插入对话。
模型训练不只学习问答理解,还专门学习交互行为:包括什么时候接话、如何应对打断、识别背景杂音、何时把任务交给后台执行。
评测表现
视听模型 Realtime-Venus-Omni
在多项视频基准中拿下6项最优:
- StreamingBench:70.2%
- OVO-Bench:64.7%
- Daily-Omni:81.3%
纯语音模型 Realtime-Venus-Audio
音频评测多项领先:
- MMAU:78.0%
- MMAU-Pro:63.2%
- Llama Questions:83.8%
- Speech CMMLU:67.8%
- VoiceBench AlpacaEval:4.81,并列最佳
全双工专项测试 Full-Duplex-Bench v1.5
- 成功响应75%的用户打断;
- 用户附和场景持续交流率97%;多人交谈背景88%;通用背景人声86%。
论文数据显示,这三项指标超过Gemini 3.1 Live、GPT-4o。注:该结论仅限论文选定测试集与实验环境,不代表所有真实场景都稳定领先。
适用场景
- 个人智能助手:查询资料、日程处理,无需等待任务结束再继续聊天
- 在线教育:结合画面演示+语音实时互动,支持学生随时打断补充
- 会议协作:识别多人插话,后台同步整理纪要、检索信息
- 车载、智能眼镜、机器人:感知环境画面+语音,持续交互
- 无障碍辅助:自然连续的视听交互获取信息
开源交付内容
- Realtime-Venus-Omni 模型接入代码
- 可复用 Realtime-Venus-Harness 异步任务框架包
- 网页Demo,内置Codex任务后端;网页纯麦克风模式同样使用Omni模型
- arXiv论文:2609.13814,详细阐述模型家族、双循环机制、训练数据与评测方案
局限提示:当前主要验证模型交互能力,长期稳定性、隐私策略、设备部署成本、复杂真实环境可靠性还需要持续迭代。
© 版权声明
文章版权归作者所有,未经允许请勿转载。