英伟达在 Hugging Face 上线 Nemotron 3 Diarization,一款开放权重的说话人分轨(Diarization)模型,用来识别音频中谁在什么时间段说话,可处理多人声音重叠场景,单模型同时支持离线录音与实时流式音频推理。模型仅 100M 参数,许可证 OpenMDW License 1.1,允许商业使用,依托 NVIDIA NeMo 框架,在 Ampere、Ada、Hopper、Blackwell 系列 GPU 上部署。
- 模型:https://huggingface.co/nvidia/Nemotron-3-Diarization
- Demo:https://huggingface.co/spaces/nvidia/nemotron-diarization
核心定位:说话人分离的价值
ASR 语音识别只能输出文字,但无法区分发言人。说话人分离输出每个人的发言时间区间,和 ASR 结果合并,生成带发言人标记的完整转录文本,是会议纪要、通话质检、播客处理、AI 智能体记忆链路里的关键一环。
前代 Streaming Sortformer 最多支持 4 位说话人,Nemotron 3 Diarization 将上限提升至 8 人,专门应对多人同时发声的嘈杂对话场景。
核心技术解析
架构设计
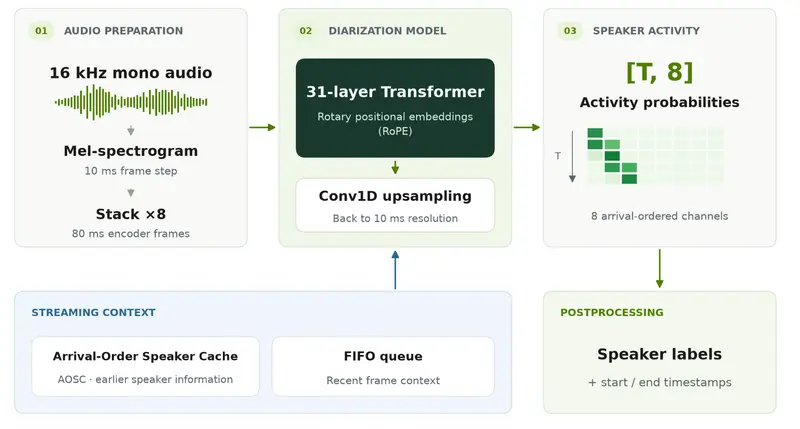
- 输入处理:16kHz 单声道音频 → 10ms 步长 Mel 频谱图 → 8 帧堆叠为 80ms 编码器帧
- 主干网络:31 层 Transformer + RoPE 位置编码 → Conv1D 上采样回 10ms 分辨率
- 输出格式:
[T, 8]张量,每帧 8 通道独立激活,原生支持重叠语音 - 说话人排序:沿用 Sortformer 按到达时间分配通道(首声→通道1,次声→通道2…),确保流式块间标签稳定
- 流式记忆机制:
- AOSC(Arrival Order Speaker Cache):保留历史说话人特征
- FIFO 队列:提供近期上下文
- 标签匿名化:身份映射交由下游应用
四档延迟配置
| 模式 | 缓冲延迟 | DIHARD III DER | RTFx (batch32, compiled) | 适用场景 |
|---|---|---|---|---|
| 离线风格 | 30.4 s | 12.73% | 15,113× | 录音转写、批量处理 |
| 低延迟 | 1.04 s | 13.18% | 865× | 会议记录、通话分析 |
| 极低延迟 | 0.64 s | 13.28% | 579× | 实时字幕、语音助手 |
| 超低延迟 | 0.32 s | 13.55% | 292× | 交互式对话、直播监控 |
⚠️ 注意:延迟仅含输入缓冲,不含计算/网络/ASR 耗时;0.32s 为推荐最低值,80ms 理论可行但不稳定。
性能验证与数据基础
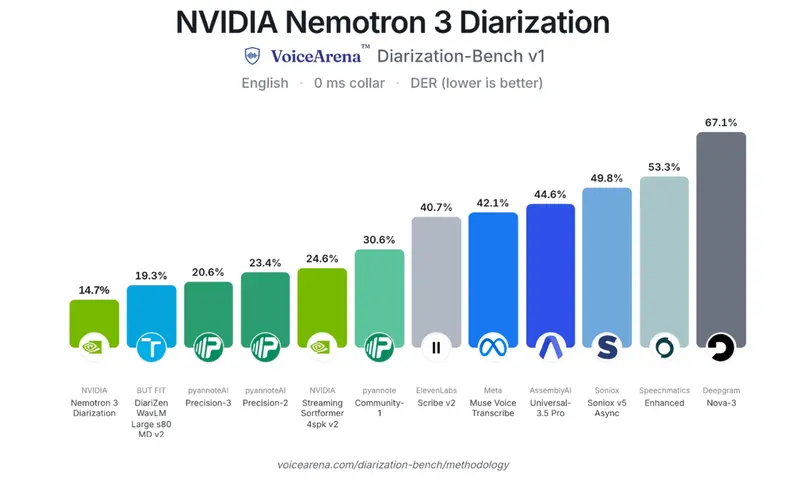
- Voice Arena Diarization-Bench:139 段英语对话(~22h),12 系统 17 配置中 DER 最优(14.72%)
- vs Streaming Sortformer v2.1:8 项评估条件 DER 全面下降,未加权平均相对改善 41.0%(CALLHOME-Part2: 9.0% → NOTSOFAR1 MHM: 65.2%)
- 已知回归:2 说话人 CALLHOME @30.4s DER 从 5.68% → 5.98%(全集仍改善至 9.10%)
- 训练数据:
- 真实对话:~10,000 小时
- 模拟混合:82,611 小时(21 语种授权源音频)
- David AI 多说话人数据:使复合 DER 从 11.19% → 10.42%
部署与集成要点
- 许可:OpenMDW License 1.1 ✅ 允许商业用途
- 硬件要求:NVIDIA Ampere / Ada Lovelace / Hopper / Blackwell GPU
- 软件栈:必须通过 NVIDIA NeMo 框架运行(Linux)
- 音频格式:.wav / .flac / .opus / .mp3(16kHz 单声道)
- 下游对接:输出为时间戳+通道ID,需自行绑定说话人身份(如结合 ASR + 声纹识别)
适用场景
- 多人会议/访谈自动转录与归属
- 客服通话质检与情绪归因
- 播客/视频内容结构化索引
- 语音智能体长期记忆构建
- 实时字幕生成(≤0.64s 延迟)
© 版权声明
文章版权归作者所有,未经允许请勿转载。