Kyutai 开源 Voice of Reason 系列两个 9B 参数语音到语音模型,首次在语音原生架构中应用强化学习(RL)解决数学推理问题。模型基于 GLM-4-Voice-9B,经监督微调(SFT)与 RL 两阶段训练,在口语 GSM8K 基准上准确率从基础模型的 27.3% 提升至 77.1%(Stitch 变体),且无需转录或外部文本 LLM。
- GLM-4-Voice of Reason :https://huggingface.co/kyutai/glm-4-voice-of-reason-9b
- GLM-4-Voice of Reason (stitch):https://huggingface.co/kyutai/glm-4-voice-of-reason-stitch-9b
两个检查点均可在单块 H100 上以 BF16 自托管运行,权重继承 GLM-4-Voice 许可证。研究证实关键设计——温度校正与音频 token 合并——对性能至关重要;移除温度校正会导致准确率崩溃至 12.3%。语音自然度在 RL 后基本保持,但通用知识(TriviaQA)有所下降,主要归因于 SFT 数据而非 RL。
核心技术突破
为何语音模型此前数学能力弱
- 级联管线(ASR→LLM→TTS)虽准确但延迟高、丢失副语言线索
- 语音原生模型需持续输出音频维持交互性,限制隐藏推理 token 预算
- 基础 GLM-4-Voice 在 GSM8K 仅 27.3%,STITCH 方法通过添加推理块提升至 58.7%
两阶段训练流程
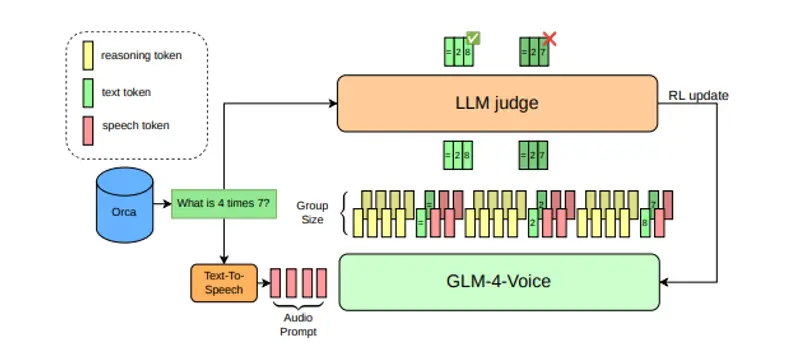
- SFT 阶段:使用 Orca-Math 150,616 题,由 Qwen3-235B 重写为口语形式,Kyutai DSM TTS 多音色合成。仅 SFT 即提升至 61.7%。
- RL 阶段:
- 每题采样 4 个回复(温度 0.9)
- Qwen3-235B-A22B-2507 作为评判者,对解码文本给二元奖励(不见参考答案,与人类一致率 88%)
- 奖励组内居中,采用类 GRPO 目标(无 PPO 裁剪/KL 正则)
- 16×H100 训练 1,500 步更新
两大关键设计
| 设计 | 作用 | 缺失后果 |
|---|---|---|
| 温度校正 | log-softmax 前 logits 除以采样温度 | GSM8K 从 65.5% → 12.3% |
| 音频 token 合并 | 每位置所有音频词概率求和为抽象 token,损失仅判断“是否发声” | 保证估计器无偏低方差 |
模型变体与性能对比
| 模型 | 推理方式 | GSM8K (%) | 备注 |
|---|---|---|---|
| GLM-4-Voice | 无 | 27.3 | 基础模型 |
| STITCH | 静默推理块 | 58.7 | 先前 SOTA |
| Voice of Reason (Direct) | 无额外推理 token | 70.3 | 逐步工作大声说出 |
| Voice of Reason (Stitch) | 100-token 静默推理块 | 77.1 | 推理与语音并行生成,不增延迟 |
| Qwen3-Omni (文本输出) | — | 94.6 | 更大模型,非直接可比 |
| 级联 ASR-LLM-TTS | — | 95.7 | 31B LLM,延迟高 |
💡 重要说明:论文报告分数(65.5%/74.8%)使用 top-k=50 解码;发布检查点对应移除 top-k 的更高分数(70.3%/77.1%)。Omni/级联系统规模更大,非公平对照。
关键发现与局限性
✅ 积极结果:
- RL 增益在真实语音中存活:Qwen3-ASR 转录后 Stitch 模型仍达 72.0±1.9%
- 语音自然度保持:UTMOSv2 变化 <0.01(Direct: 4.067→4.069;Stitch: 4.174→4.164)
- 效率提升:RL 将 Direct 模型平均回复从 41.9s 缩短至 36.4s
- 小数据高效:仅 10% SFT 数据 + 长 RL 运行可达 58.5%(纯 SFT 仅 43.9%)
⚠️ 已知局限:
- 通用知识下降:口头 TriviaQA 从 40.6% → 34.0%,主因 SFT 数据偏向数学
- 数据污染风险:评估集 54.0% 问题与 Orca-Math 在复述层面重叠(已排除 AddSub 等子集)
- 评估依赖外部 TTS:测试音频来自 GPT-4o-mini-TTS(不同于训练 TTS),评判者为 GPT-4o
- 仅支持数学:未验证其他推理任务泛化能力
部署与使用指南
- 硬件要求:单块 H100(BF16)即可运行任一检查点
- 依赖项:需克隆 GLM-4-Voice 仓库 获取语音 tokenizer 与解码器
- 模型选择:
glm-4-voice-of-reason-9b:适合需透明推理过程的场景(如教学)glm-4-voice-of-reason-stitch-9b:追求最高准确率且接受静默推理
- 许可:继承 GLM-4-Voice 许可证,商用前务必核查条款
- 当前状态:Hugging Face 开放权重,但暂无推理服务商托管,需自部署
对于教育科技、无障碍辅助、车载交互等场景,这是首个真正“会思考”的开源语音模型。但请记住:它擅长解数学题,不等于能胜任所有对话。用它加速特定任务,但别让单一指标定义智能的全部维度——因为有些理解藏在语调的起伏里,有些智慧生于沉默的思考中,而这些,永远需要人的耳朵与心灵共同聆听。
© 版权声明
文章版权归作者所有,未经允许请勿转载。