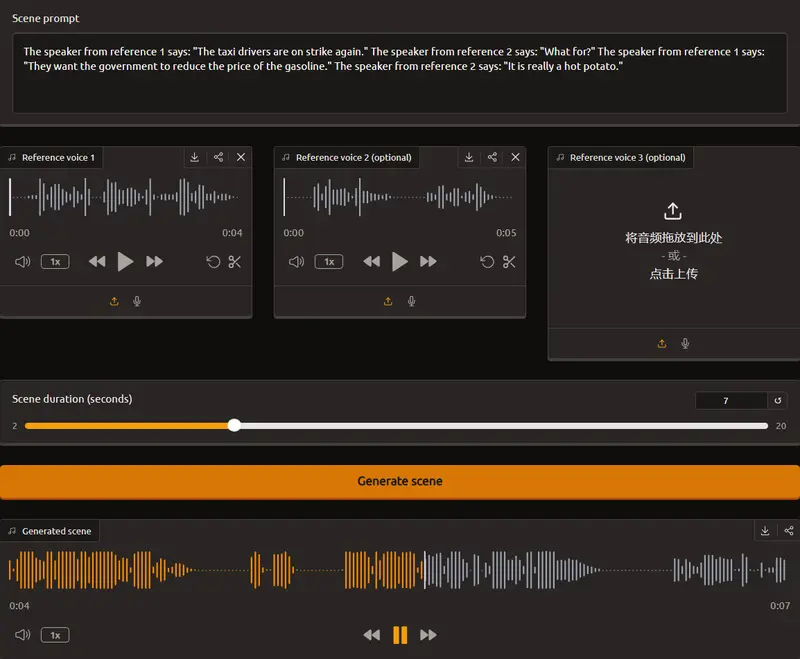
多说话人音频生成框架ScenA:一句话生成多人真实对话,自带环境音与重叠人声Lightricks与特拉维夫大学联合推出ScenA,一种无需结构化脚本、仅凭自由文本描述+多段参考语音即可生成完整多人对话音频的AI框架。其核心创新在于将流匹配基础模型(预训练于大规模野外数据)直接...语音模型# ScenA3个月前750
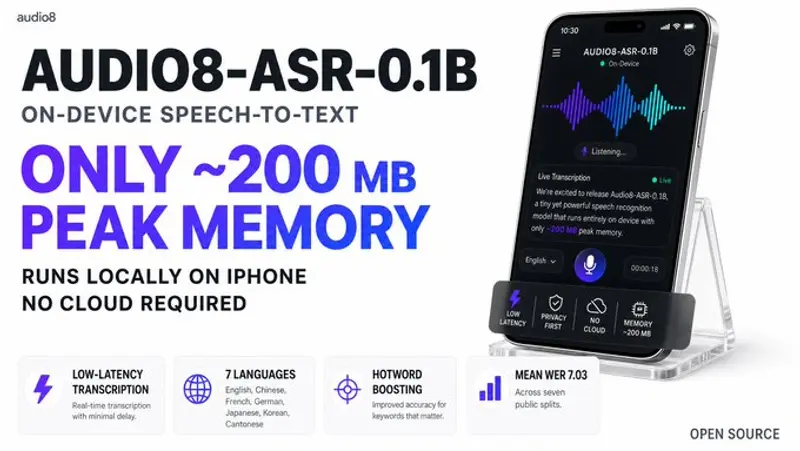
Audio8推出Audio8-ASR-0.1B:0.1B参数多语言ASR模型,支持iOS本地转录与边缘部署Audio8推出Audio8-ASR-0.1B,一款专为LLM时代设计的紧凑型自回归语音识别模型。其语言模型组件仅0.1B参数,端到端唯一参数约0.324B,支持中文、英语、法语、德语、日语、韩语及粤...语音模型# Audio8# Audio8-ASR-0.1B3个月前2220
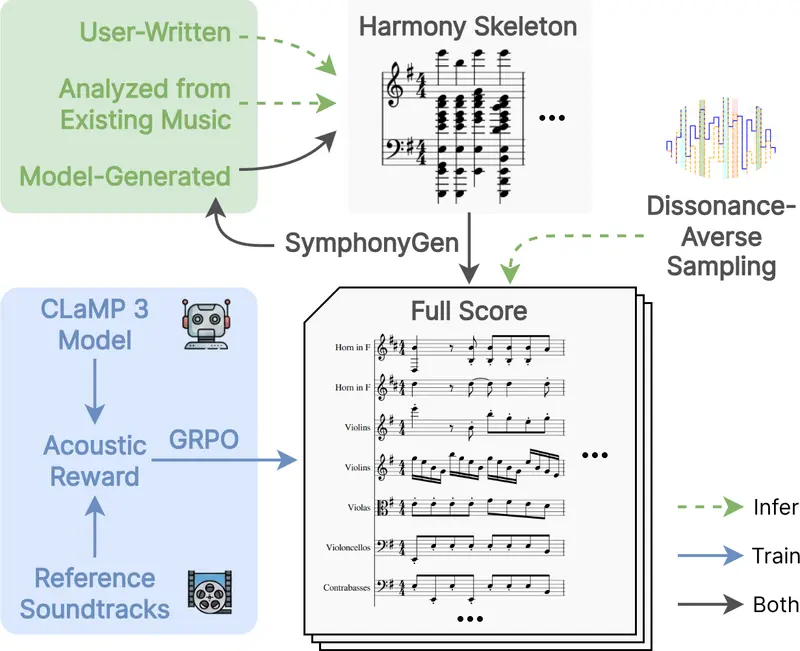
AI 作曲系统SymphonyGen:具有可控和声骨架的3D层次化管弦乐生成让 AI 写一首流行歌或钢琴曲,现在已经不算稀奇。但如果让 AI 写一部交响乐——那种有几十种乐器、十几个声部、要持续演奏几十分钟的宏大作品——难度就完全不一样了。 交响乐创作之所以难,是因为它同时涉...语音模型# AI 作曲# SymphonyGen# 电影配乐3个月前1200
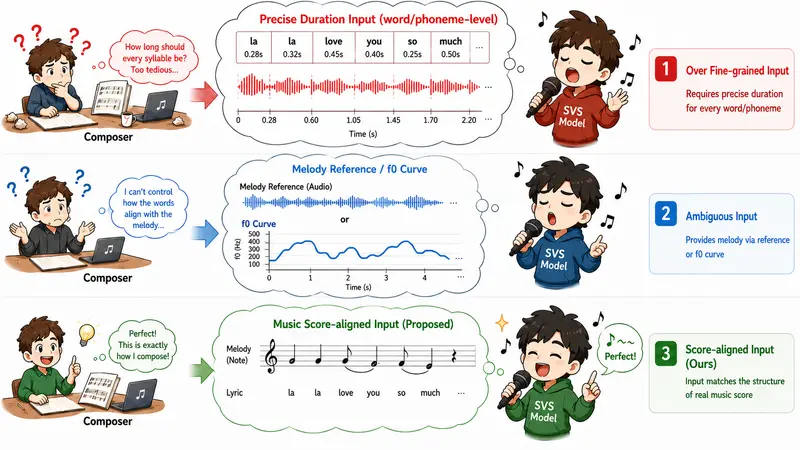
VocalRender:乐谱即歌声,通过交错表示实现自然的转音与情感表达在传统的歌声合成(SVS)系统中,作曲家往往需要花费大量精力去调整每个音素的时长、对齐 F0 曲线或提供复杂的参考音频。VocalRender 由西安交通大学、南洋理工大学、蚂蚁集团和浙江大学的研究人...语音模型# VocalRender3个月前1300
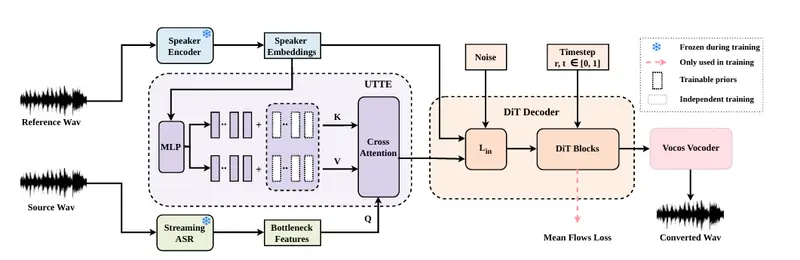
MeanVC2:110ms 超低延迟,鲁棒流式零样本语音转换由西北工业大学软件学院音频、语音与语言处理组、新南威尔士大学及 WeNet 开源社区联合推出的 MeanVC2,标志着流式语音转换(Voice Conversion, VC)技术在低延迟与高保真度之间...语音模型# MeanVC23个月前2110
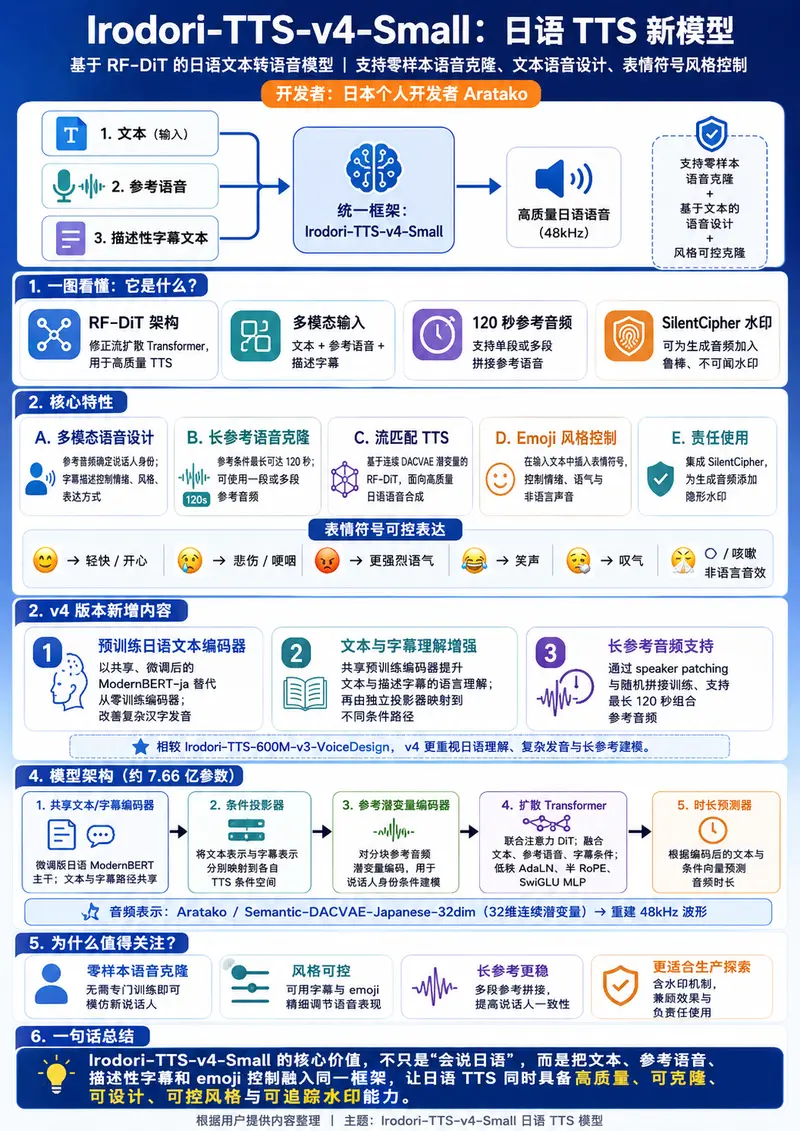
Irodori-TTS-v4-Small:用 Emoji 控制语气的日语零样本语音克隆模型日本个人开发者 Aratako 最新推出了 Irodori-TTS-v4-Small,这是一个基于修正流扩散 Transformer(RF-DiT)架构的日语文本转语音(TTS)模型。 GitHub...语音模型# Irodori-TTS-v4-Small# TTS# 日语3个月前1330
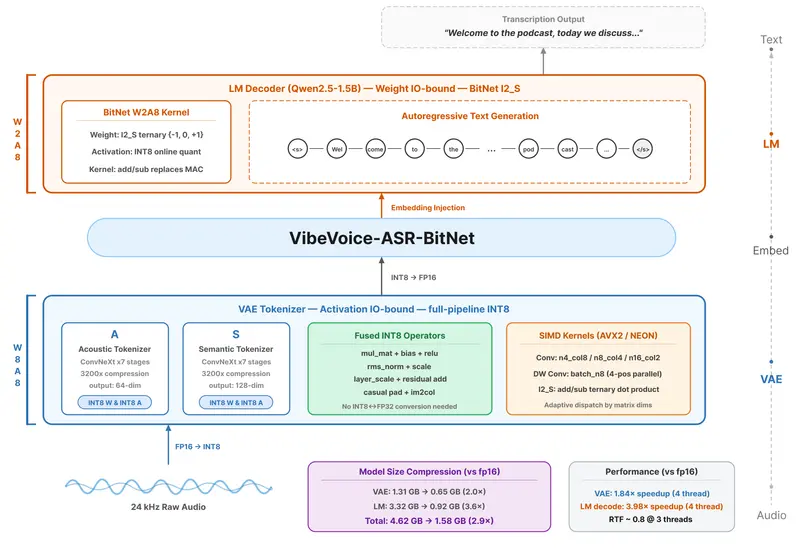
微软发布 VibeVoice-ASR-BitNet:无需 GPU,CPU 也能实现多语言实时语音识别在边缘设备上运行高精度的语音识别(ASR)模型,通常意味着要在“速度”和“准确率”之间做艰难取舍。大多数高性能模型依赖 GPU 加速,而轻量级模型往往牺牲了多语言支持或识别精度。 GitHub:htt...语音模型# VibeVoice-ASR-BitNet# 微软3个月前1260
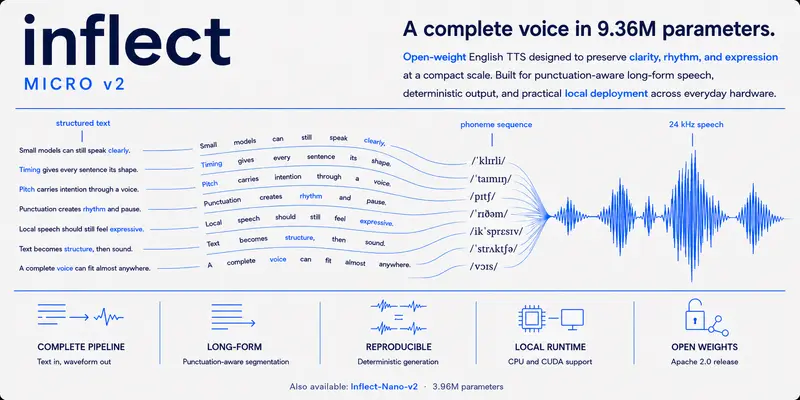
Inflect v2:权重仅 16MB 的本地高质量英文 TTS 模型在文本转语音(TTS)领域,我们通常需要在“音质”和“体积”之间做妥协。高质量的模型往往动辄几百 MB 甚至 GB,且依赖复杂的外部声码器或云端推理。 GitHub:https://github.co...语音模型# Inflect v2# TTS3个月前1020
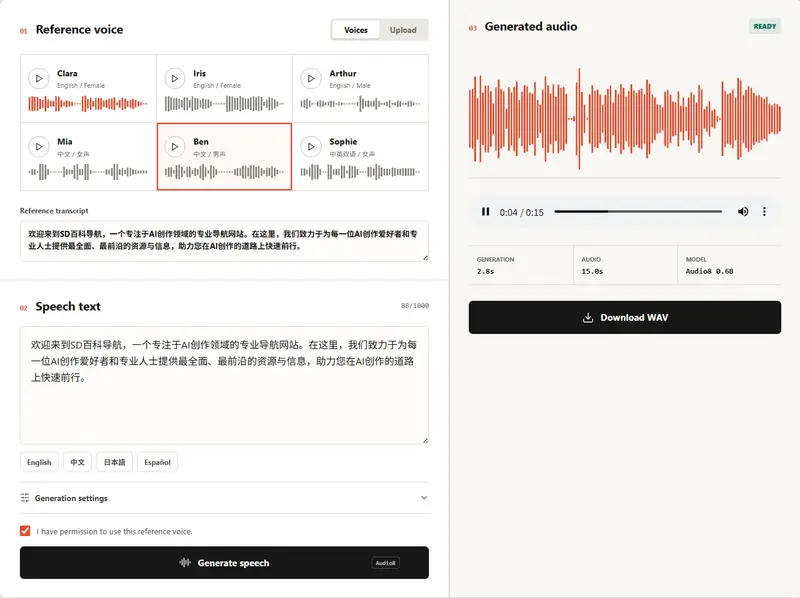
Audio8 TTS Preview:0.6B 参数实现零样本音色克隆的开源语音模型在文本转语音(TTS)领域,如何在保持高自然度的同时实现快速的音色克隆,一直是技术攻关的难点。Audio8 TTS Preview 提供了一个轻量级且高效的解决方案。这是一个仅拥有 0.6B(6 亿...语音模型# Audio8 TTS Preview3个月前1540
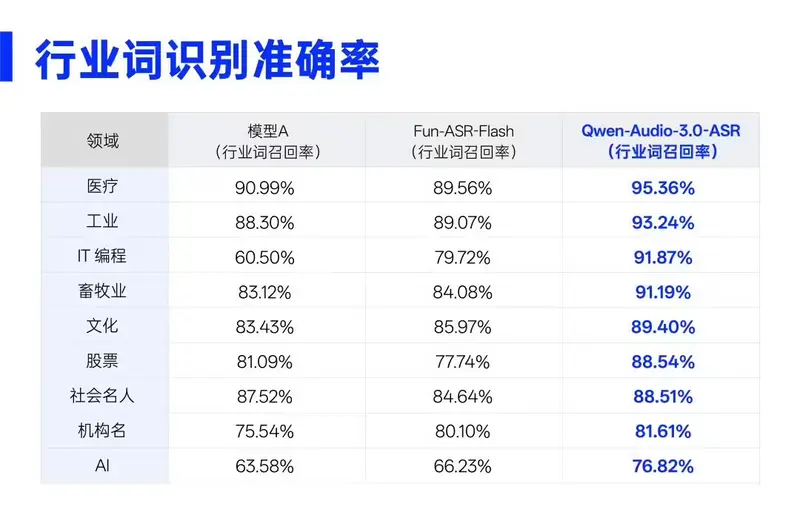
阿里发布 Qwen-Audio-3.0-ASR-Flash:医疗术语识别率超 95%,错字率仅 1.7%阿里巴巴今天发布了最新的语音识别大模型 Qwen-Audio-3.0-ASR-Flash。 如果说以前的语音识别是“听清你在说什么”,那么这一代的目标就是“听懂你在说什么”,尤其是那些晦涩难懂的专业词...早报语音模型# Qwen-Audio-3.0-ASR-Flash# 阿里巴巴3个月前1610
Fish Audio 发布 S2.1 Pro:90ms 超低延迟,支持 83 种语言与实时语音克隆在 AI 语音领域,速度就是生命。 Fish Audio 今天正式推出了其最新的生产级 TTS 模型 S2.1 Pro。这款模型不仅将首次音频输出时间压缩至约 90 毫秒,更支持 83 种语言和高质量...语音模型# Fish Audio# S2.1 Pro3个月前920
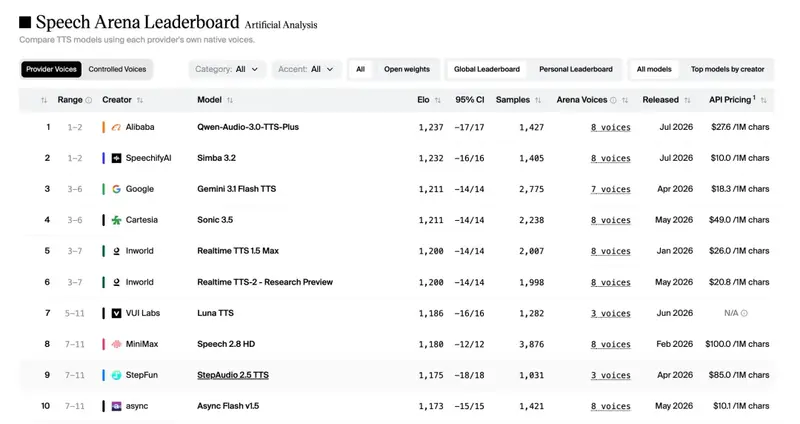
阿里千问发布 Qwen-Audio-3.0-TTS:支持细粒度情感控制与 48KHz 高保真音质阿里巴巴通义千问团队正式发布了新一代语音合成大模型 Qwen-Audio-3.0-TTS。该模型在细粒度情感控制、多语种方言覆盖及声学鲁棒性上实现了系统性突破,旨在让 AI 语音摆脱机械感,具备真正的...语音模型# Qwen-Audio-3.0-TTS3个月前2270