在当前的 AI 音频领域,工具往往是割裂的:想配音用 TTS 模型,想降噪用增强模型,想分离人声又得换另一个软件。这种“工具箱”式的工作流不仅繁琐,还容易导致音色不统一、风格冲突。
腾讯最新开源的 AuK(Audio Unified Kit)是一个拥有 15 亿参数的统一语音生成与编辑基础大模型,将语音合成、多维编辑、降噪增强、音源分离等五大类任务整合进同一套架构中。用户只需通过自然语言指令,即可让 AI 完成从“从零生成”到“精细修改”的全流程音频工作。
- 项目主页:https://auk-project.github.io
- GitHub:https://github.com/Tencent-Hunyuan/AuK
| 模型 | 描述 | 权重 |
|---|---|---|
| AuK | 高质量生成的基础模型 | 🤗 Hugging Face · 🤖 ModelScope |
| AuK-Flash | 蒸馏模型,支持快速四步推理 | 🤗 Hugging Face · 🤖 ModelScope |
此外,腾讯还推出了高速蒸馏版 AuK-Flash,推理速度提升 4.5 倍,让普通消费级硬件也能流畅运行。
核心功能:五大能力,一令即达
AuK 不再区分“生成”与“编辑”的边界,所有任务均通过统一的文本指令接口完成:
- 指令式语音合成 (TTS)
- 零样本复刻:上传一段参考音频,AI 即可复刻其音色朗读新文本。
- 风格控制:通过文字描述指定情绪(如“愤怒”、“悄悄话”)、语速、口音等。
- 多维度语音编辑
- 局部修改:增删替换录音中的部分文字,保留原说话人音色和背景音。
- 属性调整:改变情绪、语速、音调、音量,甚至将正常说话转为“耳语”。
- 歌词/口音修改:修改演唱歌词或消除/添加特定口音,尽量保持原声特质。
- 音频增强与修复
- 一键去除噪音、回声,修复电话录音或低带宽导致的音质受损,还原清晰人声。
- 音源分离
- 将多人对话拆分为独立说话人轨道,或将歌曲中的人声与伴奏完美分离。
- 智能指令助手
- 内置预处理模块,能理解用户口语化的模糊需求(如“把这段声音弄得更有感情一点”),自动转化为模型可执行的结构化指令。
技术亮点:统一架构,高效蒸馏
1. 真正的“大一统”架构
AuK 由三大核心组件构成:
- 多模态 LLM:作为“大脑”,理解文本指令并提取语义条件。
- 共享音频 VAE:作为“耳朵”和“嘴巴”,统一压缩和还原所有类型的音频特征。
- 混合 Transformer 主干:双通路设计,同时处理语义信息与音频特征,实现深度融合。
2. 双阶段对齐训练
- 预训练:先学基础 TTS,再混合编辑、降噪、分离等多任务联合训练,实现能力迁移(如学了“转悄悄话”就能直接生成悄悄话)。
- 后对齐优化:引入人类反馈偏好优化(DPO)和强化学习(RL),确保编辑后的音频更符合人类听感,且不影响基础合成质量。
3. AuK-Flash:速度与质量的平衡
通过一致性初始化和任务路由解耦分布匹配蒸馏,AuK-Flash 将推理步数大幅减少,速度提升 4.5 倍,同时在绝大多数任务上保留了完整版的高水准表现。
性能表现
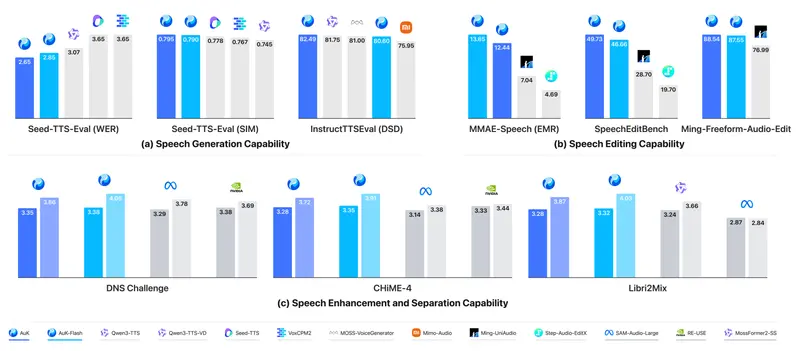
- 语音生成:在中英文零样本音色复刻中,AuK 的相似度与文字识别准确率均处于领先地位。
- 语音编辑:在修改情绪、语速及局部文字替换任务中,AuK 能极好地保留未修改部分的音色与背景,指令遵从度优于多数基线模型。
- 增强与分离:在降噪和人声分离任务中,AuK 在保留说话人音色方面表现优异,AuK-Flash 的主观听感评分甚至更高。
局限说明:属于科研原型,对极度超长音频稳定性有限;过于天马行空的口语指令需依赖助手改写;Flash 版本在极复杂任务上略有损耗。
应用场景
| 场景 | 应用示例 |
|---|---|
| 内容创作 | 短视频配音、播客后期、有声书角色生成、歌词改编。无需切换软件,本地即可完成配音、改情绪、修噪音。 |
| 办公效率 | 会议录音降噪、多人对话分离整理纪要、采访录音画质修复。 |
| 教育学习 | 生成不同语速/情绪的听力素材、制作去口音的语言练习音频。 |
| 隐私保护 | 本地部署,所有音频数据无需上传云端,适合处理敏感会议或个人录音。 |
© 版权声明
文章版权归作者所有,未经允许请勿转载。