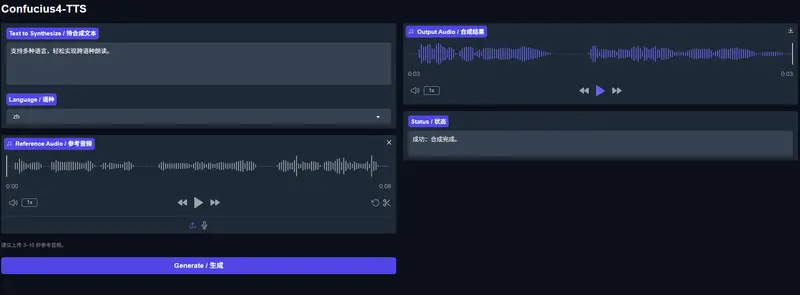
网易有道正式推出 Confucius4-TTS,这是一款基于大语言模型(LLM)架构的先进文本转语音系统。它专为多语种和跨语种语音合成设计,实现了“一种音色,任意语言”的愿景。
- 项目主页:https://2901733926.github.io/Confucius4-TTS
- GitHub:https://github.com/netease-youdao/Confucius4-TTS
- Demo:https://confucius4-tts.youdao.com/gradio
- 模型:https://huggingface.co/netease-youdao/Confucius4-TTS
Confucius4-TTS 能够在保持说话人音色高度一致的同时,实现跨 14 种语言的高质量、无口音语音生成,并支持无缝的情感迁移。无论是在视频本地化、有声书制作还是虚拟人交互场景中,它都提供了极具竞争力的解决方案。
核心特性:打破语言与音色的边界
1. 支持 14 种主流语言
覆盖全球主要语系,包括:
- 亚洲:中文、英文、日语、韩语、印尼语、泰语、马来语、越南语
- 欧洲:德语、法语、西班牙语、意大利语、葡萄牙语、俄语
- 注:更多语言支持正在陆续推出中。
2. 零样本跨语种声音克隆
- 无需参考文本:不同于传统 TTS 需要大量特定文本进行微调,Confucius4-TTS 仅需少量音频即可克隆音色。
- 无口音合成:在跨语种转换时(如用中文音色说英语),能彻底消除源语言的口音干扰,生成目标语言原生般的自然发音。
- 情感无缝迁移:不仅克隆声音特征,还能精准捕捉并迁移说话人的情感状态(如快乐、悲伤、愤怒),使合成语音更具表现力。
3. 强泛化能力
基于语音编码器 + LLM 的创新架构,模型在真实复杂的多语种场景中表现稳定,具备极强的泛化能力,能够适应各种噪声环境和说话风格。
性能实测:多项基准测试领先
Confucius4-TTS 在多个权威多语种及跨语种零样本 TTS 基准测试中展现了卓越性能,兼顾高可懂度(低 WER/CER)与高说话人相似度(高 SIM)。
1. CV3-eval 跨语种评估
在从其他语言转换为中文的任务中,Confucius4-TTS 表现出极高的稳定性:
- 韩→中 (ko→zh):WER 低至 1.46,远优于多数竞品。
- 日→中 (ja→zh):WER 为 4.93,在无需参考文本的情况下表现优异。
- 英→中 (en→zh):WER 为 6.71,保持了良好的清晰度。
2. X-Voice Benchmark
在德、法、日、韩等语言转中文的任务中,Confucius4-TTS 在可懂度和相似度之间取得了极佳平衡:
- 德→中 (de→zh):WER 2.86,SIM 0.569。
- 法→中 (fr→zh):WER 2.74,SIM 0.550。
- 日→中 (ja→zh):SIM 高达 0.637,音色还原度极高。
3. MiniMax-Multilingual-Test vs. ElevenLabs
在与国际顶尖商用模型 ElevenLabs 的直接对比中,Confucius4-TTS 在多种语言上展现出强劲竞争力,尤其在非英语语种上表现突出:
- 泰语 (Thai):WER 2.42 (vs. ElevenLabs 73.94),SIM 0.736 (vs. 0.588)。注:ElevenLabs 在此项出现严重失效。
- 越南语 (Vietnamese):WER 1.99 (vs. ElevenLabs 73.42),SIM 0.764 (vs. 0.369)。
- 德语 (German):WER 0.89,SIM 0.767,与 ElevenLabs (WER 0.57, SIM 0.614) 各有千秋,相似度更高。
- 西班牙语 (Spanish):WER 0.95,SIM 0.770,表现稳定。
(注:WER/CER 越低代表发音越准确,SIM 越高代表音色越接近原声。† 标记表示竞品需要参考文本,而 Confucius4-TTS 为零样本。)
技术架构:LLM 驱动的语音生成
Confucius4-TTS 采用先进的 语音编码器 + 大语言模型 (LLM) 架构:
- 语音编码器:高效提取输入音频中的音色、情感和韵律特征。
- LLM 核心:利用大语言模型强大的语义理解和序列生成能力,将文本特征与语音特征深度融合,实现跨语种的精准映射。
- 解码器:将 LLM 生成的潜在表示转化为高保真波形。
这种架构使得模型能够理解语言背后的深层语义,从而在跨语种转换时避免生硬的“翻译腔”,实现真正自然的表达。
对于需要处理多语种语音内容的开发者和创作者而言,Confucius4-TTS 提供了一个高效、高质量且极具性价比的新选择。
© 版权声明
文章版权归作者所有,未经允许请勿转载。