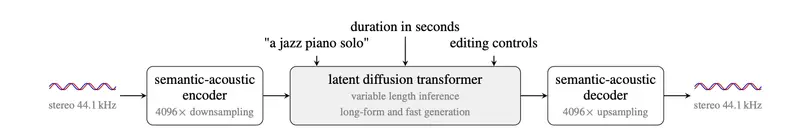
Stability AI 正式推出 Stable Audio 3,这是新一代超快文本生成音频/音乐模型家族。该系列包含 small、medium 和 large 三个版本,基于创新的语义-声学自编码器(SAME)与扩散 Transformer(DiT)架构,原生支持可变长度生成、音频修复(Inpainting)及片段延续。
- 模型:https://huggingface.co/collections/stabilityai/stable-audio-3
- 官方介绍:https://stability.ai/stable-audio
- GitHub:https://github.com/Stability-AI/stable-audio-3
凭借极高的压缩率和优化的推理流程,Stable Audio 3 不仅在 H200 GPU 上能在不到 2 秒内生成几分钟的高质量音频,更在 MacBook Pro M4 等消费级硬件上实现了秒级响应。目前,Small 和 Medium 模型的权重已全面开源,允许用户进行商业分发和本地定制。
核心突破:为何 Stable Audio 3 与众不同?
1. 原生可变长度生成(Variable-Length Generation)
传统扩散模型通常必须生成预设的最大长度,导致短音频生成时大量算力浪费在静音部分。Stable Audio 3 引入了可变长度注意力机制和动态噪声调整策略:
- 按需分配算力:计算量与生成长度成正比,生成 5 秒音效与生成 2 分钟音乐的成本差异巨大,极大提升了效率。
- 质量稳定:实验显示,从 5 秒到 380 秒(6 分 20 秒),音频质量几乎无下降,推理时间平滑增长。
2. 极速推理:Ping-Pong 采样与对抗后训练
- 8 步出奇迹:通过三阶段训练 pipeline(流匹配预训练 → 蒸馏预热 → 对抗后训练),模型仅需 8 步 Ping-Pong 采样(反复去噪→轻微加噪)即可达到高质量输出。
- 速度提升:相比传统 ODE 求解器,推理步骤从 50 步缩减至 8 步,速度提升 6 倍以上,且音质不降反升。
3. 强大的音频编辑能力
- 音频修复(Inpainting):支持单段或多段替换,用户可指定掩码区域,模型将自然填补空白,过渡平滑。
- 因果延续(Causal Continuation):保留音频开头,向后无限延长,保持风格、节奏和音色的一致性,适合创作完整乐曲。
技术架构:SAME + DiT
Stable Audio 3 的高效性源于其两大核心组件的精妙设计:
1. 语义-声学自编码器(SAME)
- 超高压缩:通过 256 倍分块 + 16 倍 TRB 下采样,实现 4096 倍的音频压缩,将原始音频投影到紧凑的潜在空间。
- 多重损失优化:结合频谱重建、对抗损失、语义回归(音色/音高/立体声)及对比对齐损失,确保在极低维度下仍保留高保真音质和语义结构。
- 版本区分:Small 模型使用 SAME-S(1.08 亿参数),Medium/Large 使用 SAME-L(8.52 亿参数)。
2. 扩散 Transformer(DiT)
- 条件注入:通过 T5/Gemma编码文本,AdaLN 注入时长条件,局部加性条件处理修复掩码。
- 长序列优化:引入 64 个记忆嵌入(Global Memory Cache)和差分注意力机制,增强对长音频上下文的建模能力。
- 稳定性设计:采用 QK-RMSNorm 和 AdaLN-Single,确保训练和推理的稳定性和轻量化。
模型规格与性能表现
| 模型版本 | 参数量 | 最大时长 | H200 推理速度 (5s) | 开源状态 | 适用场景 |
|---|---|---|---|---|---|
| Small-Music | 4.59 亿 | 2 分钟 | ~0.44 秒 | ✅ 开源 | 纯音乐生成 |
| Small-SFX | 4.59 亿 | 2 分钟 | ~0.44 秒 | ✅ 开源 | 音效生成 |
| Medium | 14 亿 | 6 分 20 秒 | ~1.31 秒 | ✅ 开源 | 音乐+音效混合 |
| Large | 27 亿 | 6 分 20 秒 | ~1.80 秒 | ❌ 闭源 | 高精度专业创作 |
- 音频规格:立体声 44.1kHz。
- 硬件友好:
- MacBook Pro M4:Small 模型 CPU 运行 5 秒音频仅需 ~0.7 秒,CoreML 加速后可达 ~0.23 秒。
- RTX 3060/4060:Medium 模型显存占用仅 ~6.5GB,TensorRT 加速下极致快速。
训练数据与版权安全
- 完全授权数据:训练数据来自 AudioSparx(授权音乐库)和 Freesound(CC0/CC BY 协议),经过严格的版权检测过滤。
- 商业友好:用户拥有生成输出的所有权,可根据 Stability AI 社区许可证进行分发和商业化,无版权风险。
- 提示词优化:利用元数据和 AI 重写构建强文本对齐数据集,提升模型对复杂指令的理解能力。
局限性与未来展望
尽管表现卓越,Stable Audio 3 仍存在一定局限:
- 无人声支持:目前仅支持器乐和音效,无法生成歌唱或说话人声。
- 长音频一致性:超过 3 分钟的极长音频,语义连贯性略有下降。
- 编辑精度:修复边缘偶尔出现轻微过渡痕迹,暂不支持细粒度的指令式编辑(如“在第 10 秒加入鼓点”)。
© 版权声明
文章版权归作者所有,未经允许请勿转载。