在 AI 语音合成领域,单一模型往往难以同时满足高保真度、长文本稳定性、多角色对话及实时交互等复杂需求。MOSS-TTS 系列由 MOSI.AI 与 OpenMOSS 团队 联合开发,通过将工作流拆分为五个专门优化的生产级模型,提供了一套完整、灵活且开源的语音解决方案。
- GitHub:https://github.com/OpenMOSS/MOSS-TTS
- Hugging Face:https://huggingface.co/OpenMOSS-Team/MOSS-TTS-v1.5
- ModelScope:https://modelscope.cn/models/openmoss/MOSS-TTS-v1.5
最新发布的 MOSS-TTS v1.5 在多语言支持、克隆稳定性及韵律控制上实现了显著突破。
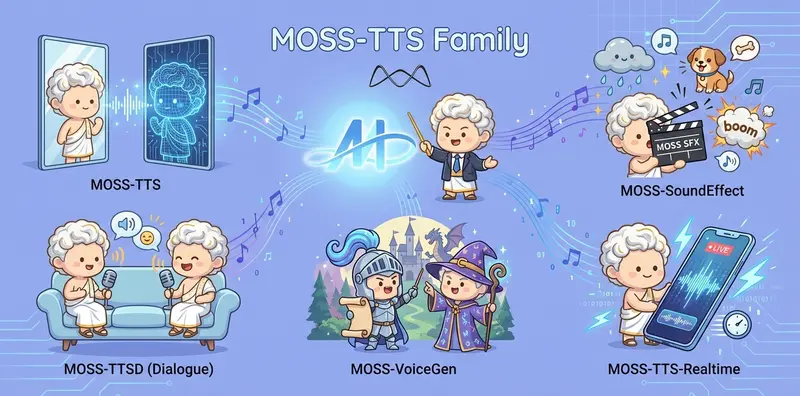
MOSS-TTS 系列:五大核心模型
1. MOSS-TTS:旗舰级生产模型
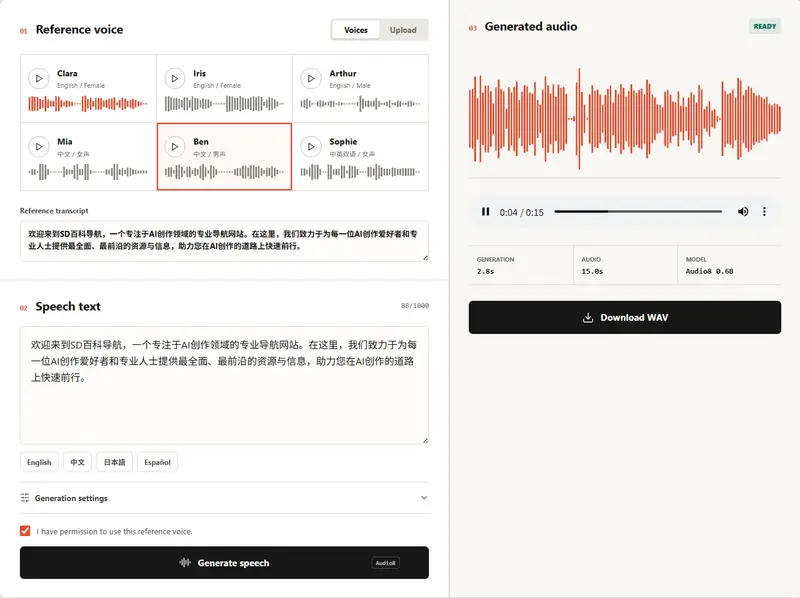
- 高保真克隆:具备业界领先的零样本语音克隆能力,相似度更高,方差更低。
- 精细控制:支持拼音、音素及时长的细粒度调整,完美处理多语言及语码转换。
- 长文本稳定:在数十分钟的长篇语音生成中保持音色与风格的高度一致。
2. MOSS-TTSD:口语对话生成专家
- 表现力卓越:专为多说话人、超长对话设计,情感丰富自然。
- 业界领先:v1.0 版本在客观指标上达到 SOTA,主观评测中优于 Doubao 和 Gemini 2.5-pro 等顶尖闭源模型。
3. MOSS-VoiceGenerator:纯文本语音设计
- 无需参考音频:仅通过文本提示即可生成多样化的语音风格和角色声音。
- 统一设计层:集语音设计、风格控制与合成为一体,可独立运行或作为下游 TTS 的前置模块。
4. MOSS-TTS-Realtime:实时智能体首选
- 极低延迟:首字节时间(TTFB)仅需 180 毫秒,配合 LLM 首句生成总延迟仅 377 毫秒。
- 上下文感知:采用增量合成技术,确保多轮对话回复自然连贯,是构建低延迟语音智能体的理想选择。
5. MOSS-SoundEffect:全能音效生成
- 广泛覆盖:支持自然环境、城市场景、生物声音、人类动作及音乐片段。
- 可控时长:适用于影视后期、游戏开发及互动体验中的音效创作。
MOSS-TTS v1.5 重大升级
相较于 1.0 版本,v1.5 在以下方面进行了深度优化:
- 31 种语言支持:
*   保留原有的 20 种语言,新增 **粤语、荷兰语、芬兰语、印地语、马其顿语、马来语、罗马尼亚语、斯瓦希里语、他加禄语、泰语、越南语**。
*   **建议**:构建消息时明确指定 `language` 标签(如 `language="French"`),以获得最佳合成效果。
- 更稳定的语音克隆:
*   提高说话人相似度,减少克隆结果的随机方差,确保重复生成的一致性。
*   优化了“长参考音频 + 短目标文本”场景下的表现,克隆更加可靠。
- 标点驱动韵律与显式停顿:
*   更严格地遵循标点符号引导的停顿,长句呼吸感更自然。
*   **支持内联停顿标记**:例如 `[pause 3.2s]`,可在指定位置插入精确时长的静音,实现戏剧化效果。
*   *示例*:`我今天学习了一首中国的古诗,它的名字是[pause 3.2s]静夜思!`
支持语言列表
| 语言 | 代码 | 语言 | 代码 | 语言 | 代码 |
|---|---|---|---|---|---|
| 中文 | zh | 粤语 | yue | 英语 | en |
| 阿拉伯语 | ar | 捷克语 | cs | 丹麦语 | da |
| 荷兰语 | nl | 芬兰语 | fi | 法语 | fr |
| 德语 | de | 希腊语 | el | 希伯来语 | he |
| 印地语 | hi | 匈牙利语 | hu | 意大利语 | it |
| 日语 | ja | 韩语 | ko | 马其顿语 | mk |
| 马来语 | ms | 波斯语 | fa | 波兰语 | pl |
| 葡萄牙语 | pt | 罗马尼亚语 | ro | 俄语 | ru |
| 西班牙语 | es | 斯瓦希里语 | sw | 瑞典语 | sv |
| 他加禄语 | tl | 泰语 | th | 土耳其语 | tr |
| 越南语 | vi |
MOSS-TTS 系列通过模块化设计,解决了传统 TTS 在复杂性、实时性和表现力上的局限。无论是需要高保真克隆的有声书制作,还是追求极低延迟的实时语音助手,亦或是需要丰富音效的游戏开发,MOSS-TTS 都能提供对应的专业模型。
© 版权声明
文章版权归作者所有,未经允许请勿转载。