Liquid AI 正式推出 LiquidCodec,一款专为流式语音处理设计的轻量级音频编解码器。作为其 LFM3-Audio-2B 和 LFM3-Omni-2B 模型的核心组件,LiquidCodec解决传统音频分词器在预测难度与转换速度之间的权衡问题。该模型参数量仅约 7400 万,却能在单个 CPU 线程上实现极高的处理效率,并已在 Hugging Face 上开源权重。
- Liquid-Codec:https://huggingface.co/LiquidAI/Liquid-Codec
- LFM3-Audio-2B:https://huggingface.co/LiquidAI/LFM3-Audio-2B
- LFM3-Omni-2B:https://huggingface.co/LiquidAI/LFM3-Omni-2B
核心架构:GFSQ 与并行预测
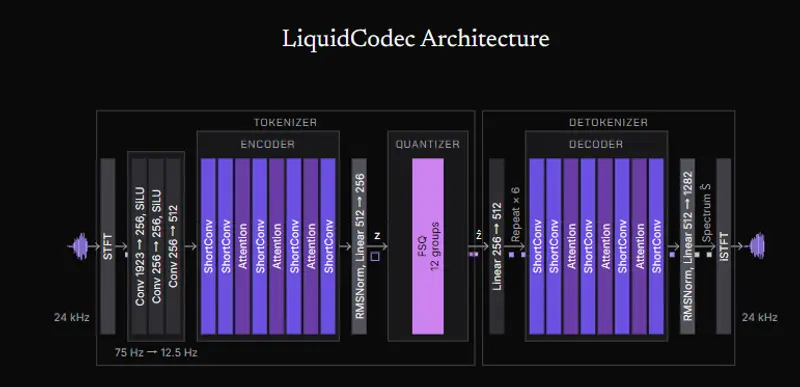
LiquidCodec 采用对称的编码器-解码器结构,均基于 Liquid AI 的 LFM3 架构模块构建,且编码器完全因果化以支持低延迟流式传输。其技术创新主要体现在量化与解码策略上:
- 分组有限标量量化 (GFSQ):取代了传统的残差向量量化 (RVQ)。在 RVQ 中,码本之间存在依赖关系(后一个码本编码前一个的残差),而 GFSQ 将 12 个码本分为独立组。这种独立性允许语言模型以 MaskGIT 风格并行预测所有 12 个码本的 Token,显著降低了预测复杂度。
- 直接频谱系数预测:解码器直接输出频谱系数,避免了波形解码器中常见的、计算成本高昂的学习型转置卷积上采样过程。
技术规格:
- 参数量:约 7400 万 (73.6M)。
- 音频格式:24 kHz 采样率。
- 帧率与码本:12.5 Hz 帧率(每 80ms 一帧),每帧生成 12 个离散 Token。
性能基准:速度与质量的双重突破
Liquid AI 在 Apple M4 Max MacBook Pro 的单 CPU 线程(FP32)上进行了速度测试,并在 8 个多语言数据集上评估了重建质量与 TTS 性能。
1. 极致的高效性
LiquidCodec 在推理速度上大幅领先于竞品(如 Mimi、NanoCodec 和 X-Codec 2)。实时因子 (RTF) 越低代表处理越快。
| 指标 | LiquidCodec | Mimi | NanoCodec | X-Codec 2 |
|---|---|---|---|---|
| 编码 RTF | 0.0028 | 0.0361 | 0.2145 | 0.7359 |
| 解码 RTF | 0.0115 | 0.0329 | 0.2543 | 0.0379 |
| 相对速度 | ~361x 实时编码 | ~28x | ~4.7x | ~1.4x |
注:LiquidCodec 的编码速度比 Mimi 快约 13 倍,解码速度快约 2.9 倍。
2. 卓越的重建与 TTS 质量
在 LibriSpeech test-clean、Seed-TTS(英/中)及 FLEURS(德/法/中/日/韩)等 8 个测试集上,LiquidCodec 表现优异:
- 重建质量:在所有测试集上获得最佳 ViSQOL 分数和最低 Mel 距离。例如在 LibriSpeech 上,ViSQOL 达到 4.319,优于 NanoCodec (4.219)、X-Codec 2 (4.119) 和 Mimi (4.031)。
- TTS 性能:在使用相同 TTS 模型架构和数据集训练的情况下,LiquidCodec 生成的 Token 在所有测试集上获得了最高的 UTMOSv2 分数。在 LibriSpeech 上,其词错误率 (WER) 仅为 3.15%,远低于 Mimi 的 6.27%。
局限性:
尽管综合表现领先,但 NanoCodec 在 8 个测试集中的 7 个里获得了更高的 PESQ (WB) 分数,且在 LibriSpeech 的说话人相似度 (SECS) 上略胜一筹 (0.836 vs 0.785)。
训练策略
LiquidCodec 的训练分为两个阶段:
- 预训练:使用 107 种语言的 264,000 小时语音数据,应用波形和频谱损失,未引入对抗损失。
- 微调:使用 55,000 小时全频带语音数据,引入对抗批评器进行微调,以消除预训练阶段留下的金属伪影。
- 量化感知训练 (QAT):最后进行仅解码器的 QAT,以优化边缘设备上的推理性能。
部署与集成
开发者可以通过多种方式部署 LiquidCodec:
- Python (Transformers):通过
trust_remote_code=True加载,支持 CUDA 和 bfloat16。原生LiquidCodecStreamingCache支持逐块解码。 - 边缘设备 (llama.cpp):提供 Q4_0、Q4_K_M 和 Q8_0 格式的 GGUF 构建。其中 Q4_0 量化配合仅解码器 QAT,可将解码器占用空间缩小 3.5 倍,而 LibriSpeech ViSQOL 仅从 4.319 微降至 4.292,质量损失极小。
LiquidCodec 的发布标志着流式音频处理向更高效、更轻量化的方向迈进,为在资源受限设备上运行高质量语音交互应用提供了新的基础组件。
© 版权声明
文章版权归作者所有,未经允许请勿转载。