Fish Audio 正式推出 Live 3,一款专为实时语音智能体设计的全双工(Full-Duplex)语音模型。与传统的半双工系统不同,Live 3 能够在说话的同时保持聆听状态,允许用户在通话过程中随时暂停、发出“嗯哼”等确认音或改变主意,而不会导致对话中断。对于开发者而言,Live 3 的核心价值在于将复杂的轮次转换(Turn-taking)逻辑从硬编码的规则管道转移至模型内部,通过数据驱动的方式实现更自然的交互时机控制。
- 地址:https://fish.audio/zh-CN/live3
核心技术:从规则阈值到数据驱动的时机判断
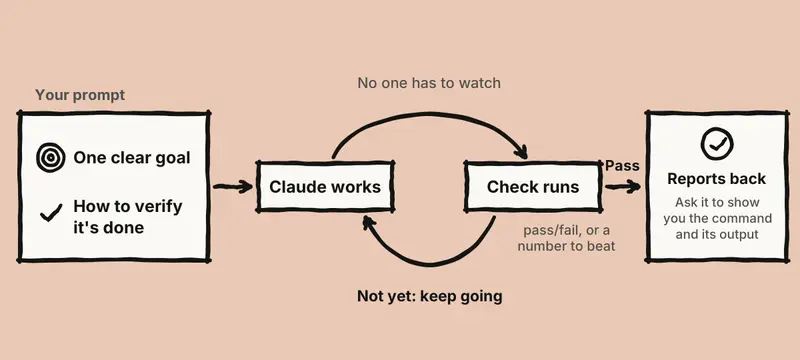
传统语音智能体通常将语音识别、推理、语音合成和轮次管理分散在独立的管道阶段,依赖静音检测阈值来判断用户是否说完。这种机制往往难以区分“思考时的停顿”与“话轮结束的停顿”,导致智能体在不恰当的时机插话或等待过久。
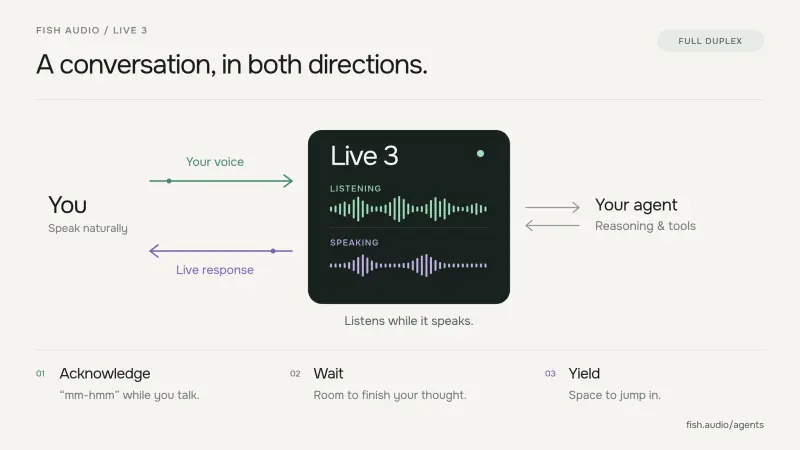
Live 3 通过在真实人类对话数据上进行训练,学习了何时确认、何时等待、何时回应以及何时停止。其架构将对话时机判断内嵌于语音模型中,而将指令遵循和工具调用保留在单独的推理层。
Live 3 展示的三种典型交互行为:
- 确认而不接管:当用户分段报出电话号码(如“415… 555…”)时,Live 3 会在片段间插入简短确认(如“好的,415”),随后继续等待,而非强行结束当前话轮。
- 区分附和与打断:能够精准识别用户意图。例如,用户说“是的”表示让智能体继续;而说“等等,其实我只需要周四”则触发智能体立即停止当前输出。
- 等待纠正:面对用户的自我修正(如“两个披萨……不,三个”),Live 3 会保持监听状态,等待最终指令,而非记录错误的初始信息。
性能指标与延迟表现
Fish Audio 强调速度与时机是两个独立维度。Live 3 能够在极短的时间内对简短反应做出决策:
- 最短响应时间:针对“嗯哼”、“好的”等简短确认音,决策延迟低至 186 毫秒。
- 并行处理:完整的答案回复在后台并行准备,确保长回复的流畅性。
- 基准缺失:目前 Fish Audio 尚未发布详细的延迟分布数据或第三方基准测试分数(如 Artificial Analysis)。截至 11 月 11 日,OrcaRouter 等跟踪器也未收录相关评分。
部署方案与 API 集成
Live 3 支持多种部署方式,包括托管的 Fish Agent Platform、Fish Audio API 以及面向企业的本地部署方案。
| 部署/接入方式 | 说明 |
|---|---|
| REST API | 智能体通过 /v1/agent/* 接口暴露服务。 |
| 浏览器会话 | 支持通过 @fishaudio/agent-client 或 @fishaudio/agent-react 库集成。 |
| 通信渠道 | 支持接听电话号码、WebRTC 连接以及网站小组件嵌入。 |
| 声音库 | 提供超过 200 万种库声音,支持声音克隆。 |
| 配置启用 | 通过设置 voice.engine: "live3" 启用,此时语音识别固定为 fish_audio:transcribe-stream-1。 |
定价策略
Fish Audio 为 Live 3 提供了极具竞争力的 introductory 定价,直至 2026 年 12 月 31 日享受五折优惠:
- 基础费率:$0.035/分钟(原价 $0.07/分钟)。该费用涵盖 STT、TTS、基础 LLM、知识检索及工具调用。
- 电话附加费:每分钟加收 $0.01。
- 号码月租:每个电话号码 $1.20/月。
- 试用余额:新注册账户可获得 $5 试用额度。
局限性与注意事项
- 语言支持:目前仅支持英语。
- 基准透明度:缺乏公开的第三方性能基准对比,开发者需通过实际测试评估其在特定场景下的表现。
- 重叠分类:模型需自行判断音频重叠属于“打断”还是“确认”,这对复杂噪音环境下的鲁棒性提出了更高要求。
Live 3 的发布标志着实时语音交互从“基于规则的流水线”向“基于模型的整体感知”迈进了一步,为构建更拟人化、低延迟的电话及网页智能体提供了新的技术底座。
© 版权声明
文章版权归作者所有,未经允许请勿转载。