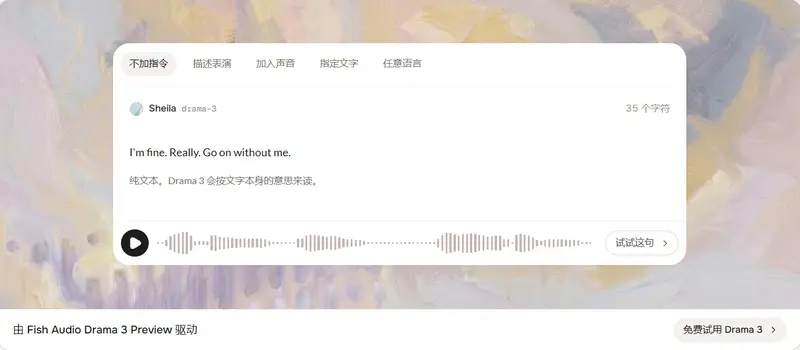
Fish Audio发布Drama 3 :情感表现力升级TTS,发音稳健性榜单第一,权重开源Fish Audio 正式推出 Drama 3,是该系列情感表现力最强的文本转语音模型,相比前代 S2.1 Pro 情感层次大幅提升;在 Artificial Analysis 发音稳健性评测拿到第一...语音模型# Drama 3# Fish Audio2周前310
Fish Audio 发布 S2.1 Pro:90ms 超低延迟,支持 83 种语言与实时语音克隆在 AI 语音领域,速度就是生命。 Fish Audio 今天正式推出了其最新的生产级 TTS 模型 S2.1 Pro。这款模型不仅将首次音频输出时间压缩至约 90 毫秒,更支持 83 种语言和高质量...语音模型# Fish Audio# S2.1 Pro3个月前920
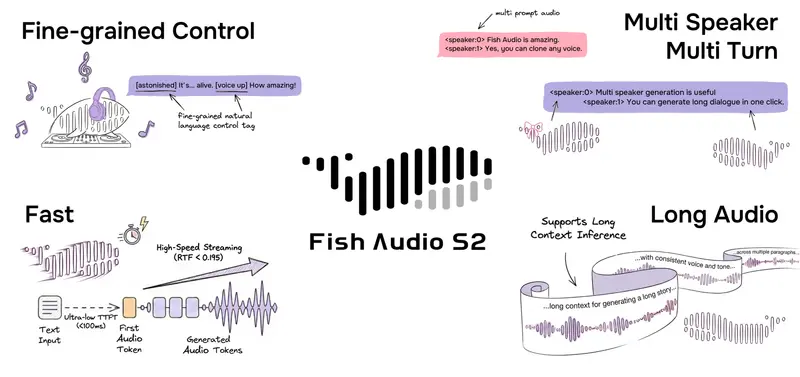
Fish Audio 开源 Fish Audio S2 Pro:支持自然语言指令的精细化 TTS 模型,单卡 H200 实时因子低至 0.195在文本转语音(TTS)领域,如何在保持高保真音质的同时,实现对韵律、情感和副语言特征(如笑声、呼吸声)的精细化控制,一直是行业难点。今日,Fish Audio 正式开源 S2 模型及其完整的生产级推理...语音模型# Fish Audio# Fish Audio S2 Pro8个月前2310
Fish Audio 发布 OpenAudio S1-mini:支持 14 种语言、50+ 情感语气的开源 TTS 模型文本转语音(TTS)领域迎来一位重量级开源选手 —— OpenAudio S1-mini。 这是由 Fish Audio 团队 推出的 S1 模型的轻量化版本,参数规模为 5亿(0.5B),基于超过 ...语音模型# Fish Audio# OpenAudio S1-mini# TTS 模型1年前1,1440
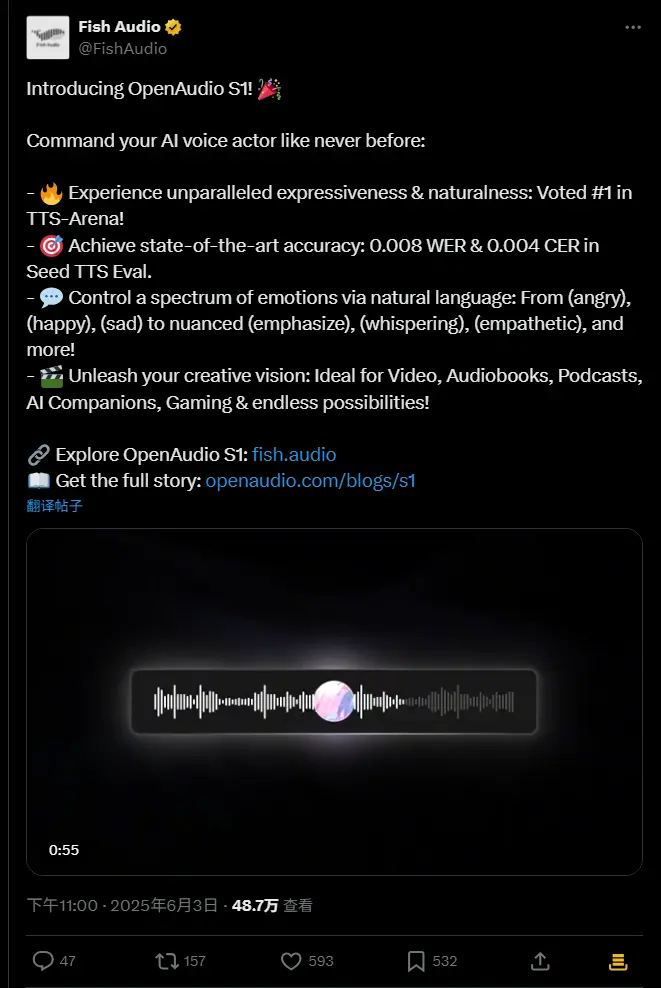
OpenAudio S1:Fish Audio 推出媲美语音演员的尖端文本转语音模型Fish Audio 重磅推出 OpenAudio S1 —— 一款在表现力、自然度和可控性方面达到新高度的文本转语音(TTS)模型。作为目前全球最先进的开源 TTS 模型之一,S1 在超过 200万...语音模型# Fish Audio# OpenAudio S1# TTS模型1年前7110