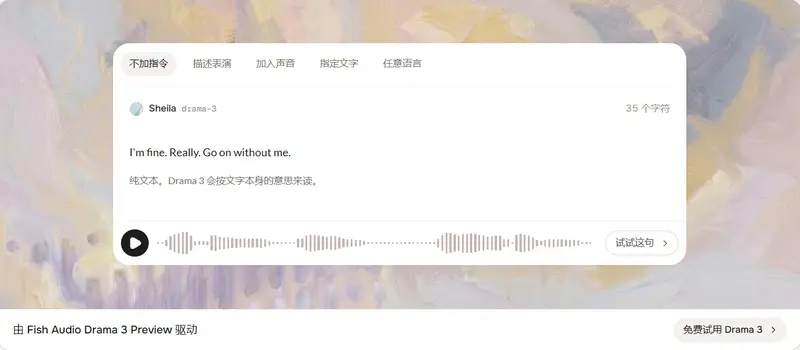
Fish Audio 正式推出 Drama 3,是该系列情感表现力最强的文本转语音模型,相比前代 S2.1 Pro 情感层次大幅提升;在 Artificial Analysis 发音稳健性评测拿到第一名,现已在网页端、移动端App、API同步上线。
- 官方介绍:https://fish.audio/zh-CN/blog/fish-audio-drama-3/
- 模型:https://huggingface.co/fishaudio/drama-3
核心能力亮点
- 强情感指令跟随
采用方括号内的演员式指令写法,可以精准实现哭腔、隐忍愤怒、强装镇定的笑声、低语等效果,一句话中间也能切换情绪,不再抹平戏剧化的声音细节。
训练上的关键改进:改用人类偏好奖励模型做强化学习,不会因为模型输出笑声、哽咽这类戏剧声音而扣分,解决旧版TTS为了“好转录”压制情感的老问题。
- 发音准确率大幅提升
Artificial Analysis 发音稳健性基准测试:整体93.2%(S2.1 Pro为88.1%)
| 测试类别 | Drama3 | S2.1 Pro |
|---|---|---|
| 品牌名、地名、专业术语 | 95.9% | 87.3% |
| 多音歧义单词 | 95.3% | 86.1% |
| 数字、日期、单位符号 | 93.6% | 92.7% |
| 代码、路径、邮箱 | 86.3% | 79.4% |
模型架构细节
Drama3 是 35B 参数 MoE 混合专家模型,每token仅激活约3B参数,基于Qwen3.5-35B-A3B初始化:
- 40层混合注意力结构,Gated DeltaNet + 少量全注意力层,DeltaNet携带长时序历史,节约KV缓存
- Codebook-MTP全新音频解码器,替代S2的Fast AR,回溯全文+参考音频,还原声音精细纹理;采用部分码本融合,降低曝光偏差
- 音频编解码:44.1kHz,10个码本,每秒21.5帧,完全因果
- 训练流程:三阶段预训练 → 指令微调 → GRPO强化学习(人类偏好奖励模型,无KL惩罚)
- 推理性能:单张H200上单流解码271帧/秒,S2仅177帧/秒,模型规模提升7倍,推理速度反而更快;依托SGLang-Omni部署
适用场景
主打一次性生成、长期存档的剧本音频:有声书、广播剧、小说播客、游戏/动画对白、短视频故事配音。
后续还在邀测两大配套能力:交互式语音编辑(直接口述调整已有音频的情绪强弱)、音频补全Audio Inpainting(只替换修改的台词,保留前后音色节奏不变),配套编辑API也即将推出。
开源许可与商用规则
权重开源,遵循 Fish Audio Community License v1.0:
- 研究、非商业:免费
- 年收入低于50万美元的主体,可免费商用
- 年收入超过限额,或是将模型封装对外提供TTS/语音克隆推理服务,需要单独向Fish Audio申请授权
- 协议禁止未经许可克隆真人声音;S2系列沿用旧的Fish Audio Research License
上线优惠(10.13–11.12)
- API:原价$50/百万字符,活动2折,$10/百万字符
- 创作者订阅:新订阅享5折(月订阅首月/年订阅首年)
- 额外福利:发布帖48小时内评论,赠送1个月Fish Audio Plus
© 版权声明
文章版权归作者所有,未经允许请勿转载。