小米推出Dasheng音频大模型家族新成员 MiDashengLM-Spatial,完整开放模型权重与推理代码,采用Apache 2.0开源许可证。该模型是业界首个开源端到端空间音频理解大模型,在原有声音识别基础上增加声源空间方位感知能力。
- 项目主页:https://jinbo-hu.github.io/midashenglm-spatial-demo/
- GitHub: https://github.com/xiaomi-research/midashenglm-spatial
- 模型:https://huggingface.co/mispeech/midashenglm-spatial
模型基础与能力
模型以MiDashengLM-7B作为基座。此前小米Dasheng系列已经拥有声音基座模型、声音理解大模型,可统一处理语音、环境音、音乐,已经在智能家居、汽车座舱落地30余项应用。
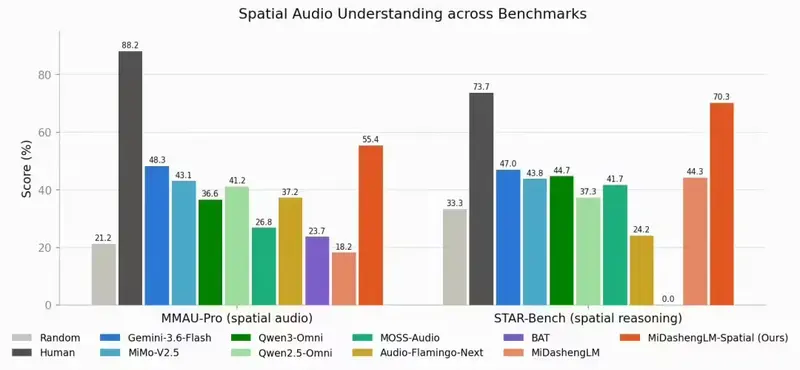
MiDashengLM-Spatial在原有音频理解能力之上新增空间听觉推理:不只识别声音是什么内容,还能判断声源位置、声音空间分布,把音频大模型从单纯“识别声音”升级到理解声音所处空间环境。
开源与落地规划
- 开源范围:完整权重+推理代码,Apache 2.0许可,可商用。
- 落地场景:后续将部署在小米智能家居、汽车座舱,赋能人车家全生态交互,借助空间听觉信息优化设备感知与交互决策。
© 版权声明
文章版权归作者所有,未经允许请勿转载。