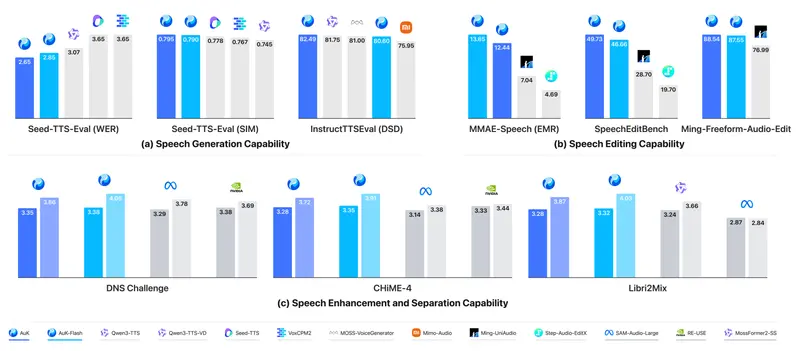
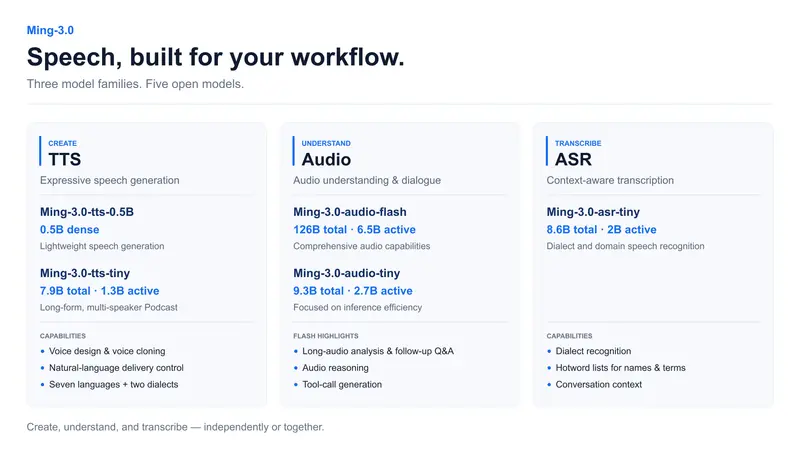
蚂蚁百灵(inclusionAI)今天开源了 5 个 Ming-3.0 模型。该系列跨越语音合成(TTS)、语音识别(ASR)和音频理解(Audio)三个家族,为会议、采访、客户通话及语音驱动服务提供完整的音频处理解决方案。
- Hugging Face:https://huggingface.co/collections/inclusionAI/ming-30
- 魔搭:https://modelscope.cn/collections/inclusionAI/Ming-30
语音合成(TTS)系列
该系列包含两个模型,均支持多语言合成、四川话及粤语等方言控制,并提供 100 多个内置中文声音和 5 个内置英文声音。
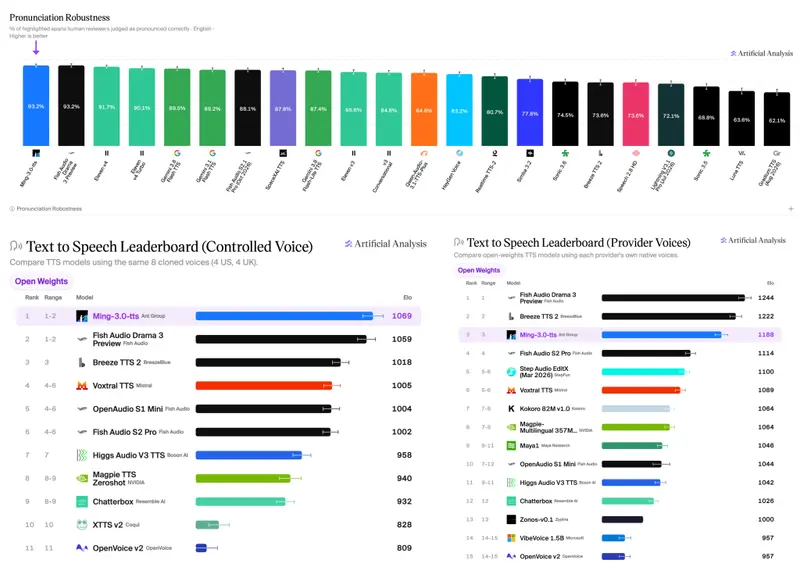
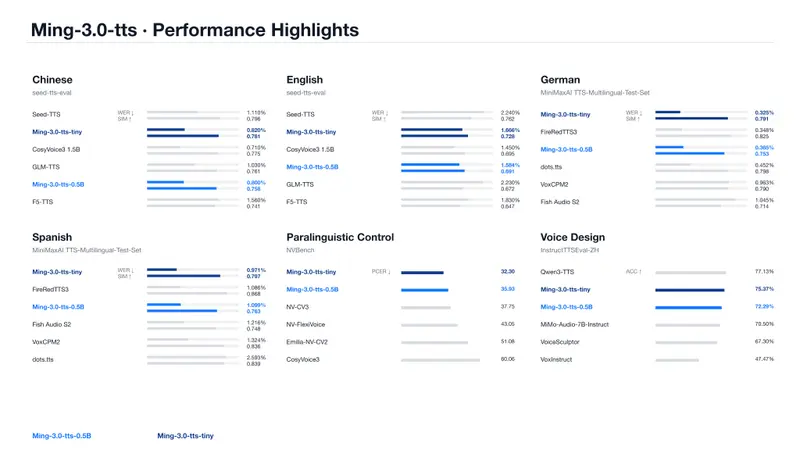
Ming-3.0-tts-0.5B 是一个密集的 0.5B 参数模型,基于 Qwen2.5-0.5B 构建。它支持从短参考片段进行零样本声音克隆,或通过自然语言描述直接设计说话人声音。模型提供显式的情感、速度、音高和音量控制,并内置 14 个内联标签,用于在中文或英文合成中精准插入呼吸、咳嗽、叹息、笑声、犹豫及惊讶等副语言线索。
Ming-3.0-tts-tiny 是一个 7.9B 总参数(每 token 激活约 1.3B 参数)的混合专家(MoE)模型,基于 Ling V3 骨干构建。除了具备 0.5B 版本的所有控制能力外,它还专门针对长篇语音和多说话人场景进行了优化,支持从脚本和说话人参考中生成多说话人对话,适用于播客等复杂场景。
语音识别(ASR)系列
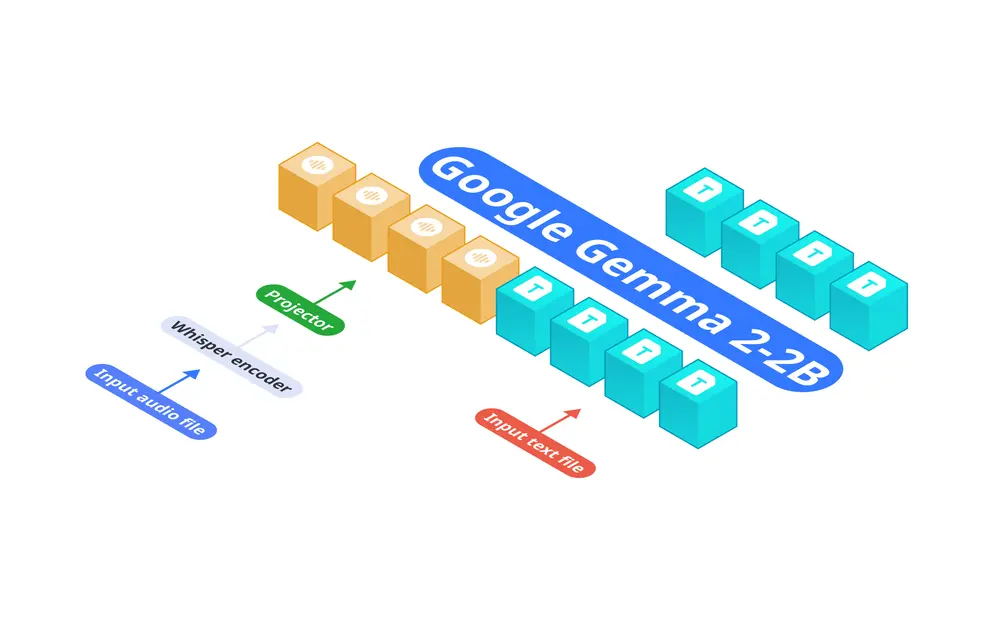
Ming-3.0-asr-tiny 结合了 Ling-tiny-v3 语言骨干与音频编码器,总参数 8.6B(激活 2B),专注于上下文感知的语音识别。
该模型通过单一接口支持中文和英语的单轮语音转录,并在 15 个地区方言测试集(包括粤语、闽南语和上海话)上进行了评估。其核心优势在于上下文感知能力:用户可以将相关热词或先前的对话内容作为提示输入,从而在不进行额外训练的情况下,显著提升领域特定术语的识别准确率。在嘈杂语音和五个特定应用领域的测试中,该模型在四个 ASR 类别上的平均错误率为 4.41%。
音频理解(Audio)系列
该系列包含两个原生音频语言模型,均接受音频和文本指令,支持语音识别、口语问答、音频理解、音频推理,并可选择性地用内置或参考声音合成语音进行响应。
Ming-3.0-audio-flash 参数量达 126B(激活 6.5B)。它能够处理复杂语音环境(如方言、口音、嘈杂背景和多说话人录音),理解和分析长篇录音,并对语音、非语音声音、声学场景和音乐进行多维感知。此外,它还能生成工具请求供外部应用执行,适合需要深度推理和复杂任务调度的场景。
Ming-3.0-audio-tiny 是一个 9.3B 总参数(激活 2.7B)的紧凑 MoE 模型。它在保持与 Flash 版本相同的核心能力(复杂语音识别、长音频理解、多维感知和音频推理)的同时,提供了更高效的部署选项,适合对计算资源有限制但仍需完整音频智能交互能力的场景。
所有开源仓库均包含了模型权重、分词器、音频编码器以及可运行的推理示例代码,开发者可直接基于这些组件构建端到端的音频处理工作流。
© 版权声明
文章版权归作者所有,未经允许请勿转载。