IBM 发布了 Granite Speech 5.0 2B,这是一款全新的开源语音语言模型,专注于多语言语音转录与翻译。该模型在 Apache 2.0 许可证下发布,支持将 6 种语言的语音转化为文本,为开发者提供了高精度、快速设备端转录以及带说话人归属的转录能力。
- 模型:https://huggingface.co/ibm-granite/granite-speech-5.0-2b
架构与训练机制
Granite Speech 5.0 2B 是一个包含 20 亿参数的密集模型。其架构由三个核心部分组成:
- 语音编码器:包含 16 个 Conformer 块,采用 CTC(连接时序分类)训练,并对 4 秒音频块使用块注意力机制。
- 投影与降采样:通过 2 层窗口 q-former 对声学嵌入进行投影和降采样,总降采样率为 10 倍,使 LLM 以 10 Hz 的频率接收嵌入。
- LLM 骨干:基于 granite-4.0-1b-base 的中间检查点,利用 YaRN 技术将上下文窗口扩展至 16k 位置,并通过 LoRA 适配器进行微调。
该模型在 8 块 H100 GPU 上训练了 40 天,使用了 39 万小时的公共音频及合成数据,其中合成数据专门针对日语 ASR、关键词偏置和翻译任务进行了优化。
核心升级与性能表现
相较于前代 Granite Speech 4.1 2B,5.0 版本引入了多项关键改进:支持在提示中指定语言 ID、提供最多 2,000 个术语的关键词列表以偏向特定输出、支持按需生成标点与大小写,并显著增强了在噪声、混响和远距离麦克风环境下的鲁棒性。
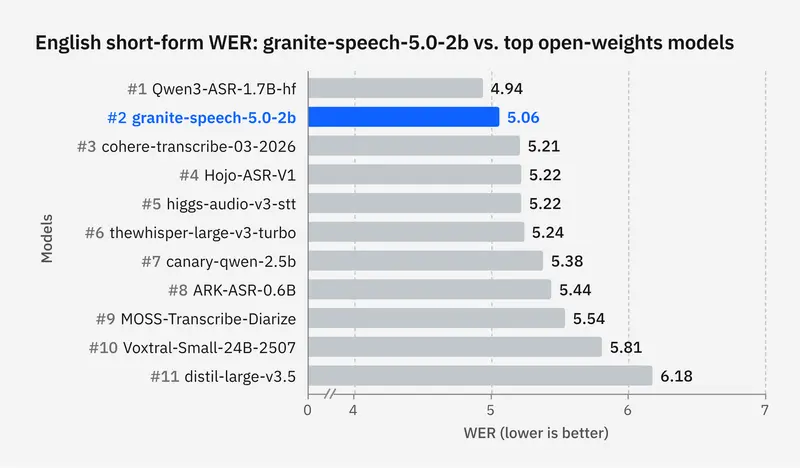
在基准测试中(截至 2026 年 10 月 21 日),该模型在 Open ASR 排行榜上位列第二的开源权重模型,平均英语词错误率(WER)为 5.68%。具体表现如下:
- 最佳表现:在 LibriSpeech Clean 数据集上 WER 低至 0.99%,LibriSpeech Other 上为 2.21%。
- 多语言与翻译:CommonVoice 测试中,葡萄牙语 WER 为 2.60%,西班牙语为 3.50%,日语为 10.74%。在 X 到英语的 CoVoST 翻译测试中,葡萄牙语 BLEU 达到 53.6,德语达到 40.1。
- 关键词偏置:在 Earnings-22 数据集上,使用正确关键词列表时,关键词 F1 分数从 67.2 飙升至 90.1;即使混合正确与错误术语,仍能达到 82.8。
- 局限性:在私人对话集上 WER 为 13.79%,在嘈杂的 FFASR 排行榜上平均 WER 为 14.80%(排名第四),略逊于 Qwen3-ASR-1.7B。
配套模型更新
伴随 5.0 版本的发布,IBM 还更新了两款现有模型:
- Granite Speech 5.0 Turbo CTC:保持 4.7 亿参数规模,现支持 7 种语言及原生标点与大小写。通过图重用优化,吞吐量大幅提升至 19,870 RTFx。
- Granite Speech 4.1 2B Plus:作为直接替换的权重更新,平均时间戳偏移从 210.86 降至 98.54,长格式 WER 从 13.53 降至 10.22,偏置关键词 WER 从 11.79 降至 6.48。
部署建议
Granite Speech 5.0 2B 支持多种推理框架,包括 Transformers、vLLM(GPU)、mlx-audio(Apple 芯片)以及 llama.cpp(本地 CPU/Mac)。对于 GGUF 格式,IBM 官方推荐使用 Q8_0 量化版本。需要注意的是,较低比特的量化在处理超过 1 分钟的音频时会出现准确性损失,因此在长音频场景下应谨慎选择量化级别。模型建议处理的音频片段长度约为 2 分钟以内。
© 版权声明
文章版权归作者所有,未经允许请勿转载。