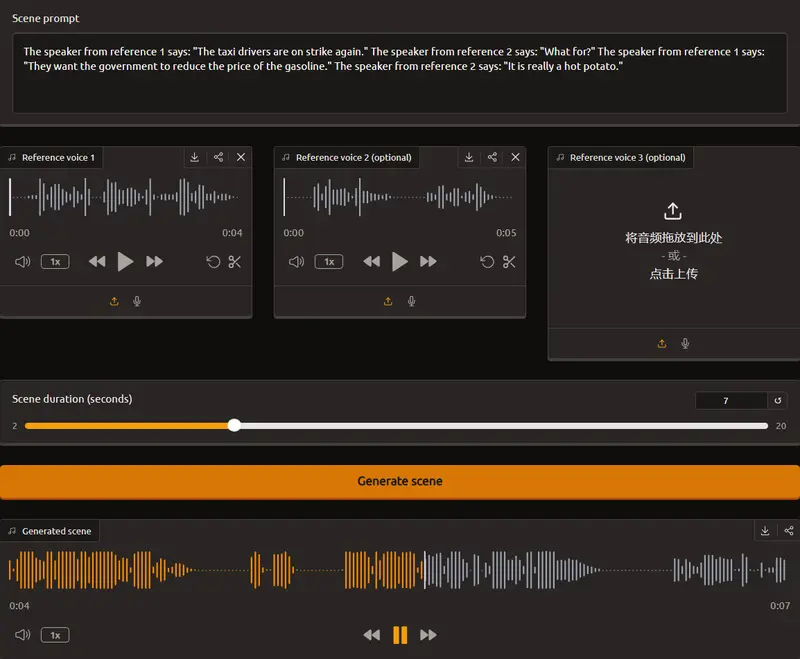
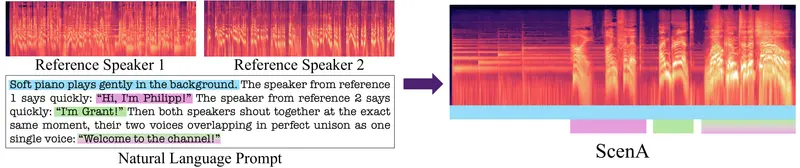
Lightricks与特拉维夫大学联合推出ScenA,一种无需结构化脚本、仅凭自由文本描述+多段参考语音即可生成完整多人对话音频的AI框架。其核心创新在于将流匹配基础模型(预训练于大规模野外数据)直接条件化于自然语言场景提示与参考潜变量,继承真实环境纹理(背景噪声、房间声学、重叠对话、副语言事件),同时通过高噪声偏置时间步分布解决“参考捷径”问题——迫使模型依赖文本而非声学相似性进行说话人绑定。
- 项目主页:https://finmickey.github.io/scena
- GitHub:https://github.com/finmickey/scena
- 模型:https://huggingface.co/mifinkelson/scena
- Demo:https://huggingface.co/spaces/hugging-apps/scena-audio-scene-demo
在CoVoMix2-Dialogue基准上,ScenA在说话人绑定指标上优于现有系统,且生成包含重叠语音、情感发声与环境声音的丰富音频。架构轻量,仅需新增身份感知位置编码模块,部署成本低。
核心技术突破:从结构化监督到野外先验
传统多说话人系统的局限
| 方法 | 输入要求 | 输出缺陷 |
|---|---|---|
| 逐轮标签/多流转录 | 严格结构化脚本 | 干净语音序列,缺乏环境纹理 |
| 可学习说话人嵌入 | 需预定义说话人ID | 朗读式语音,无重叠/副语言 |
| 分段生成+拼接 | 手动拆分台词 | 人工痕迹重,声场不连贯 |
ScenA的范式转变
- 自由形式条件化:单段自然语言描述整场对话(如“两人在海边咖啡馆争论,参考1是女性,参考2是男性”),无需拆分台词或标注轮次
- 野外先验继承:基础模型在真实录音数据上预训练,天然生成非录音室音质(环境噪、混响、自发语气词)
- 参考潜变量拼接:多段参考语音转为潜变量后接入token序列,通过轻量级身份感知位置编码区分说话人
- 反捷径训练:标准噪声调度下模型易通过声学相似性绕过文本;ScenA采用高噪声偏置分布,使中间态几乎无原始音色,强制依赖文本分配说话人
关键机制详解:如何解决“参考捷径”
问题本质
在扩散/流匹配训练中,中等噪声水平下目标音频仍保留显著声学特征。模型发现“参考语音与目标片段声学相似”比“理解文本指令”更容易优化损失,导致测试时说话人错乱。
ScenA解决方案
- 高噪声偏置时间步采样:训练时大幅增加高噪声阶段比例,此时目标音频接近纯噪声,声学线索失效,模型必须从文本提取说话人信息
- 干扰人声注入:随机混入无关说话人参考,增加声学匹配难度
- 参考顺序扰动:随机调换参考语音在序列中的位置,防止模型依赖固定位置编码
消融实验验证
- 噪声偏置越强 → 说话人绑定准确率越高
- 移除干扰注入/顺序扰动 → 性能显著下降
- 证明三要素协同解决捷径问题,非单一技巧
© 版权声明
文章版权归作者所有,未经允许请勿转载。