英伟达发布了 NemotronLabs VoiceChat 11B,这是一个开放的端到端语音到语音模型。它抛弃了传统的“语音识别 (ASR) → 大语言模型 (LLM) → 语音合成 (TTS)”级联架构,转而采用统一的混合 Mamba/Transformer 网络进行流式处理。
- GitHub:https://github.com/NVIDIA-NeMo/Speech/tree/nemotron-labs-voicechat
- 模型:https://huggingface.co/nvidia/NVIDIA-NemotronLabs-VoiceChat-11B
这种设计将平滑轮换响应延迟降低到了 448 毫秒,并支持真正的“全双工”交互:用户可以在 AI 说话时随时插话,AI 会立即停止并倾听。此外,它是首个支持在对话过程中实时调用工具的开放全双工模型。
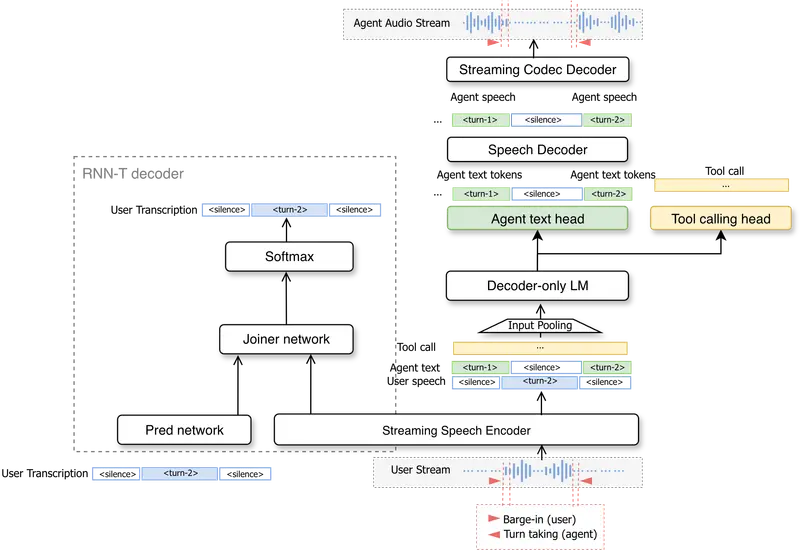
核心亮点
- 极致低延迟:端到端延迟仅 448ms,打断接管时间 480ms,接近真人对话节奏。
- 无静默工具调用:通过独立的
<TOOLCALL>侧通道执行 API 请求,并利用操作员定义的“等待语句”填补 API 运行时的空白,避免对话陷入尴尬的沉默。 - 开放权重:采用 OpenMDW-1.1 宽松许可证,权重和容器均已公开。
- 统一架构:集成了 Fast Conformer 语音编码器、Nemotron Nano v2 LLM 骨干和 TTS 解码器,无需多模型编排。
部署门槛与现状
虽然模型是开放的,但目前仅适用于研究和试点,尚未达到生产级稳定性。
- 硬件要求极高:需要至少 80 GB 显存的 GPU(如 A100, H100, RTX 6000 Pro 或 B200)。
- 已知缺陷:存在两分钟音频上下文上限、多轮对话后可能胡言乱语、对话结束后失控自言自语以及用户转录漏词等问题。
- 无托管 API:目前没有任何云厂商提供该模型的托管服务,团队必须自有高性能 GPU 才能评估。
适用场景
尽管有局限,它在以下领域具有巨大的探索价值:
- 联络中心与客服:支持自然插话的语音代理。
- 车载助手与零售点餐:需要极低延迟和自然交互的场景。
- 游戏 NPC:实现更逼真的实时对话。
- 内部工具前端:作为查询天气、订单状态等内部 API 的语音入口。
性能表现
- Full-Duplex-Bench 1.0:在开放全双工模型中排名第 2。
- 工具调用能力:在 AU Harness BFCL-v3 口语工具调用基准中,平均得分为 56.1%。虽然参数准确率(44.2%)仍有提升空间,但在简单工具选择上达到了 82.5%。
© 版权声明
文章版权归作者所有,未经允许请勿转载。