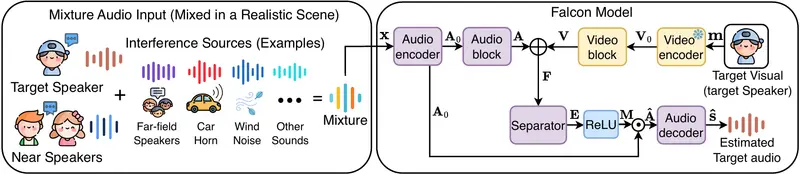
清华团队近期开源了因果音视频目标说话人提取(Audio-Visual Target Speaker Extraction, AVTSE)模型 Falcon。该模型能够在多说话人的嘈杂环境中,实时提取指定人物的语音。其核心机制是“根据视觉信息有选择地听取”,即通过摄像头捕捉目标人物的嘴部特征,将其与麦克风采集的混合音频进行时空对应,从而精准分离并提取目标语音。
- 项目主页:https://cslikai.cn/Falcon
- GitHub:https://github.com/JusperLee/Falcon
- Falcon Studio:https://github.com/JusperLee/Falcon/blob/main/studio/README_zh.md
- Falcon:https://huggingface.co/JusperLee/Falcon
- Falcon-Big:https://huggingface.co/JusperLee/Falcon-Big
- Demo:https://huggingface.co/spaces/JusperLee/Falcon-Studio
这种视听结合的能力若具备足够的准确度、低延迟与低功耗,即可作为基础组件广泛应用于视频会议、智能眼镜、机器人以及语音 Agent 等对延迟高度敏感的场景。
技术架构与性能指标
现有的因果 AVTSE 系统面临两个主要工程缺口:一是常用基准通常将说话人数固定为两人,忽略了近场/远场干扰、混响和突发噪声等复杂真实场景;二是高性能的因果架构对边缘设备而言计算负荷过重,而轻量级方案往往依赖多次调用小型分离器来弥补容量,这反而抵消了原本节省的计算资源。
Falcon 针对上述问题进行了架构优化,具体技术特性与性能数据如下:
- 单次前向分离机制:Falcon 是一个因果 AVTSE 框架,其内部的 AudioBlock 能够在单次编码器–解码器前向传播中,完成多尺度时频分离,避免了多次调用带来的延迟累积。
- 编码器空间说话人对比损失:引入该损失函数可有效抑制近场串音。该设计不增加任何额外的推理开销,且具备良好的迁移性,可应用于其他主干网络。
- 极低的参数量与计算开销:模型仅包含 0.5 M(50万)可训练参数。
- 与因果 AV-TF-GridNet 基线相比,Falcon 的参数量减少 91.9%,计算量降低 20.2 倍,GPU 推理延迟降低 11.1 倍。
- 与同为 50 万参数规模的 Swift-Net-12 相比,Falcon 的 GPU 延迟降低约 70%,计算量减少约 77%。
- 基准测试表现:在 RealSSA、LRS2-2Mix、LRS3-2Mix 和 VoxCeleb2-2Mix 数据集上均取得最优效果,并具备在普通笔记本电脑上实时运行视频会议应用的能力。
工程落地与应用工作流
为降低使用门槛,研究团队配套开发了 Falcon Studio。该工具支持在本地笔记本电脑上直接运行,其标准工作流如下:
- 视觉追踪:调用本地摄像头,实时追踪目标人物的嘴部区域。
- 语音提取:模型根据视觉特征,从麦克风输入的混合音频中定向提取目标人声。
- 音频路由:提取后的纯净语音可直接输出至本地耳机,或通过虚拟音频设备(Virtual Audio Device)路由至腾讯会议、Zoom 等第三方会议软件。
这使得定向聆听功能能够无缝嵌入真实的在线会议流程,无需依赖云端处理,保障了数据隐私与实时性。
RealSSA 基准数据集详解
为评估模型在复杂环境下的表现,团队发布了真实感模拟场景的 AVTSE 基准 RealSSA。该基准包含近场/远场干扰语音,并配有真实录制的评测集,由两个互补的数据集组成:
| 数据集 | 内容与场景 | 数据划分 | 获取与使用条件 |
|---|---|---|---|
| RealSSA-Sim | 模拟场景:包含 small_meeting(小型会议)、medium_indoor(中型室内)、large_public(大型公共)、outdoor(户外)四类场景。使用静态声源,包含近场/远场干扰语音、环境噪声与突发事件。提供 4 通道 16 kHz 混合语音与目标语音、RGB 嘴部裁剪及场景元数据。 | 训练集:100,826 条 验证集:9,133 条 测试集:9,169 条 | 需申请访问并经人工审核。遵循 CC BY-NC-ND 4.0 协议及各数据来源条款。以 240 个 WebDataset TAR 分片形式发布。 |
| RealSSA-Real | 真实录制场景:提供双声道 16 kHz 音频、25 fps 目标人脸视频、嘴部裁剪、关键点、说话人注册语音和录音级转写。涵盖 10 位说话人、8 种场景,共 83.99 分钟。 | 仅作为测试集使用(另有包含 34 段录音的原始录音视图供参考)。 | 需申请访问并经人工审核。严格遵守数据卡中的科研使用条件。 |
数据集使用注意事项:
- 注册语音的性质:数据集中提供的“注册语音”是独立的说话人参考音频,并非可用于 SI-SDR(尺度不变信噪比)计算的时间对齐干净目标信号。
- 加载器适配:发布的多通道分片数据需要经过适配处理,才能用于当前的单声道、目录式训练加载器。
- 源路径限制:Sim 元数据中的源路径仅用于追溯生成输入的过程,不提供可直接下载的近场说话人原始波形文件。若进行原始说话人对比训练,需自行准备这些源信号。
- 许可声明:代码和模型权重的开源许可,不替代数据集本身的访问与使用条款,使用者需单独遵守数据集的授权协议。
建议在下载和使用前,详细阅读官方提供的数据卡,其中包含具体的下载流程、文件格式说明、通道选择策略、时间对齐方法及推理示例代码。
© 版权声明
文章版权归作者所有,未经允许请勿转载。