日本 Third Intelligence 近期发布了日语语音识别模型 Haas-ja-v1.0,并将其作为开放模型公开。该模型的开发旨在推动普及型 AGI 的落地,促进 AI 与人类建立信任关系并实现丰富共生的社会。
- GitHub:https://github.com/third-intelligence/Haas-ASR
- 模型:https://huggingface.co/third-intelligence/Haas-ja-v1.0
Haas 这一名称具有双重含义:它既是 “Hear Anything At Speed”(以极快速度聆听万物)的首字母缩写,也是对声学家 Helmut Haas 的致敬,后者提出了在立体声学等领域广泛应用的“哈斯效应”(优先效应)。
核心架构与参数配置
Haas-ja-v1.0 基于 NVIDIA 的 Parakeet-TDT 架构构建,由 FastConformer 编码器与 Token-and-Duration Transducer (TDT) 解码器组成。其在架构上的核心改进在于预测网络的设计:
- TDT 解码机制:TDT 在传统 RNN-T(循环神经网络变换器)的基础上进行了扩展,增加了对每个 token 持续时间的预测能力。这一机制允许解码器一次性跳过多个编码器帧,而非逐帧访问,从而在长序列处理中显著降低计算开销。
- Kimi Delta Attention (KDA) 替换 LSTM:在预测网络中,Haas-ja-v1.0 使用 KDA 替代了原有的 LSTM 结构。实验表明,这一替换在保持几乎相同推理速度的前提下,有效提升了模型的识别精度。
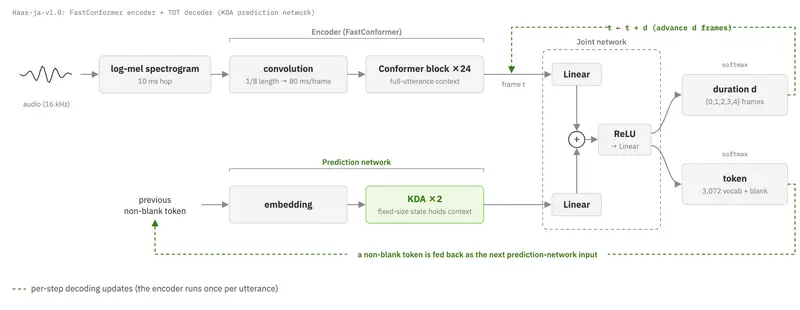
模型详细规格如下:
| 属性 | 参数配置 |
|---|---|
| 总参数量 | 615.8M(其中编码器 608.9M,预测网络 3.9M,联合网络 3.0M) |
| 输入规格 | 16 kHz 单声道音频;128-bin 对数梅尔频谱图(25 ms 窗口,10 ms 步长) |
| 编码器 | FastConformer,24 层,隐藏层大小 1,024,8 个注意力头,8× 下采样(每帧 80 ms),支持完整上下文 |
| 预测网络 | Kimi Delta Attention (KDA),2 层,隐藏层大小 640,5 头 × 64 |
| 联合网络 | 隐藏层大小 640;输出 token 与持续时间;持续时间范围为 0–4 帧 |
| 分词器 | 基于日语数据训练的 SentencePiece BPE,包含 3,072 个 token,支持字节回退 (byte fallback) |
| 解码策略 | 贪婪解码 (Greedy decoding),支持批处理 |
性能基准与评估结果
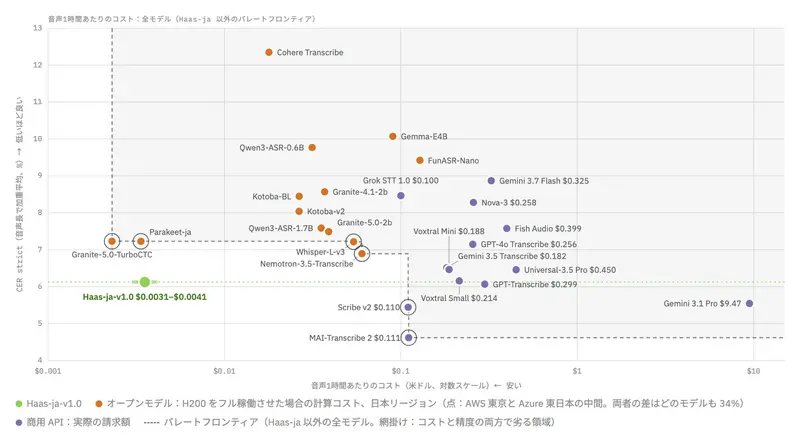
在由 5 个公开日语数据集构成的基准测试 asr-ja-bench v1.1 中,Haas-ja-v1.0 展现出了优异的性能平衡,位于推理速度与精度的帕累托前沿。
- 精度表现:在评估的开放模型中,Haas-ja-v1.0 取得了最高的识别精度,严格字符错误率(CER 严格)达到 6.12%。这一精度水平已与主流商用语音转文本 API 具备直接竞争力(例如与 GPT-Transcribe 的 6.07% 持平),而 MAI-Transcribe 2、Scribe v2 和 Gemini 3.1 Pro 等模型在该基准上仍保持微弱优势。
- 推理效率:Haas-ja-v1.0 的实时因子 (RTFx) 达到 3,236,与原版 Parakeet 模型(RTFx 3,407)的运行速度几乎一致。同时,其推理速度比 Nemotron 3.5 Transcribe 和 Whisper large-v3(评估中精度次优的开放模型)快约 15 至 17 倍。
- 成本优势:在保持与商用 API 相当精度的前提下,Haas-ja-v1.0 的本地化部署推理成本仅为商用 API 的数十分之一。
(注:基准测试中,每个单元格的顶部值为 CER 严格,底部值为 CER 弹性/假名,数值越低代表性能越好。)
开源生态与配套工具
为了促进日语语音识别领域的研究与工程落地,Third Intelligence 在此次发布中不仅公开了模型权重,还同步开源了以下配套资源:
- 日语语音识别评估库
jacer:提供标准化的评估脚本与指标计算逻辑,确保不同模型间的性能对比具备可复现性。 - 基准数据元数据:公开了构建
asr-ja-bench v1.1所使用的 5 个公开测试集的详细元数据,方便开发者理解测试分布与评估边界。
此次发布的 Haas-ja-v1.0 推理代码已同步上线,首个版本专注于日语场景。开发者可直接基于 FastConformer 编码器与搭载 KDA 的 TDT 解码器架构,进行本地部署或进一步的微调优化。
© 版权声明
文章版权归作者所有,未经允许请勿转载。