AI降临派(Adventists AI)正式推出 Sophon-Realtime v1,这是一个基于 Apache-2.0 协议开源的全双工语音模型系列。该模型旨在提供拟真的实时语音交互体验:在用户说话时持续监听并理解语义与语气,在回复时能够自然呈现笑声、叹气、换气等非语言声音(NVV, Non-Verbal Vocalizations),从而实现类似真人通话的流畅对话与随时插话打断机制。
- GitHub:https://github.com/adventists-ai/sophon-realtime
- Hugging Face:https://huggingface.co/adventists-ai
- 魔搭:https://www.modelscope.cn/organization/AdventistsAI
- Demo:https://www.modelscope.cn/studios/AdventistsAI/Sophon-Realtime
核心架构与工作机制
Sophon-Realtime v1 系列包含三个版本,其核心优势在于采用“统一大脑”架构。所有版本均共享同一个 32B 参数量的模型,该模型统一负责音频监听、接话时机判断以及回复文本的生成。版本间的差异仅在于“如何将文本回复转化为声音”的后处理机制。
其全双工工作流包含以下四个核心机制:
- 持续监听与状态判断:模型在用户说话的全程保持监听,每次用户停顿时,模型会通过输出特定 token 来判断当前状态(如:已结束发言、仍在思考、或仅为附和)。
- 提前起草与精准开口:在用户首次停顿时,模型即开始后台起草回复。一旦判定轮到自己发言,便立即输出;若用户在此期间继续说话,未完成的草稿将被直接丢弃,避免资源浪费。
- 副语言标记生成:模型不仅生成文本内容,还会在输出中嵌入非语言声音标记(如
[laughter]、[sigh]、<strong>强调等)。这些标记由后续的语音合成模块演绎,而非直接朗读出来。 - 无缝打断与历史清理:支持用户随时插话。一旦检测到用户输入,模型会立即停止当前发音,并在对话历史中仅保留用户实际听到的部分,确保上下文逻辑连贯。
三大版本规格与选型指南
为满足不同场景对表现力、延迟和并发量的需求,Sophon-Realtime v1 提供了三个版本。开发者可根据实际业务场景进行选择,且 TAG 与 FLASH 版本接口完全一致,支持后期无缝切换。
| 特性维度 | TAG 版(推荐) | FLASH 版 | E2E 预览版 |
|---|---|---|---|
| 发声机制 | 大脑生成带声音标签的文本,由擅长演绎的独立语音模型进行合成。 | 大脑生成带标签文本,交由更轻量、更快的语音模型处理(每 80ms 一帧,单次前向传播)。 | 端到端架构:32B 模型内部的“说话头”直接将回复转化为连续声音向量,再由解码器还原。 |
| 核心优势 | 表现力优先,情感与语气还原度最高。 | 速度与并发优先,延迟极低。 | 面向端到端语音表达的前沿研究。 |
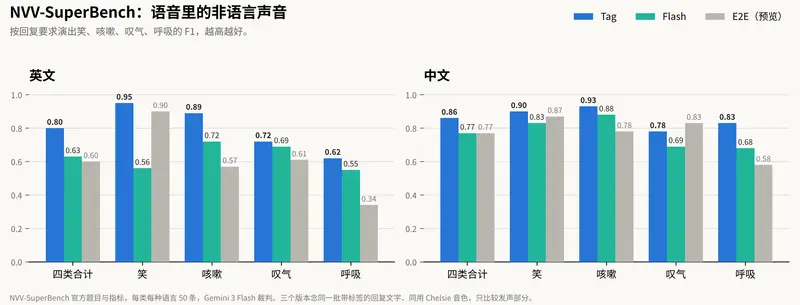
| 非语言声音表现 (NVV-SuperBench) | 中文 0.86 / 英文 0.80 | 中文 0.77 / 英文 0.63 | 中文 0.77 / 英文 0.60 |
| 单路首包延迟 | 约 0.6 秒 | 0.31 秒 | 约 1.0 秒 |
| 单卡 (80GB) 建议并发 | 16 路 | 40 路 | 4–5 路(需 2×80GB 显卡) |
| 部署引擎 | vLLM-Omni(单条命令) | vLLM-Omni(单条命令) | 自研引擎 |
| 适用场景 | 虚拟陪伴、角色扮演、高质量演示。 | 智能客服、车载语音、高并发单卡服务。 | 学术研究、端到端架构验证。 |
性能基准与评测数据
在多项权威公开基准测试中,Sophon-Realtime v1 展现了开源全双工模型中的领先性能:
- 综合语音能力:在 VoiceBench 中取得 82.8 分,在 Big Bench Audio 中取得 81.8% 的准确率,两项指标均位列开源全双工模型第一,并与 GPT-4o-mini-Audio 表现持平。
- 副语言理解能力:综合得分 48.6,位列第一。该能力由开源的语音决策模型 DuplexJev 提供支持,在 LISTEN、StressTest、MSPB 等基准测试中,高于 Gemini 3.8 Flash(46.9)和 Qwen3-Omni(44.6),能够准确识别情绪、重音、反讽、笑声和叹气。
- 工具调用与执行能力:在 Full-Duplex-Bench v3 测试中,工具调用 Pass@1 达到 48%(高于 Grok 的 43%),接话成功率达到 100%。支持 Live 模式,可与后端大模型联合工作,且完全兼容 OpenAI GPT-Live 的接口格式,所有回答均附带文字记录以供审计。
© 版权声明
文章版权归作者所有,未经允许请勿转载。