在文本转语音(TTS)领域,如何在保持高自然度的同时实现快速的音色克隆,一直是技术攻关的难点。Audio8 TTS Preview 提供了一个轻量级且高效的解决方案。这是一个仅拥有 0.6B(6 亿)参数的开源模型,支持多语言语音生成和零样本音色克隆,旨在为开发者和创作者提供高质量的语音合成能力。
- GitHub:https://github.com/Audio8-AI/Audio8_TTS
- 模型:https://huggingface.co/Audio8/Audio8-TTS-Preview-0.6b
核心架构:DualAR 的双重奏
Audio8 TTS 采用了受 Fish Audio S2 Pro 启发的 DualAR(双重自回归) 架构。这种设计将语音生成分解为两个协同工作的阶段:
- 慢速 AR Transformer:负责“理解”语义。它为每个音频帧预测一个语义 token,捕捉文本的节奏、语调和情感基调。
- 快速 AR Transformer:负责“填充”细节。它以慢速隐藏状态和前面的编解码器为条件,快速预测该帧的编解码器码本,生成高保真的声学细节。
这种分层处理使得模型既能保证语义的准确性,又能实现极高的推理速度和音频质量。
关键规格与性能
| 组件 | 配置详情 |
|---|---|
| 主模型参数量 | 约 6.01 亿(不含编解码器) |
| 慢速 AR 层 | 24 层,宽度 896,14 个注意力头 |
| 快速 AR 层 | 4 层,宽度 896,14 个注意力头 |
| 声学 Token | 10 个码本,每个码本 4,096 个条目 |
| 音频编解码器 | 44.1 kHz,每模型帧 2,048 个样本 |
| 上下文长度 | 最多支持 2,048 个打包的文本/音频位置 |
值得注意的是,该模型捆绑了专用的 44.1 kHz 神经音频编解码器,同时处理参考音频编码和波形解码,这意味着用户无需额外下载或配置其他编解码器检查点,极大地简化了部署流程。
支持语言与预览限制
目前发布的 Preview 版本有意限制了语言覆盖范围,以确保在特定语种上的最佳表现。推荐使用的 11 种语言包括:
- 亚洲语言:中文(普通话)、粤语、日语、韩语
- 欧洲语言:英语、法语、德语、意大利语、西班牙语、荷兰语、波兰语
注:更广泛的多语言覆盖及中文方言支持已列入未来版本的开发计划。
零样本音色克隆:只需一段参考音频
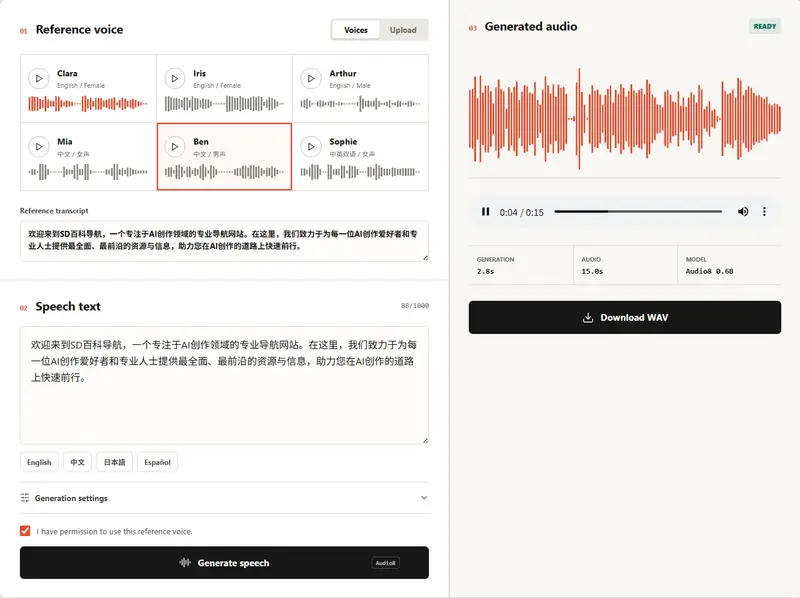
Audio8 TTS 的核心亮点在于其强大的零样本克隆能力。用户只需提供一段简短的参考音频,模型即可迅速捕捉说话人的音色特征、发音习惯甚至情感色彩,并将其应用到新的文本内容中。这使得它非常适合用于个性化语音助手、有声书制作、游戏角色配音等场景。
© 版权声明
文章版权归作者所有,未经允许请勿转载。