阿里巴巴今天发布了最新的语音识别大模型 Qwen-Audio-3.0-ASR-Flash。
如果说以前的语音识别是“听清你在说什么”,那么这一代的目标就是“听懂你在说什么”,尤其是那些晦涩难懂的专业词汇。
- Qwen-Audio-3.0-ASR-Flash:https://help.aliyun.com/zh/model-studio/non-real-time-speech-recognition-for-fun-asr-flash
- Qwen-Audio-3.0-ASR-Flash-Filetrans:https://help.aliyun.com/zh/model-studio/fun-asr-recorded-speech-recognition-http-api
- Qwen-Audio-3.0-ASR-Flash-Streaming:https://help.aliyun.com/zh/model-studio/fun-asr-realtime-websocket-api
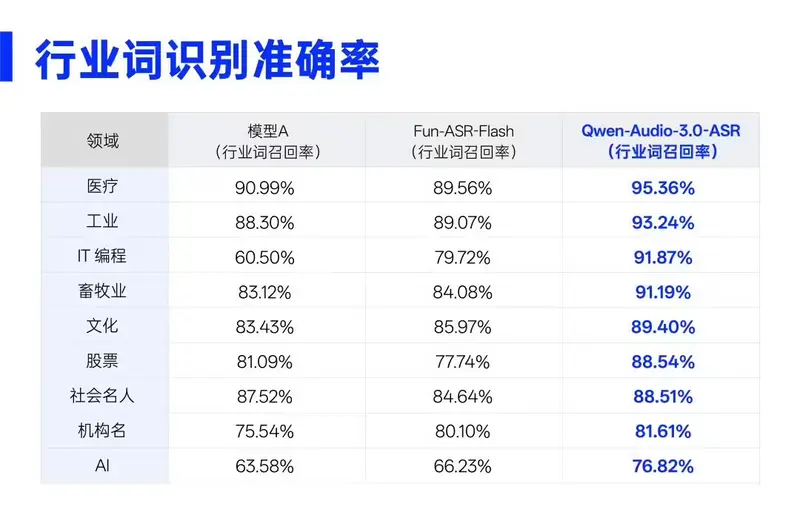
专攻“听不懂”的痛点
通用语音识别模型在处理日常对话时表现不错,但一旦遇到医疗、编程、金融等领域的专业术语,往往容易“翻车”。
Qwen-Audio-3.0-ASR-Flash 针对这个问题做了系统性优化:
- 行业词库增强:研究团队从医疗、IT 编程、股票、社会名人等领域挖掘了大量专业词汇和冷门词,建立了高质量词库。
- 上下文一致性:模型能更好地理解前后文逻辑,避免因为同音异义词导致的误识。
- 热词定制化:支持用户自定义高频词汇,进一步提升特定场景下的准确率。
官方数据显示,在内部评测中,该模型在医疗场景下的专业词“听中率”突破了 95.36%。而在权威评测平台 Artificial Analysis 上,它以 1.7% 的极低错字率拿下了全球第一。
不止于转写:润色与结构化
除了听得准,它还能帮你“整理好”。
模型具备语音润色能力,可以直接去除口语中的废话、重复和语气词,并输出结构化文本。这意味着,你扔进去一段杂乱的会议录音,拿出来的可能就是一篇条理清晰的纪要草稿。
三个版本,按需选择
目前,Qwen-Audio-3.0-ASR 系列已通过阿里云百炼平台开放调用,分为三个版本:
- Qwen-Audio-3.0-ASR-Flash:主打快速响应,支持最长 5 分钟的语音识别,适合短音频处理。
- Qwen-Audio-3.0-ASR-Filetrans:面向离线文件转写,适合处理长录音、课程录像等大批量任务。
- Qwen-Audio-3.0-ASR-Streaming:支持实时语音识别,适用于直播字幕、实时翻译等低延迟场景。
© 版权声明
文章版权归作者所有,未经允许请勿转载。