LG AI 研究院今天在 Hugging Face 上正式发布了 K-EXAONE 2.0。
作为韩国科技信息通信部主权人工智能基金会项目下的第二款模型,K-EXAONE 2.0 以 7500 亿总参数(激活参数 370 亿)的规模,成为迄今为止韩国开发的最大人工智能基础模型。更重要的是,它采用了 Apache 2.0 许可证 完全开源,允许全球开发者自由检查、部署和二次开发。
- 模型:https://huggingface.co/collections/LGAI-EXAONE/k-exaone-20
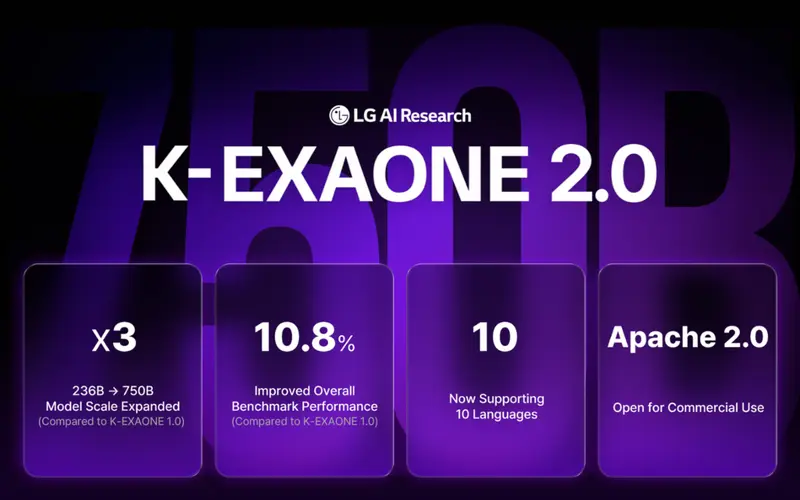
规模翻倍,性能显著跃升
相比初代 K-EXAONE(2360 亿参数),2.0 版本的规模扩大了 3 倍以上。在 24 项基准测试中,其平均得分从 63.3 提升至 70.1,涨幅超过 10%。
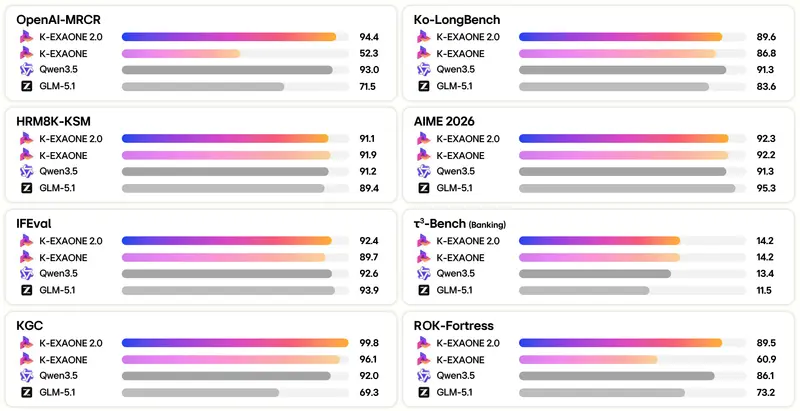
特别是在三大主要编码和智能体编码基准测试中,性能改进约 30%。横向对比来看:
- 长上下文理解:优于智谱 GLM-5.1。
- 智能体工具使用:优于 GLM-5.1 和通义千问 Qwen3.5。
- 指令遵循:与 GLM-5.1、DeepSeek V4 Pro Max、Qwen3.5 处于同一梯队。
技术亮点:稳得住,跑得快
为了支撑如此庞大的参数规模,LG 在架构和推理优化上下了不少功夫:
- 混合注意力 MoE 架构:采用 1 个全局注意力 + 1 个滑动窗口注意力 + 19 个块的组合。研究发现,在 SwiGLU 分支后加入钳位操作,有效缓解了深层激活值爆炸问题,提升了训练稳定性。
- 生产级推理加速:支持 MTP 和 DSpark 两种推测解码方法,可将生成速度提高 3-5 倍,大幅降低长周期工作负载的延迟。
- 超长上下文:支持 262,144 token 的上下文长度,并在 OpenAI-MRCR 等长文本检索基准上取得了 94.4 的高分。
多语言与安全并重
K-EXAONE 2.0 将多语言支持从 6 种扩展到 10 种,包括韩语、英语、西班牙语、德语、日语、越南语、法语、意大利语、波兰语和葡萄牙语。
在安全性方面,它在韩国本土的安全基准测试(KGC-Safety, ROK-Fortress)中表现优异,分别达到 99.8 和 89.5 分,远超部分国际竞品。
模型配置速览
- 总参数/激活参数:750B / 37B
- 专家数量:256 个总专家,每次激活 8 个
- 上下文长度:262K tokens
- 知识截止:2025 年第二季度
© 版权声明
文章版权归作者所有,未经允许请勿转载。