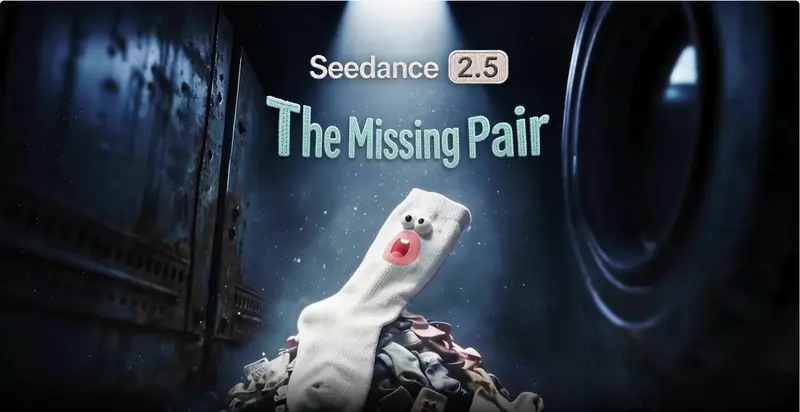
7 月 31 日,字节跳动正式推出 Seedance 2.5 视频生成模型。该模型已陆续上线即梦 AI 和豆包专业版,API 服务也将于近期接入火山方舟。
- 项目地址:https://seed.bytedance.com/zh/seedance2_5
相比前代,Seedance 2.5 不再满足于生成几秒的“动态图片”,而是试图让 AI 真正学会“讲故事”。
一次生成 30 秒,还能接着讲
最直观的提升是时长。Seedance 2.5 将单次生成上限从 15 秒翻倍至 30 秒,并支持多轮延长。
更重要的是逻辑连贯性。官方表示,模型能在 30 秒内组织多个有逻辑关联的镜头,实现铺垫、推进、转折、收尾的完整叙事结构。
- 示例 1(一镜到底):镜头从幕布缝隙推进后台,展示歌手整理耳机、穿过通道、与舞伴互动,最后登台拉远至体育馆全景。整个过程光影、人物动作、环境音无缝衔接。
- 示例 2(多轮延长):在已有视频基础上继续生成 30 秒,保持人物、场景、风格甚至音效的一致性。比如小男孩抱球跑过车厢、冲出地铁、男主追赶并抓住他,动作流极其顺畅。
海量参考素材,精准控制画面
为了解决“抽卡”不可控的问题,Seedance 2.5 支持极丰富的参考输入:
- 最多 30 张图片
- 最多 10 段视频
- 最多 10 段音频
模型能综合理解这些素材中的构图、风格、人物特征和道具,并按指令生成视频。这意味着你可以用一组剧照、一段参考视频和一首背景音乐,精准地“拼”出你想要的画面。
多人同框与群像叙事
在复杂的多人场景中,Seedance 2.5 也能稳住。官方展示的 30 秒音乐会片段中,同时出现了钢琴家、大提琴手、小提琴手、主唱、管弦乐队、合唱团和观众。模型不仅还原了每个人的形象,还保持了声音与口型的同步,以及整体电影感的写实风格。
应用场景
除了娱乐内容,Seedance 2.5 还面向影视制作、广告投放、教育课件、工业制造演示、具身智能训练数据生成以及自动驾驶模拟等场景。
© 版权声明
文章版权归作者所有,未经允许请勿转载。