传统的文本转语音(TTS)模型大多是为单向输出(如有声读物)设计的,它们只能看到文字,却听不到声音背后的情绪、讽刺或无奈。
- 官方介绍:https://inworld.ai/blog/realtime-tts-2
- API:https://docs.inworld.ai/tts/tts
- Demo:https://realtime.ai
Inworld AI 发布的 Realtime TTS-2 ,作为一个闭环语音模型,TTS-2 不仅能生成高质量音频,更能“听到”前一轮对话的实际音频,捕捉用户的语调、节奏和情绪状态,从而做出符合语境的回应。这标志着语音 AI 从“朗读机器”向“倾听伙伴”的重大跨越。
核心突破:为什么 TTS-2 与众不同?
1. 真正的闭环架构 (Closed-Loop Architecture)
- 音频即上下文:不同于传统模型仅接收转录文本,TTS-2 将上一轮交流的原始音频作为输入。
- 情绪传递:它能区分“好吧,行”是释然、无奈还是讽刺。这种语调、节奏和情绪状态会在会话轮次间自动流动,无需开发者手动构建复杂的
prior_audio管道。 - 语境感知:模型知道同一句话在笑话后和坏消息后的不同含义,因为它“听”到了前文的声音氛围。
2. 自然语言语音指令 (Voice Instructions)
- 提示词控制语音:开发者可以使用简单的英语提示直接引导语音表现,如
[speak sadly, as if something bad just happened]。长描述性提示比短标签效果更佳。 - 非语言声音嵌入:支持在文本中插入内联标记,如
[laugh](笑)、[sigh](叹气)、[breathe](呼吸)、[clear_throat](清嗓子)和[cough](咳嗽)。模型会将这些作为真实的音频事件生成,而非读出来。
3. 跨语言音色一致性
- 无缝切换:一个语音身份可在 100+ 种语言中保持一致,甚至在同一次生成中混合切换语言。
- 自动适配:无需额外的语言标记,模型自动处理转换,确保音色、音高和角色特征在跨语言时依然稳定。
4. 高级语音设计与克隆
- 文本创建语音:无需参考音频,仅通过散文描述即可生成独特的语音身份并保存复用。
- 两步克隆 API:上传参考样本即可获得语音 ID,快速实现个性化语音克隆。
更拟人的行为细节
TTS-2 在微观层面模拟了真实人类的说话习惯,使其听起来不再像机器:
- 自然不流利现象:生成自然的“嗯”、“呃”等填充词。
- 自我修正:模拟人类说话时的中途改口。
- 节奏停顿:在名词短语中加入恰当停顿,尾音处理传达温暖而非故障感。
性能与集成
- 超低延迟:作为 Inworld Realtime API 管道的一部分,通过持久 WebSocket 连接,中位首字音频时间低于 200 毫秒。
- 全栈整合:与 Realtime STT(语音转文本)和 Realtime Router(模型路由)无缝协作,提供端到端的实时对话体验。
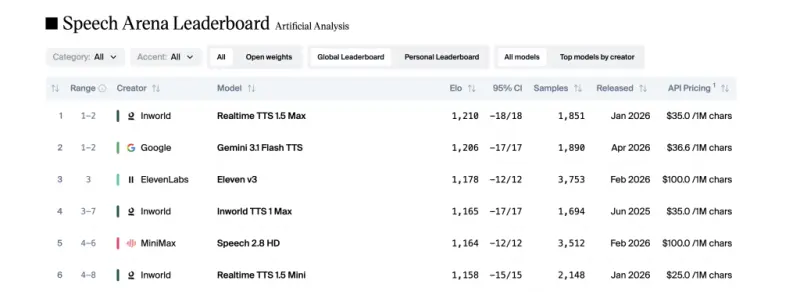
- 行业领先:其前身 TTS-1.5 已在 Artificial Analysis Speech Arena 中排名第一,TTS-2 进一步巩固了在行为层面的领先地位。
适用场景
- 情感化客服代理:准确识别用户沮丧或愤怒的语气,并以同理心回应。
- 沉浸式游戏 NPC:根据剧情上下文和玩家互动,生成带有情绪波动和非语言声音的自然对话。
- 多语言虚拟助手:在全球化应用中保持品牌声音的一致性,同时流畅切换语言。
- 陪伴型 AI:通过自然的停顿、笑声和叹息,建立更深的情感连接。
© 版权声明
文章版权归作者所有,未经允许请勿转载。