让 AI 写一首流行歌或钢琴曲,现在已经不算稀奇。但如果让 AI 写一部交响乐——那种有几十种乐器、十几个声部、要持续演奏几十分钟的宏大作品——难度就完全不一样了。
交响乐创作之所以难,是因为它同时涉及两个巨大挑战:复杂度和可控性。一方面,管弦乐总谱里密密麻麻排满了各种乐器的音符,信息量极其庞大,AI 很容易“算不过来”;另一方面,作曲家通常不会从零开始凭空写,而是先打个草稿——比如先确定每个小节用什么和弦、旋律怎么走向——然后再慢慢细化成完整的总谱。现有的 AI 作曲模型往往缺少这种“草稿→成品”的分层思路,要么把所有音符压成一条长串硬算,要么生成过程完全黑箱,人插不上手。
更麻烦的是,现有模型大多在杂乱的 MIDI 数据上训练,学了不少“坏习惯”,生成的音乐经常出现刺耳的不协和音,听起来像是一群没排练过的乐手在各自为政。
- 项目主页:https://symphonygen.github.io
- GitHub:https://github.com/symphonygen/symphonygen
- 模型:https://huggingface.co/SymphonyGen/SymphonyGen
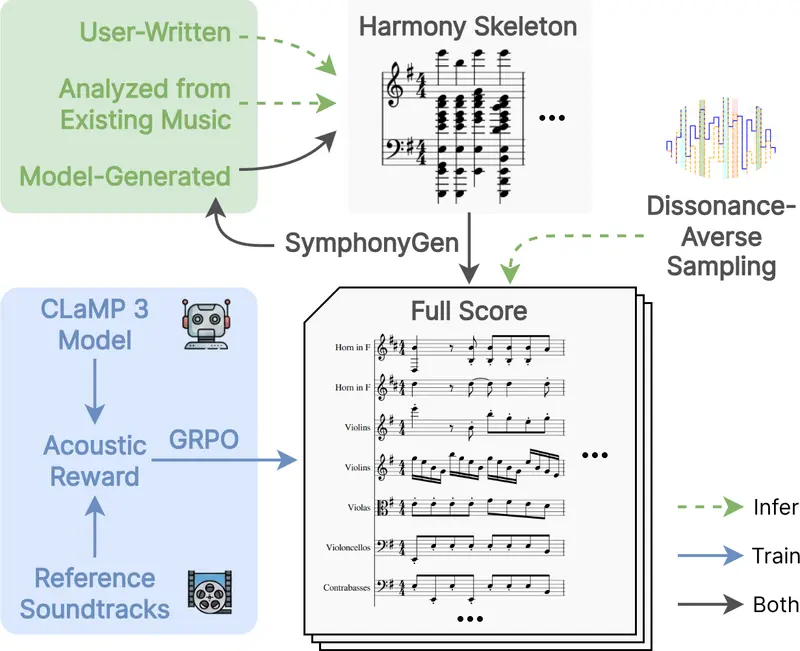
来自中央音乐学院、西安交通大学、中国科学技术大学和深圳大学的研究团队,提出了 SymphonyGen。这是一个专门为当代管弦乐(特别是电影配乐风格)设计的 AI 作曲系统。它的核心理念是:像真正的作曲家一样,先搭骨架,再填血肉;而且每个步骤都可以由人来把关。
主要功能:从“蓝图”到“总谱”
SymphonyGen 不是一个只能“凭空乱写”的 AI,而是一个能与人协作的作曲助手:
- 根据“和声骨架”生成完整管弦乐总谱
你可以给 AI 一份“蓝图”——也就是和声骨架,告诉它每个拍子该用什么和弦、整体和声怎么推进。AI 会根据这份蓝图,自动为弦乐组、木管组、铜管组、打击乐组等各个声部分配音符,生成一份完整的总谱。 - 三种方式提供和声骨架
这份蓝图不一定非要你自己写。它可以是:- 人写的:作曲家随手在键盘上弹几个和弦;
- 从现有音乐分析的:把一段已有的交响乐丢进去,AI 自动提取它的和声骨架;
- AI 生成的:让 SymphonyGen 自己先写个骨架,你挑满意的再扩展。
- 重新配器
拿到一段音乐的和声骨架后,AI 可以生成不同风格的管弦乐配器版本。就像同一份菜谱,可以做出不同风味的菜肴。 - 当代电影配乐风格
虽然模型本身不限风格,但研究团队通过数据筛选和强化学习,把它特别调校向了当代电影配乐的方向。生成的音乐带有强烈的叙事感和氛围感,适合影视、游戏使用。 - 保持旋律活力与和声清晰
AI 在填充管弦乐织体时,不会把旋律淹没在嘈杂的伴奏里,也不会制造出莫名其妙的刺耳音响。它懂得在丰富性和清晰度之间找平衡。
核心创新:三维分层与“听音”优化
相比现有的 AI 作曲模型,SymphonyGen 有几个非常独特的设计:
1. 三维分层架构——像真正的总谱一样思考
传统 AI 处理音乐时,往往把所有音符按时间顺序排成一条长队,就像把一本交响乐总谱的所有音符串成一根面条。这种方式不仅内存消耗巨大,而且丢失了音乐本身的层次结构。
SymphonyGen 采用了一种三维分层的设计,分别处理音乐的三个维度:
- 时间维度:一个个小节怎么推进;
- 乐器维度:每个声部(小提琴、长笛、圆号等)该做什么;
- 音符维度:每个声部在具体位置上发什么音。
这就像人类作曲家看总谱:先看整体结构,再看各乐器分工,最后才看具体音符。因为分层处理,AI 生成时的内存占用比传统方式低得多,即使是很长的乐曲也能流畅处理。
2. “和声骨架”控制——人握方向盘,AI 踩油门
这是 SymphonyGen 最核心的创新。和声骨架相当于建筑的承重结构或文章的提纲,它规定了音乐在每个拍子上的核心音高(和弦)。AI 在这个框架内自由发挥,填充具体的旋律、节奏和配器细节。
这种设计的妙处在于每一层都可以被控制:你可以只定大体的和声走向,让 AI 自由发挥;也可以精细到某个小节某个乐器的具体处理。对于专业作曲家来说,这提供了一个真正可用的协作界面,而不是一个“要么全听我的,要么全听 AI 的”的二选一方案。
3. 压缩式音符表示——不浪费一个字节
交响乐中经常出现同一个拍子上多个音同时响、或者一个音紧接着另一个音的情况。研究团队设计了一套聪明的“压缩”规则,把这类情况用更简洁的方式表达,减少了大量无意义的填充。这让模型可以把有限的注意力集中在真正的音乐创作上。
4. 强化学习“听音”优化——让 AI 学会“好听”
模型先通过大量乐谱学会基本规则,然后进入“精进”阶段。研究团队用了一种叫做强化学习的技术:模型生成一段音乐后,先通过打谱软件转成音频,再用一个懂音乐的 AI 裁判(CLaMP 3)去对比参考的电影配乐,算出相似度。相似度高就奖励,低就调整。这样反复训练后,AI 生成的音乐在听觉质感上越来越接近专业影视配乐。
5. 不协和音规避——自动避开“刺耳”组合
音乐里有些音程组合天生刺耳,比如挨得太近的两个音(小二度)或者特别不稳定的“魔鬼音程”(三全音)。SymphonyGen 在生成音符时,会实时检查即将生成的音会不会和当前和弦“打架”。如果会,就降低选它的概率。这就像一个内置的“和声校对员”,确保生成的音乐听起来和谐舒服。
6. 双流交叉注意力——既看当下,也看前文
在生成某个乐器的音符时,模型会同时参考两个信息源:一是当前小节的和声骨架(确保不跑调),二是这个乐器在前一小节做了什么(确保旋律连贯)。这种“双线并进”的设计,让音乐既有整体的和声统一,又有声部自身的线条感。
工作原理:四层流水线
SymphonyGen 的工作流程可以想象成一个四层流水线:
- 第一层:编码——读懂蓝图和原材料
首先,模型接收两份输入:一是和声骨架(蓝图),二是已经写好的音乐事件(如果是从头生成,这部分可以留空)。和声骨架是通过自动分析流程提取的简化“短谱”,音乐事件则通过压缩编码器处理并加入元信息。 - 第二层:小节与声部解码——从宏观到微观
编码完成后,进入解码阶段。首先是一个小节解码器,它从头到尾审视和声骨架和音乐的小节特征,制定出一个“小节级计划”:这一小节整体是什么情绪、什么密度、什么织体。然后计划被传递到声部解码器,它负责把总体的音乐意图分配给具体的乐器声部。 - 第三层:音符解码——填写具体音符
最后是最精细的音符解码器。它根据声部解码器分配的任务,以及当前小节的和声骨架,一个音一个音地生成具体的音符。这里就用到了前面提到的“双流交叉注意力”:既要盯着和声骨架(别跑调),又要回顾前一小节同乐器做了什么(保持连贯)。 - 第四层:强化学习与不协和音规避——精修与把关
基础训练完成后,模型进入强化学习阶段,通过 AI 裁判的反馈调整策略。在实际使用时,还有一个不协和音规避机制在运作,系统内部维护了一张“音程冲突表”,每次模型要选下一个音时都会查一下,如果太刺耳就降低优先级。
测试结果:客观指标与主观听感双优
SymphonyGen 在客观指标和主观听感测试中都表现优异:
- 客观指标:强化学习让音乐中的不协和音减少了将近一半,同时保持了旋律的活力和装饰性。和声骨架的还原度很高,生成的音乐基本忠实于给定的和声蓝图。
- 主观听感:在盲听测试中,SymphonyGen 在整体质量、音乐连贯性和个人偏好上都显著优于对比模型,甚至超过了从原始数据集中挑选的真实乐曲片段。听众常用“强烈的命运感”、“有叙事性”、“画面感强”来形容其作品。
应用场景:从影视配乐到作曲教学
SymphonyGen 这样的技术,未来可能在很多领域成为创作者的得力助手:
- 影视与游戏配乐:快速生成管弦乐草稿,大幅降低前期试错成本。AI 负责“搭骨架、铺底色”,人类负责“点睛、润色”。
- 作曲教学与和声配器学习:音乐院校的学生可以用它来练习配器,对比自己写的和 AI 写的,学习管弦乐法的技巧。
- 个人音乐创作:有和弦功底的音乐爱好者,可以把自己弹的和弦走向输入系统,让 AI 扩展成气势恢宏的管弦乐版本。
- 重新配器与改编:把一段钢琴曲、流行歌甚至古典名曲的和声骨架提取出来,用 SymphonyGen 生成全新的管弦乐版本。
- 互动式音乐体验:在博物馆、展览馆中,根据观众的实时输入生成对应的管弦乐片段。
© 版权声明
文章版权归作者所有,未经允许请勿转载。