在传统的歌声合成(SVS)系统中,作曲家往往需要花费大量精力去调整每个音素的时长、对齐 F0 曲线或提供复杂的参考音频。VocalRender 由西安交通大学、南洋理工大学、蚂蚁集团和浙江大学的研究人员联合推出,它彻底改变了这一流程:这是一个面向真实作曲流程的乐谱原生歌声合成系统,能够直接将作曲家使用的符号乐谱(歌词、音高、时值、BPM)渲染为高保真的 48 kHz 歌声音频。
- 项目主页:https://pymaster17.github.io/VocalRender
- GitHub:https://github.com/pymaster17/VocalRender
- 模型:https://huggingface.co/pymaster/VocalRender
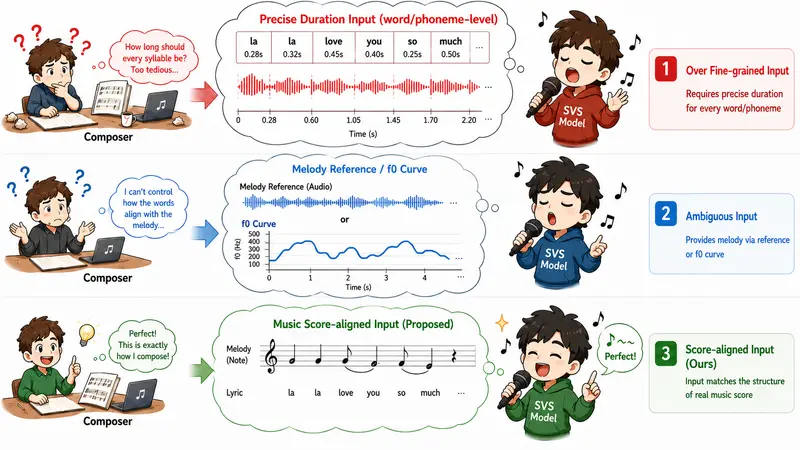
核心理念:从“参数调整”到“乐谱渲染”
VocalRender 的最大突破在于其“乐谱原生”的设计理念。它不需要为每个字指定精确时长,也不依赖时序对齐的参考音频或 F0 曲线。模型接收的是作曲者最熟悉的符号信息,并自主生成自然的演唱时序与富有表现力的细节(如转音、气息等)。
1. 原创的「字/音高/音符」交错表示
VocalRender 采用了一种独特的 Token 序列结构,显式保留了歌词与音符的对应关系:
- 全局控制:以
<BPM_90>等 Token 设定整体速度。 - 交错排列:每个歌词字后紧跟一个或多个
(音高, 音符时值)对。例如:感<P_62><NOTE_8> 受<P_62><NOTE_DOT_16>。 - 支持转音:这种结构天然支持一个音节横跨多个音符的转音(Melisma)处理,无需额外的对齐逻辑。
2. 连续声学 Latent 表示
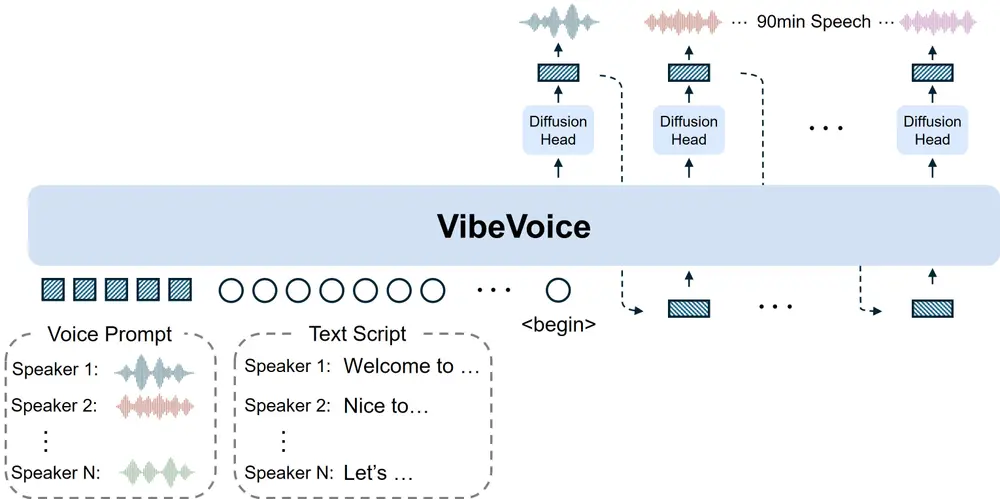
为了避免离散声学量化带来的信息瓶颈,VocalRender 使用 Audio VAE 将歌声音频编码为紧凑的连续 Latent。这种方式能够保留细粒度的音高变化、音色质感以及咬字细节,为高保真还原打下基础。
3. 自回归扩散建模
生成过程分为两步:
- AR Transformer:生成韵律草图并逐个 Patch 预测序列长度。
- LocDiT (Local Diffusion Transformer):进一步还原高保真的局部声学 Latent。
最后由 VAE Decoder 解码为波形。整个过程无需显式的时长预测器或时序对齐的声学引导,实现了端到端的自然生成。
技术架构概览
| 模块 | 功能 |
|---|---|
| 乐谱 Tokenizer | 编码 BPM、歌词音节及对应的 (音高, 时值) 对,构建交错 Prompt。 |
| Audio VAE | 将 48 kHz 音频编码为连续 Latent,保留细微声学特征。 |
| AR Transformer | 基于乐谱 Prompt 和参考音色,生成初步的韵律与序列结构。 |
| LocDiT | 通过扩散模型细化局部声学 Latent,提升音质与表现力。 |
| VAE Decoder | 将最终 Latent 解码为高保真波形。 |
开源内容与使用
目前发布的仓库为最小化开源版本,包含了数据预处理、训练与推理的核心代码。
- 输入格式示例:
<BPM_90> 感<P_62><NOTE_8> 受<P_62><NOTE_DOT_16><P_60><NOTE_16> 停<P_59><NOTE_8> ... <audio_start> - 音色条件:模型需要一段必需的 Prompt 歌声片段作为音色参考,以确保合成声音符合预期的人设。
- 输出质量:直接生成 48 kHz 的高采样率音频,具备极高的听感自然度。
© 版权声明
文章版权归作者所有,未经允许请勿转载。