由西北工业大学软件学院音频、语音与语言处理组、新南威尔士大学及 WeNet 开源社区联合推出的 MeanVC2,标志着流式语音转换(Voice Conversion, VC)技术在低延迟与高保真度之间取得了新的平衡。
- GitHub:https://github.com/ASLP-lab/MeanVC2
- 模型:https://huggingface.co/ASLP-lab/MeanVC2
作为一个基于扩散条件流匹配(CFM)框架的系统,MeanVC2 不仅解决了其前身 MeanVC 在训练效率和小块设置下质量下降的问题,更通过引入未来感知分块(FRC)和通用音色令牌编码器(UTTE),实现了端到端仅 110 毫秒的流水线延迟。这意味着在实时通话或直播场景中,用户几乎感受不到转换带来的滞后。
核心突破:如何做到又快又好?
1. 未来感知分块(FRC):打破短块瓶颈
传统的流式模型在处理极短音频块(如 40ms)时,往往因为缺乏上下文而导致音质崩塌。MeanVC2 通过在 DiT(Diffusion Transformer)层间显式调度过去与未来的感受野,实现了稳定的短块转换。
- 消除教师强制:不再依赖干净块的理想化假设。
- 显存优化:峰值 GPU 内存占用减少约 60%,使得在消费级硬件上部署成为可能。
2. 通用音色令牌编码器(UTTE):抗噪与解耦
UTTE 将细粒度的音色提取与直接的参考梅尔频谱图解耦,采用“全局说话人嵌入 + 交叉注意力”机制。
- 鲁棒性提升:即使参考音频存在背景噪音或录音质量较差,也能准确捕捉说话人特征。
- 零样本相似度:在未见过的新说话人数据上,依然能保持极高的音色还原度。
3. 极致轻量与高效推理
- 参数量仅 18M:与 MeanVC(14M)相当,远小于其他竞争性的流式 VC 系统。
- 单步 ODE 求解:结合 Mean Flows 与 1-NFE(Number of Function Evaluations)推理,在单步内即可合成高质量梅尔频谱图,完美平衡了效率与保真度。
- CPU 友好:在单 CPU 核心上,全流水线实时因子(RTF)小于 0.633,无需高端显卡即可流畅运行。
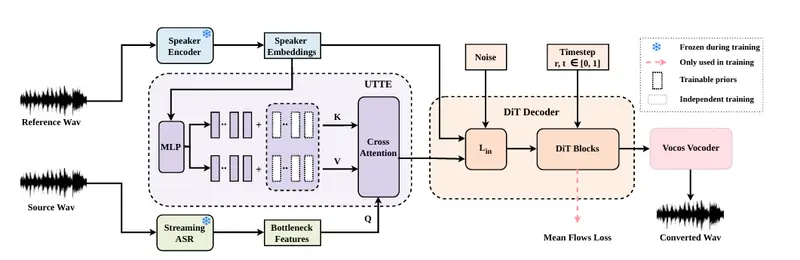
技术架构:识别-合成范式
MeanVC2 采用经典的识别-合成流程,但每个环节都进行了流式优化:
- 内容提取:流式 ASR 模块提取内容表示(BNF),确保语义不变。
- 音色检索:UTTE 从参考音频中检索音色感知特征。
- 频谱生成:基于 DiT 的解码器在音色条件下生成目标梅尔频谱图。
- 声码器合成:将梅尔频谱图转换为最终波形。
灵活部署:支持微调与多种场景
- 零样本即时转换:无需训练,直接上传参考音频即可克隆音色。
- 说话人特定微调:提供完整的训练脚本,用户可以基于预训练的 safetensors 检查点,在目标说话人的专属数据上进行微调,进一步榨取音质潜力。
- 多模式支持:既支持基于文件的离线转换,也支持实时麦克风流式输入,可适配预提取或即时特征处理。
© 版权声明
文章版权归作者所有,未经允许请勿转载。