在边缘设备上运行高精度的语音识别(ASR)模型,通常意味着要在“速度”和“准确率”之间做艰难取舍。大多数高性能模型依赖 GPU 加速,而轻量级模型往往牺牲了多语言支持或识别精度。
- GitHub:https://github.com/microsoft/VibeASR.cpp
- 模型:https://huggingface.co/microsoft/VibeVoice-ASR-BitNet
微软最新发布的 VibeVoice-ASR-BitNet 试是 VibeVoice-ASR 的压缩变体,专为边缘 CPU 实时推理设计。通过异构量化技术,它将模型体积从 4.62 GB 大幅压缩至 1.58 GB,并在仅需 3 个 CPU 线程的情况下,实现了比 Whisper.cpp 快 1.6–2.3 倍的推理速度,且实时因子(RTF)小于 1。
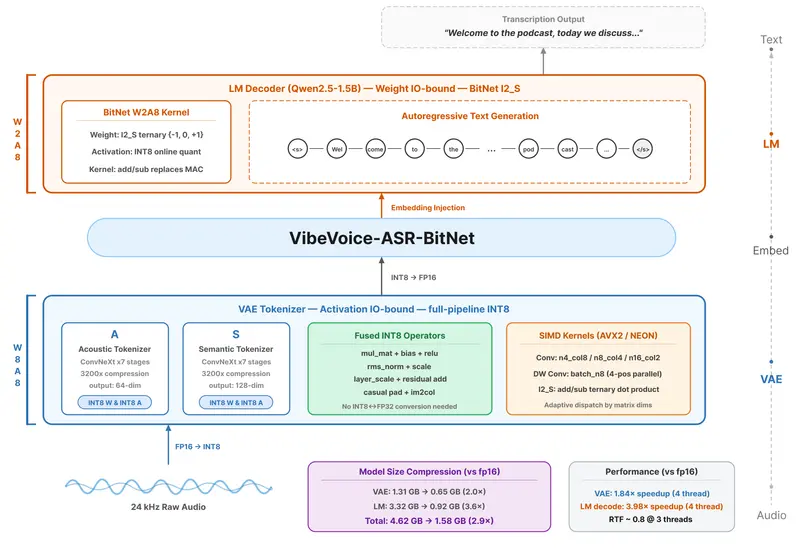
核心突破:极致压缩与 SIMD 优化
VibeVoice-ASR-BitNet 的核心优势在于其高效的量化策略和针对 CPU 架构的深度优化:
1. 异构量化:体积缩减近 3 倍
模型采用了混合量化方法,针对不同组件选择最优的压缩方案:
- VAE Tokenizer:采用 I8_S 量化,从 1.31 GB 压缩至 0.65 GB(2.0 倍)。
- LM Decoder:采用 I2_S + Q6_K 混合量化,从 3.32 GB 压缩至 0.92 GB(3.6 倍)。
- 总计:模型总大小仅为 1.58 GB,非常适合内存受限的边缘设备。
2. 自定义 SIMD 内核:榨干 CPU 性能
为了在无 GPU 环境下实现实时推理,微软在 ggml 框架内开发了针对 ARM (NEON) 和 x86 (AVX2+FMA) 平台的融合算子。
- 实时表现:在 AMD EPYC 7V13 处理器上,仅使用 3 个线程即可达到 RTF 0.77(即处理 1 秒音频仅需 0.77 秒),远超实时要求。
- 对比优势:在相同硬件条件下,其速度是 Whisper.cpp 的 1.86 倍(3 线程时)。
多语言支持与准确率评估
尽管经过了深度压缩,VibeVoice-ASR-BitNet 依然保持了强大的多语言能力,支持英语、中文、法语、意大利语、韩语、葡萄牙语、越南语等。
在多项基准测试中,其表现如下:
- 英文场景:在 MLC-EN 数据集上,WER(词错误率)为 8.25%,略高于原版 VibeVoice-ASR-7B (7.82%),但显著优于 Whisper (13.57%) 和 SenseVoice (12.39%)。
- 中文场景:在 Fleurs-zh 数据集上,WER 为 8.35%,与 FunASR (7.00%) 和 SenseVoice (5.56%) 处于同一梯队,远优于 Whisper。
- 噪声环境:在 AMI 会议录音等嘈杂环境中,其表现依然稳健,WER 控制在 21%-25% 之间,优于 Whisper 和 SenseVoice。
注:虽然压缩导致准确率相比原版 7B 模型有轻微下降,但在实际应用场景中,这种权衡换来了极高的部署灵活性。
部署指南
该模型以 GGUF 格式提供,可直接兼容现有的 ggml/ecosystem 工具链:
| 文件 | 大小 | 描述 |
|---|---|---|
vibeasr-vae-encoder-i8_s.gguf | 0.65 GB | VAE 分词器,I8_S 量化 |
vibeasr-lm-i2_s-embed-q6_k.gguf | 0.92 GB | LM 解码器,I2_S + Q6_K 量化 |
硬件建议:
- 最低配置:支持 AVX2 的 x86 或 NEON 的 ARM 处理器,至少 2GB 可用内存。
- 推荐配置:4 核以上 CPU,4GB+ 内存,可获得更低的延迟和更高的并发处理能力。
© 版权声明
文章版权归作者所有,未经允许请勿转载。