SD百科导航
  • 首页
  • 快讯
  • 早报
  • 模型
  • ComfyUI
  • 新技术
  • 百科
    • 教程
    • 硬件
    • 科普
  • 百科工具
    • 工具
  • 排行榜
    • 首页
    • 快讯
    • 早报
    • 模型
    • ComfyUI
    • 新技术
    • 百科
      • 教程
      • 硬件
      • 科普
    • 百科工具
      • 工具
    • 排行榜

    小红书

    共 11 篇文章
    排序
    发布更新浏览点赞
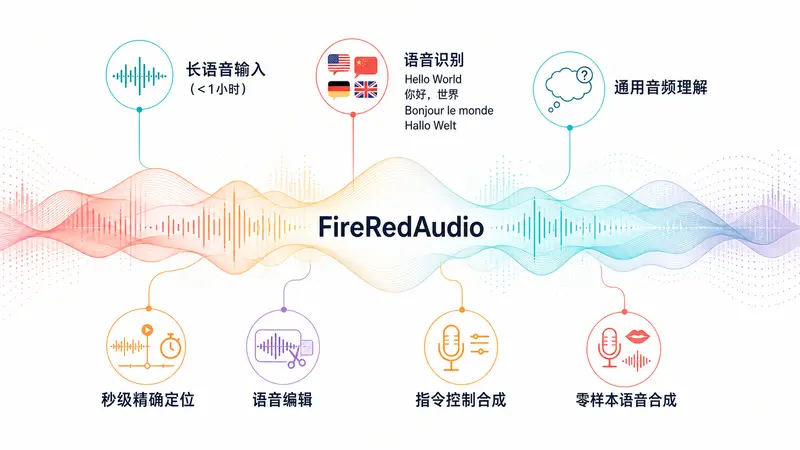
    小红书团队推出FireRedAudio 9B音频大模型,一套主干同时搞定音频理解与语音生成

    小红书团队推出FireRedAudio 9B音频大模型,一套主干同时搞定音频理解与语音生成

    小红书旗下FireRedTeam发布通用音频语言模型 FireRedAudio。它以90亿参数的LLM作为共享主干,创新性采用解耦连续表示架构,把音频识别理解、语音生成编辑能力放进同一个模型当中,解决...
    语音模型# FireRedAudio# FireRedTeam# 小红书
    3个月前
    1510
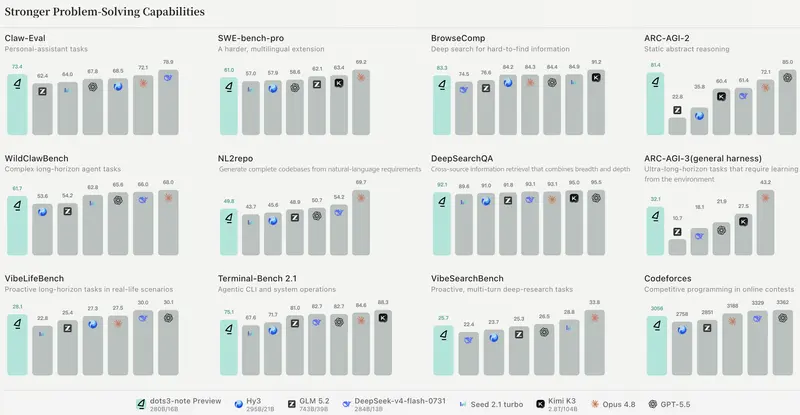
    小红书开源 dots3-note Preview:280B 参数多模态长程智能体,迈向真实生活 AI

    小红书开源 dots3-note Preview:280B 参数多模态长程智能体,迈向真实生活 AI

    小红书 dots-studio 正式开源 dots3-note Preview,这是 dots3 系列中最轻量的模型,总参数量达 280B(激活参数 16B),支持 512K 超长上下文。该模型具备文...
    大语言模型# dots3-note Preview# 小红书
    3个月前
    1500
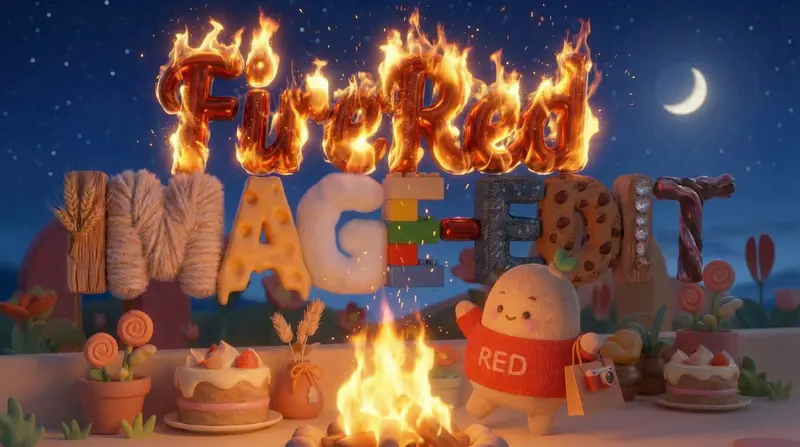
    小红书开源FireRed-Image-Edit 1.1:引入智能体工作流,支持 10+ 元素融合与专业级人像精修

    小红书开源FireRed-Image-Edit 1.1:引入智能体工作流,支持 10+ 元素融合与专业级人像精修

    小红书智能创作基础技术团队正式推出 FireRed-Image-Edit-1.1。作为前代通用图像编辑模型的升级版,1.1 版本在保留强大编辑能力的基础上,重点攻克了身份一致性、多图像复杂控制及领域专...
    图像模型# FireRed-Image-Edit 1.1# 小红书
    9个月前
    3840
    图像编辑模型FireRed-Image-Edit:小红书团队出品,让图片编辑像说话一样简单

    图像编辑模型FireRed-Image-Edit:小红书团队出品,让图片编辑像说话一样简单

    小红书智能创作基础技术团队正式推出 FireRed-Image-Edit——一款通用图像编辑模型,凭借原生编辑架构、精准指令遵循能力,在广泛场景下实现高保真、视觉一致的编辑效果,既打破了专业修图的门槛...
    图像模型# FireRed-Image-Edit# 图像编辑模型# 小红书
    9个月前
    5580
    使用 Nano Banana Pro 制作 Instagram 与小红书风格的 3D 弹出效果图片

    使用 Nano Banana Pro 制作 Instagram 与小红书风格的 3D 弹出效果图片

    以下为两套高度结构化的提示词模板,专为 Nano Banana Pro 设计,用于生成具有“破框而出”3D 效果的社交媒体风格图像。每套均包含构图、UI 元素、人物姿态、光影与质感等关键维度,确保输出...
    提示词# Instagram# Nano Banana Pro# 小红书
    10个月前
    2440
    小红书开源 FireRedChat:一个完整、可控的全双工语音交互系统

    小红书开源 FireRedChat:一个完整、可控的全双工语音交互系统

    在智能助手和客户服务场景中,用户希望与AI的对话像人与人交流一样自然——可以随时插话、打断、继续,而系统能即时响应。要实现这种体验,需要真正的全双工语音交互能力。 然而,现有方案存在明显短板: 端到端...
    语音模型# FireRedChat# 小红书
    1年前
    8120
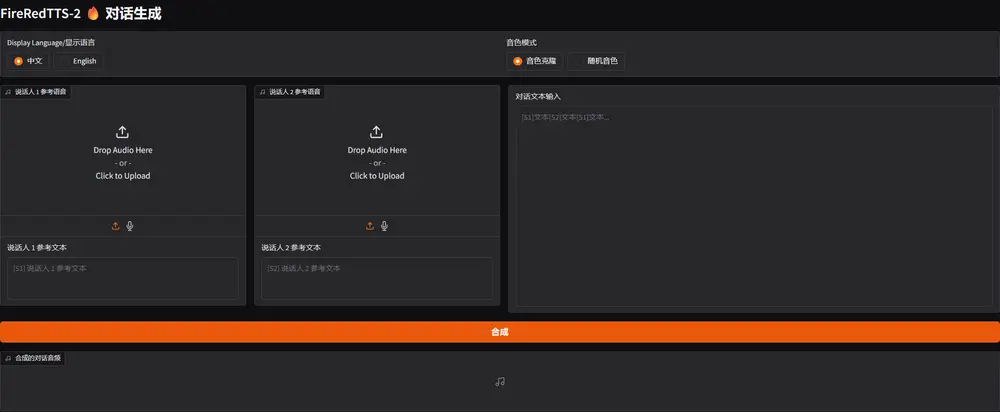
    FireRedTTS-2:面向长对话场景的流式多说话人语音合成系统

    FireRedTTS-2:面向长对话场景的流式多说话人语音合成系统

    在播客制作、智能客服和实时对话系统中,自然流畅的多说话人语音合成是一项关键能力。然而,当前主流的对话式TTS(Text-to-Speech)技术普遍存在几个核心问题: 需要预先提供完整对话文本,无法支...
    语音模型# FireRedTTS-2# 小红书
    1年前
    5200
    小红书 hi lab 开源首个视觉-语言模型:dots.vlm1

    小红书 hi lab 开源首个视觉-语言模型:dots.vlm1

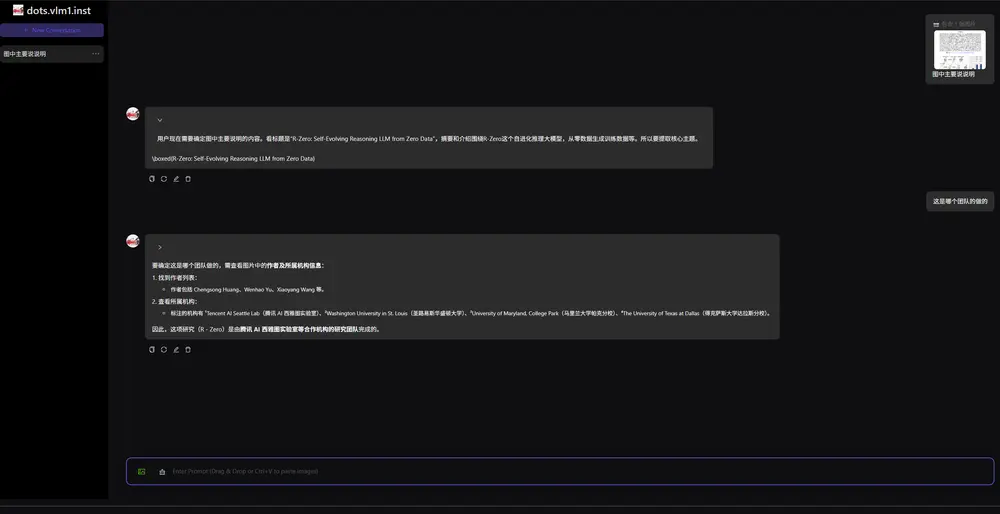
    小红书 hi lab 团队正式发布 dots.vlm1 ——这是“dots”模型家族中的首款视觉-语言模型(VLM),标志着其在多模态理解方向上的重要突破。 GitHub:https://github...
    多模态模型# dots.vlm1# 小红书
    1年前
    6540
    小红书 hi lab 推出 dots.ocr:一个更高效、更统一的文档解析方案

    小红书 hi lab 推出 dots.ocr:一个更高效、更统一的文档解析方案

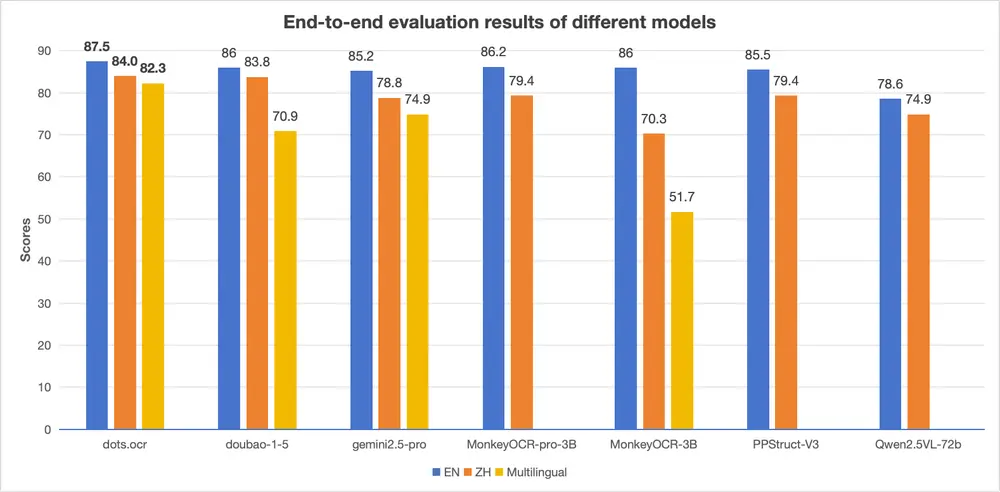
    小红书 hi lab 团队近期发布了一款名为 dots.ocr 的多语言文档解析模型。它不是传统OCR工具的简单升级,而是一次架构层面的重构——将布局检测与内容识别统一在一个视觉-语言模型(VLM)中...
    多模态模型# dots.ocr# 小红书
    1年前
    1,4970
    小红书 Hi Lab 发布 1420 亿参数 MoE 大模型 dots.llm1:推理仅激活 140 亿参数,性能媲美 Qwen2.5-72B

    小红书 Hi Lab 发布 1420 亿参数 MoE 大模型 dots.llm1:推理仅激活 140 亿参数,性能媲美 Qwen2.5-72B

    小红书 Hi Lab 团队近日正式开源了其自研大规模 MoE 文本大模型 dots.llm1,该模型总参数量高达 1420 亿(142B),但在每次推理时仅激活 140 亿(14B)参数,实现了高效能...
    大语言模型# dots.llm1# 小红书
    1年前
    7290
    小红书推出图像生成模型StoryMaker:不仅能保持面部一致性,还能保持服装、发型和身体的一致性,从而通过一系列图像促进故事的创作

    小红书推出图像生成模型StoryMaker:不仅能保持面部一致性,还能保持服装、发型和身体的一致性,从而通过一系列图像促进故事的创作

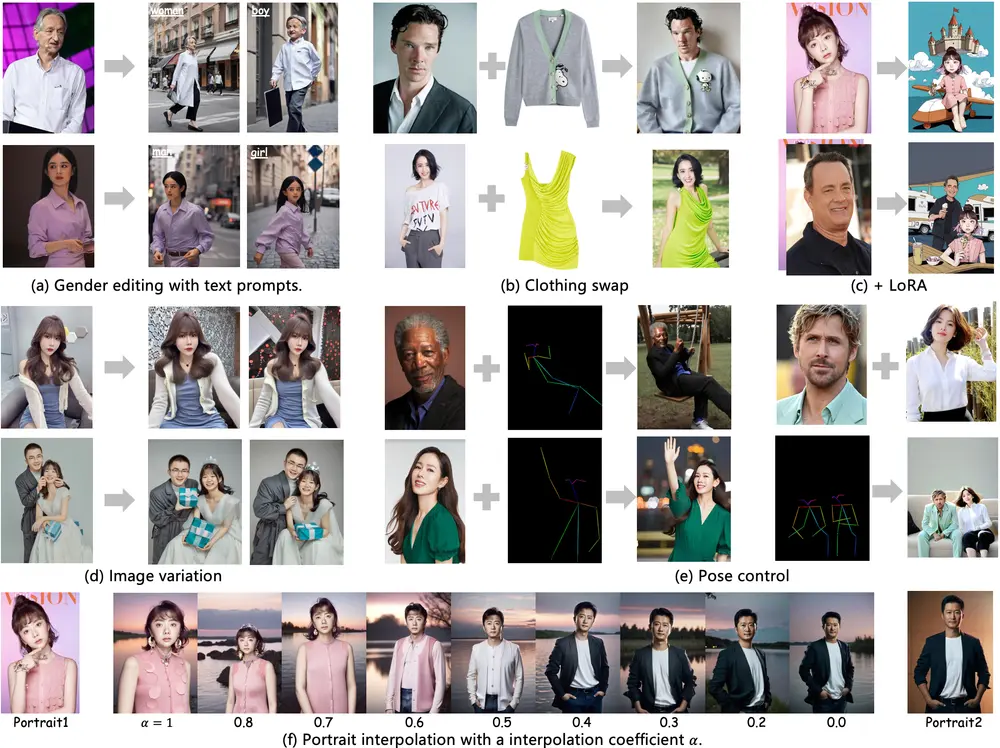
    小红书推出图像生成模型StoryMaker,它专门设计用于在文本到图像的生成过程中保持人物的一致性。这种一致性不仅限于人物的面部特征,还包括服装、发型和身体特征。通过这种方式,StoryMaker能够...
    图像模型# StoryMaker# 小红书
    2年前
    7370
    没有了

    网址

    日榜周榜月榜
    LoginFlip

    LoginFlip

    LoginFlip 是一款专为 Chrome 浏览器设计的轻量级扩展,解决多账号管理痛点。它通过保存和恢复网站的登录状态(Cookie + localStorage),让你在不同身份(工作号、测试号、个人号等)之间实现秒级切换,彻底告别反复输入密码和退出登录的繁琐流程。
    Medeo

    Medeo

    Medeo 允许用户通过简单的文本描述生成视频,无需复杂的编辑界面。它提供超过数百万的高清视频素材,AI 自动匹配场景素材,并优化脚本、添加配音和背景音乐,完美处理过渡和节奏。此外,它能将网页或文章转为专业视频,支持创建动画故事,并提供个人和社区资产库,方便 A/B 测试和多语言配音。
    RSS-AIGC

    RSS-AIGC

    RSS-AIGC是一个非常简易的现代化的 RSS 订阅与 AI 内容聚合平台,专为内容创作者、研究人员和知识工作者设计。系统集成了 AI 报告生成、飞书机器人推送、多源内容聚合等高级功能,帮助用户高效地获取、管理和分析来自 Hacker News、GitHub、ArXiv 等专业平台的内容
    FeedCraft

    FeedCraft

    FeedCraft 是一个简单、强大的 RSS 源处理工具. 他可以作为一个中间件处理你的RSS源, 你可以用它来提取正文、智能翻译、通过AI生成文章摘要、通过自然语言筛选文章等. 它内置了可视化 RSS 生成器 (HTML/Curl/Search to RSS),支持将网页、API (Curl) 或搜索结果转换为 RSS 订阅源。
    Panda Video Generator(熊猫视频自动化引擎)

    Panda Video Generator(熊猫视频自动化引擎)

    Panda Video Generator(熊猫视频自动化引擎)是一站式全自动化的视频内容生成与发布引擎,支持从网页内容提取、文本转视频到多平台发布的完整工作流。通过 AI 驱动的文本转语音(TTS)技术和视频渲染引擎,帮助内容创作者快速生成高质量视频并一键发布到多个平台。
    Click Sync 

    Click Sync 

    Click Sync 是一个基于 WebHID 的多品牌鼠标网页驱动控制台,目标是把不同品牌的配置能力统一到一个浏览器应用里完成,不需要安装本地驱动程序。
    查看完整榜单
    SD百科导航
    SD百科导航是专注于AI创作领域的专业导航网站。我们全面涵盖Stable Diffusion、Flux、AI绘画、AI视频、AI音乐以及大语言模型等前沿内容。

    关于我们友链申请广告合作

    扫码关注微信公众号SD百科导航
    扫码关注微信公众号
    Copyright © 2026 SD百科导航 皖ICP备18025588号-5  皖公网安备34040002000401 
    网址
    网址文章软件模型
      ↵ENTER↓↑NAV

      网址

      日榜周榜月榜
      LoginFlip

      LoginFlip

      LoginFlip 是一款专为 Chrome 浏览器设计的轻量级扩展,解决多账号管理痛点。它通过保存和恢复网站的登录状态(Cookie + localStorage),让你在不同身份(工作号、测试号、个人号等)之间实现秒级切换,彻底告别反复输入密码和退出登录的繁琐流程。
      Medeo

      Medeo

      Medeo 允许用户通过简单的文本描述生成视频,无需复杂的编辑界面。它提供超过数百万的高清视频素材,AI 自动匹配场景素材,并优化脚本、添加配音和背景音乐,完美处理过渡和节奏。此外,它能将网页或文章转为专业视频,支持创建动画故事,并提供个人和社区资产库,方便 A/B 测试和多语言配音。
      RSS-AIGC

      RSS-AIGC

      RSS-AIGC是一个非常简易的现代化的 RSS 订阅与 AI 内容聚合平台,专为内容创作者、研究人员和知识工作者设计。系统集成了 AI 报告生成、飞书机器人推送、多源内容聚合等高级功能,帮助用户高效地获取、管理和分析来自 Hacker News、GitHub、ArXiv 等专业平台的内容
      FeedCraft

      FeedCraft

      FeedCraft 是一个简单、强大的 RSS 源处理工具. 他可以作为一个中间件处理你的RSS源, 你可以用它来提取正文、智能翻译、通过AI生成文章摘要、通过自然语言筛选文章等. 它内置了可视化 RSS 生成器 (HTML/Curl/Search to RSS),支持将网页、API (Curl) 或搜索结果转换为 RSS 订阅源。
      Panda Video Generator(熊猫视频自动化引擎)

      Panda Video Generator(熊猫视频自动化引擎)

      Panda Video Generator(熊猫视频自动化引擎)是一站式全自动化的视频内容生成与发布引擎,支持从网页内容提取、文本转视频到多平台发布的完整工作流。通过 AI 驱动的文本转语音(TTS)技术和视频渲染引擎,帮助内容创作者快速生成高质量视频并一键发布到多个平台。
      Click Sync 

      Click Sync 

      Click Sync 是一个基于 WebHID 的多品牌鼠标网页驱动控制台,目标是把不同品牌的配置能力统一到一个浏览器应用里完成,不需要安装本地驱动程序。
      查看完整榜单