传统文本转语音(TTS)系统往往局限于将文字转换为单调的声音,缺乏真实人类交流中的情感起伏与意图表达。Scenema Audio是一款从 LTX 2.3 视听模型中提取的音频扩散模型,旨在实现真正的“表演性音频生成”。
- 官方介绍:https://scenema.ai/audio
- GitHub:https://github.com/ScenemaAI/scenema-audio
- 模型:https://huggingface.co/ScenemaAI/scenema-audio
它突破了现有语音克隆技术的情感局限,将语音身份与情感表现彻底分离。只需几秒钟的参考音频,Scenema Audio 即可让任何声音以愤怒、喜悦、低语或哭泣等任意情感状态“表演”剧本,并同步生成雨声、人群等环境音效,打造沉浸式的听觉体验。
核心亮点:身份情感分离、场景感知、零样本克隆
1. 零样本表现力语音克隆
- 身份与情感解耦:传统克隆受限于参考音频的情感基调(平静参考只能生成平静语音)。Scenema Audio 则从短参考片段中提取语音身份,而情感表现完全由文本提示和动作标签控制。
- 任意情感演绎:即使参考音频是平静的,模型也能生成激昂、悲伤或恐惧的表演。无需针对每种情感微调模型。
- 极低门槛:仅需 10-20 秒 清晰语音即可建立身份档案,无需注册或复杂训练。
2. 动作标签与动态情感转换
- 舞台指导式控制:在文本提示中嵌入动作标签(如
[whisper],[shout],[sigh]),模型可在单次生成中实时切换情感状态、节奏和强度。 - 细腻表现力:精准控制呼吸、停顿、语速变化,模拟真实人类的非语言发声特征(如笑声、抽泣)。
3. 场景感知音频生成
- 音画同步:语音与环境音效在同一遍生成中完成。描述“雨中对话”,模型会自动生成雨声背景与人声,无需后期叠加。
- 丰富环境库:支持雷声、人群嘈杂声、警报声等多种环境音,增强叙事沉浸感。
4. 自然儿童声音与多语言支持
- 真·儿童音:专为儿童设计的发声模型,呈现适龄的举止特征(如稚嫩语调、不规则节奏),而非简单的成人音调转换。
- 跨语言身份保持:从单个英语参考片段出发,可在 13+ 种语言(中、英、日、韩、法、德等)中生成地道语音,同时保持说话者身份一致。
5. 长格式叙述一致性
- 无限时长支持:通过自动文本分割与上下文连贯性机制,生成有声书、播客或纪录片旁白时,能始终保持音色与风格统一,无上限限制。
技术原理与硬件要求
工作流程
- 文本编码:解析包含动作标签的提示词。
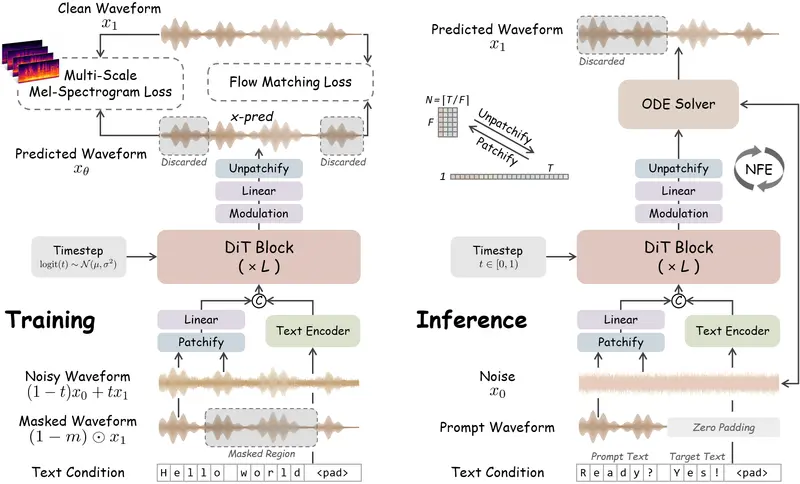
- 音频扩散:基于 LTX 2.3 提取的 Audio Diffusion Transformer 生成原始音频潜变量。
- 后处理:通过 VAE 解码器与声码器还原波形。
- 身份转移(可选):通过 SeedVC 将参考语音的身份特征迁移至生成音频。
硬件需求
- 最低配置:16GB VRAM(需配合 CPU 流式传输文本编码器)。
- 推荐配置:24GB VRAM(全 GPU 加速)。
- 生成速度:在 RTX 4090 上,生成 20 秒片段仅需 5-8 秒。
模型检查点
| 文件 | 大小 | 描述 |
|---|---|---|
scenema-audio-transformer.safetensors | 9.8 GB | 音频扩散 Transformer (BF16) |
scenema-audio-transformer-int8.safetensors | 4.9 GB | INT8 量化版,质量无损,显存更友好 |
scenema-audio-pipeline.safetensors | 6.7 GB | VAE 解码器 + 声码器 + 文本投影 |
scenema-audio-vae-encoder.safetensors | 42.7 MB | 参考语音编码用 VAE 编码器 |
© 版权声明
文章版权归作者所有,未经允许请勿转载。