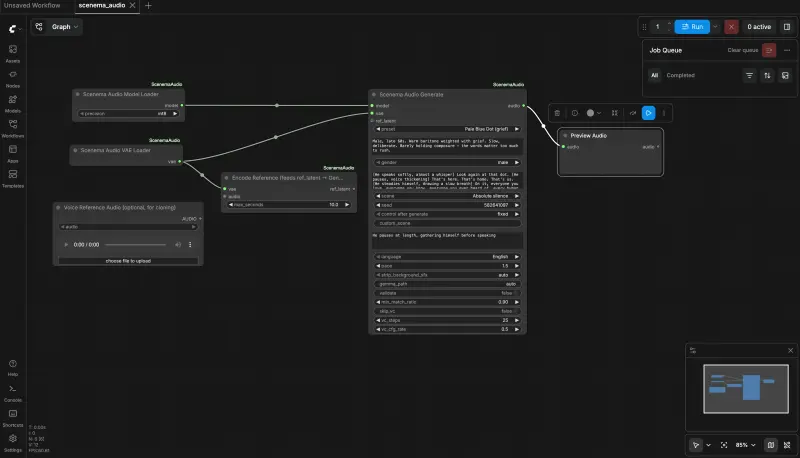
ComfyUI-ScenemaAudio:支持表演级语音生成与零样本克隆的原生节点ComfyUI-ScenemaAudio 是 Scenema Audio 模型的原生 ComfyUI 自定义节点包,基于 LTX 2.3 音频扩散 Transformer 构建,提供超越传统 TTS ...插件# ComfyUI-ScenemaAudio# Scenema Audio3个月前990
Scenema Audio:基于 LTX 2.3 的零样本表现力语音克隆,分离身份与情感,实现“表演级”音频生成传统文本转语音(TTS)系统往往局限于将文字转换为单调的声音,缺乏真实人类交流中的情感起伏与意图表达。Scenema Audio是一款从 LTX 2.3 视听模型中提取的音频扩散模型,旨在实现真正的...语音模型# LTX-2.3# Scenema Audio6个月前2630