ComfyUI-ScenemaAudio 是 Scenema Audio 模型的原生 ComfyUI 自定义节点包,基于 LTX 2.3 音频扩散 Transformer 构建,提供超越传统 TTS 的表演级语音生成能力。该工具支持通过自然语言提示词控制笑声、低语、破音、呼吸、歌唱及外国口音等表现元素,并具备零样本语音克隆功能。
- GitHub:https://github.com/ScenemaAI/ComfyUI-ScenemaAudio
- 官方说明:https://scenema.ai/audio/comfy-ui
安装后自动集成预接线工作流,首次使用需下载约 30 GB 模型权重并完成 HuggingFace Gemma-3-12b-it 文本编码器授权。最低硬件要求为 8 GB 显存,已在 RTX 3070 与 RTX 4090 上验证,生成速度最高可达实时 2 倍。
安装配置与授权流程
部署过程分为节点安装与模型授权两步,缺一不可:
节点安装(二选一)
- ComfyUI Manager(推荐):在 Custom Nodes Manager 中搜索“Scenema Audio”并点击 Install,重启后即用
- 手动安装:克隆仓库至
custom_nodes/目录,执行pip install -r requirements.txt,重启生效
两种方式均会自动在工作流侧边栏生成 Scenema Audio 文件夹,内含预连接工作流模板。
HuggingFace Token 配置
文本编码器 google/gemma-3-12b-it 需单独授权:
- 访问模型页面点击“Agree and access repository”
- 创建 read 权限 token
- 启动 ComfyUI 前通过
huggingface-cli login或环境变量HF_TOKEN注册
未配置 token 时首次生成将失败并提示具体步骤,不会静默出错。模型权重总计约 30 GB,首次运行时自动从 HuggingFace 下载。
工作流结构与核心节点功能
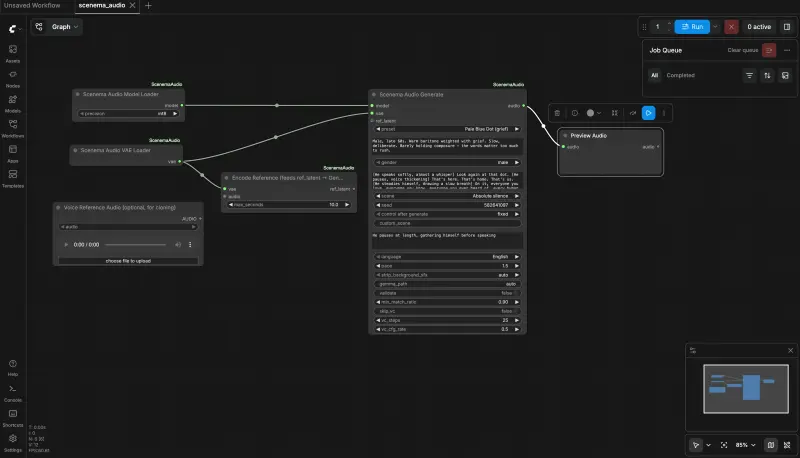
加载预设工作流后,界面呈现六个节点、三个逻辑模块:
- 加载器模块:Model Loader 与 VAE Loader 全局共享,无需重复配置
- 语音克隆模块(可选):LoadAudio → Scenema Audio VAE Encode → Generate 节点的
ref_latent输入;参考音频上限 20 秒,超长不提升质量 - 生成与预览模块:Generate 节点集中处理所有文本输入与表演指令;Preview Audio 节点支持界面内即时试听
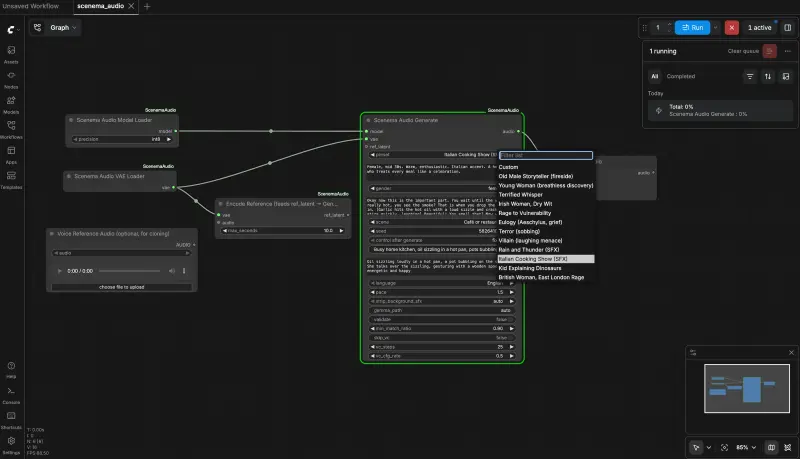
所有预设语音(如 Rage to Vulnerability、Terror、Irish Woman Dry Wit 等)均为下拉菜单一键加载,字段自动填充。选择“Custom”可从头构建自定义语音。
表演控制语法与多语言支持
语音生成效果由三个字段协同驱动:
- 语音描述:定义说话者身份,包括年龄、音色、口音、表达风格(例:“男性,50多岁,奥地利口音,温暖男中音但能瞬间变冷”)
- 动作标签:每行一条开场提示,设定整段表演基调(例:“他说话时面带微笑,却不带一丝温暖”)
- 语音文本:使用
[括号提示]嵌入实时舞台指示,模型在精确位置执行(例:“你知道,[轻柔干笑]我一直觉得礼貌是握刀的一种迷人方式。[声音突然低沉亲密]而与此同时,他们的手已经伸向了你。”)
可用括号提示涵盖笑声、低语、破音、喘息、抽泣、叹息、停顿、情绪转换、强调、呼吸声等,等同于剧本中的表演注释。
支持十二种语言:英语、西班牙语、法语、德语、意大利语、葡萄牙语、日语、韩语、中文、印地语、阿拉伯语、斯瓦希里语。选择目标语言后,需用对应语言编写语音文本以确保发音与韵律准确。
硬件需求与性能边界
- 最低显存:8 GB(RTX 3070 已完整测试)
- 推荐配置:24 GB(RTX 4090 可达实时 2 倍生成速度)
- 性能注意:生成速度受序列长度、表演复杂度及显存带宽影响;8 GB 显存下长序列或高密度表演指令可能触发降速
- 克隆限制:参考音频超过 20 秒无收益,建议选取最具代表性的片段
- 语言精度:非母语提示词可能导致口音偏差,建议用目标语言撰写全部文本字段
对于内容创作者,建议优先使用预设验证工作流连通性,再逐步尝试自定义表演指令。语音克隆适合风格迁移而非精确复刻,法律与伦理合规需自行评估。8 GB 显存用户应预留充足生成时间,避免因超时中断导致重复下载或缓存损坏。
© 版权声明
文章版权归作者所有,未经允许请勿转载。