Prompt Relay 是由南洋理工大学 S-Lab 提出的一种创新方法,解决当前 AI 视频生成模型在多事件时序控制上的核心痛点。它作为一种推理时(Inference-time)、无需训练、即插即用的技术,能够精确控制每个文本提示在视频时间轴上的出现位置和持续时间,让 AI 生成的视频像电影分镜头一样逻辑清晰、过渡自然。
- 项目主页:https://gordonchen19.github.io/Prompt-Relay
- GitHub:https://github.com/GordonChen19/Prompt-Relay
- ComfyUI插件:https://github.com/kijai/ComfyUI-PromptRelay
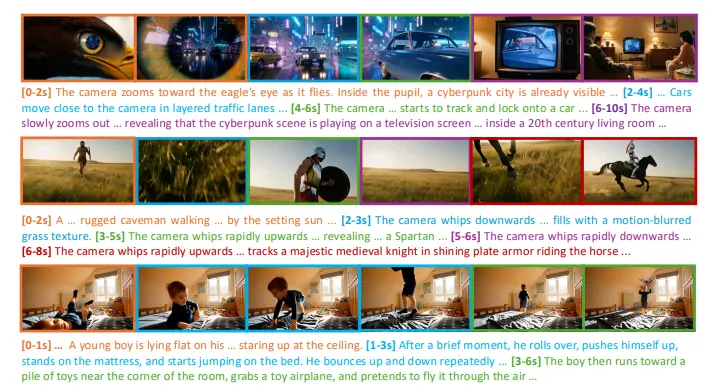
核心痛点:AI 视频的“时序混乱”
现有的主流视频生成模型(如 Sora, Kling, Veo, Wan 等)在处理单一场景或简单动作时表现优异,但一旦面对包含多个先后事件的复杂剧情(例如:“男孩起床 → 跳床 → 玩玩具”),往往会出现:
- 内容串台:后续事件的元素提前出现,或前序事件残留。
- 时间线错乱:动作顺序颠倒或混合。
- 画面突变:场景切换生硬,伴随闪烁或物体变形。
Prompt Relay 正是为了解决这些问题而生,它不需要重新训练模型,也不增加额外的算力负担,却能显著提升多事件视频的生成质量。
主要功能与优势
1. 精准的时间分段控制
- 指令隔离:将视频划分为多个时间段,每个时间段只响应特定的文本提示,互不干扰。
- 精细调度:用户可以精确指定每个事件发生的起始时间、持续时长和先后顺序。
2. 自然的场景过渡
- 柔和切换:通过注意力引导机制,在不同时间段的交界处实现平滑过渡,避免传统硬切换导致的画面突变、闪烁或物体形变。
- 全局连贯:保留一个总体描述(Global Prompt)来统一视频的整体风格、光照和人物特征,确保前后画面的一致性。
3. 即插即用,零成本集成
- 无需训练:不修改模型权重,不需要标注数据,直接在推理阶段生效。
- 兼容性强:可无缝应用于 Wan 2.2, Kling, Veo, Sora 等主流文本生成视频模型。
- 无额外算力:运行速度与原版模型一致,不增加等待时间。
工作原理:AI 的“智能场记”
Prompt Relay 的工作流程类似于电影拍摄中的场记和导演调度:
- 分段拆解:将长剧情脚本按时间切片,例如:
- 0-2秒:“男孩从床上坐起”
- 2-4秒:“男孩在床边跳跃”
- 4-6秒:“男孩拿起玩具车”
- 注意力路由 (Attention Routing):
- 在特定时间点,模型只“关注”当前活跃的文本提示,抑制其他时间段提示的交叉注意力干扰。
- 这减少了语义概念在潜在空间中的竞争,使模型能更专注于当前画面。
- 平滑过渡:
- 在两个时间段的边界,采用加权混合策略,让模型从前一个指令逐渐“接力”到后一个指令,确保视觉连续性。
- 全局风格兜底:
- 始终注入一个全局提示(如“明亮的卧室,卡通风格”),防止因局部指令变化导致整体画风漂移。
测试结果:超越闭源巨头
在与 Wan 2.2 结合使用时,Prompt Relay 展现了惊人的效果:
- 时序准确性第一:在指定时间生成对应画面的准确率上,显著优于未使用该方法的基线模型,甚至超越了 Kling 3.0 和 Veo 3.1 等最新闭源系统。
- 视觉质量提升:由于减少了指令间的干扰,生成的画面更清晰、结构更稳定,物体一致性更好。
- 用户偏好高:在由 30 人参与的盲测中,Prompt Relay 生成的视频在过渡自然度和剧情连贯性上获得最高评分。
© 版权声明
文章版权归作者所有,未经允许请勿转载。