ComfyUI-Woosh 是一款专为 ComfyUI 设计的自定义节点扩展,它将索尼 AI 最新开源的 Woosh 基础模型无缝集成到工作流中。通过该节点,用户可以利用 Woosh 强大的文本到音频(T2A)和视频到音频(V2A)生成能力,轻松为视频项目添加专业级、48kHz 高采样率的音效。
- GitHub:https://github.com/Saganaki22/ComfyUI-Woosh
- 模型:https://huggingface.co/drbaph/Woosh
该扩展不仅支持原版高质量模型,还集成了蒸馏版(DFlow/DVFlow),实现了极速推理,并提供了动态显存管理功能,确保在不同硬件配置下都能稳定运行。
核心功能
1. 双模态音效生成
- 文本到音频 (T2A):输入文字描述(如“雨滴落在窗户上”、“远处雷声”),生成逼真的环境音或动作音效。支持 Flow(高质量)和 DFlow(快速)两种模式。
- 视频到音频 (V2A):上传视频片段,AI 自动分析画面内容(动作、场景),生成与视觉同步的音效。支持 VFlow(高质量)和 DVFlow(快速)两种模式。
2. 极速蒸馏模型
- 4 步生成:使用蒸馏版模型(DFlow/DVFlow),仅需 4 个采样步数即可生成音效,速度比原版提升数十倍。
- 画质无损:在保持极高音质(48kHz)的同时,大幅缩短等待时间,适合快速迭代和批量处理。
3. 智能显存管理
- 动态 VRAM 卸载:利用 ComfyUI 的
ModelPatcher机制,支持 GPU ↔ CPU 内存动态交换。 - 强制卸载 (Force Offload):生成完成后,可自动将模型从显存和内存中清除,下次运行时重新加载。这对于显存有限(如 8GB-12GB)的用户至关重要,避免 OOM 错误。
4. 视频工作流集成
- 直接输出视频帧:V2A 节点可直接输出处理后的视频帧张量,方便连接
VideoCombine节点,一键合成带音效的视频文件。 - 无需额外依赖:Woosh 库已捆绑在节点中,无需手动
pip install,降低了环境冲突风险。
安装方法
方式一:ComfyUI Manager(推荐)
- 打开 ComfyUI Manager。
- 搜索 “Woosh” 或 “ComfyUI-Woosh”。
- 点击 Install 并重启 ComfyUI。
方式二:手动安装
cd ComfyUI/custom_nodes
git clone https://github.com/saganaki22/ComfyUI-Woosh.git
cd ComfyUI-Woosh
pip install -r requirements.txt
模型下载与配置
你需要从 Hugging Face 下载 Woosh 系列模型,并按以下结构放置在 ComfyUI/models/woosh/ 目录中:
必需的基础模型:
Woosh-AE(音频编码器/解码器)TextConditionerA(T2A 文本条件器)TextConditionerV(V2A 文本/视频条件器)
生成模型(按需下载):
Woosh-Flow(高质量 T2A)Woosh-DFlow(快速 T2A)Woosh-VFlow-8s(高质量 V2A, 最大8秒)Woosh-DVFlow-8s(快速 V2A, 最大8秒)
目录结构示例:
ComfyUI/models/woosh/
├── Woosh-Flow/
│   ├── config.yaml
│   └── weights.safetensors
├── Woosh-DFlow/
│   ├── config.yaml
│   └── weights.safetensors
├── Woosh-AE/
│   ├── config.yaml
│   └── weights.safetensors
└── ... (其他模型同理)
注意:每个模型文件夹根目录必须包含
config.yaml和weights.safetensors。
节点使用说明
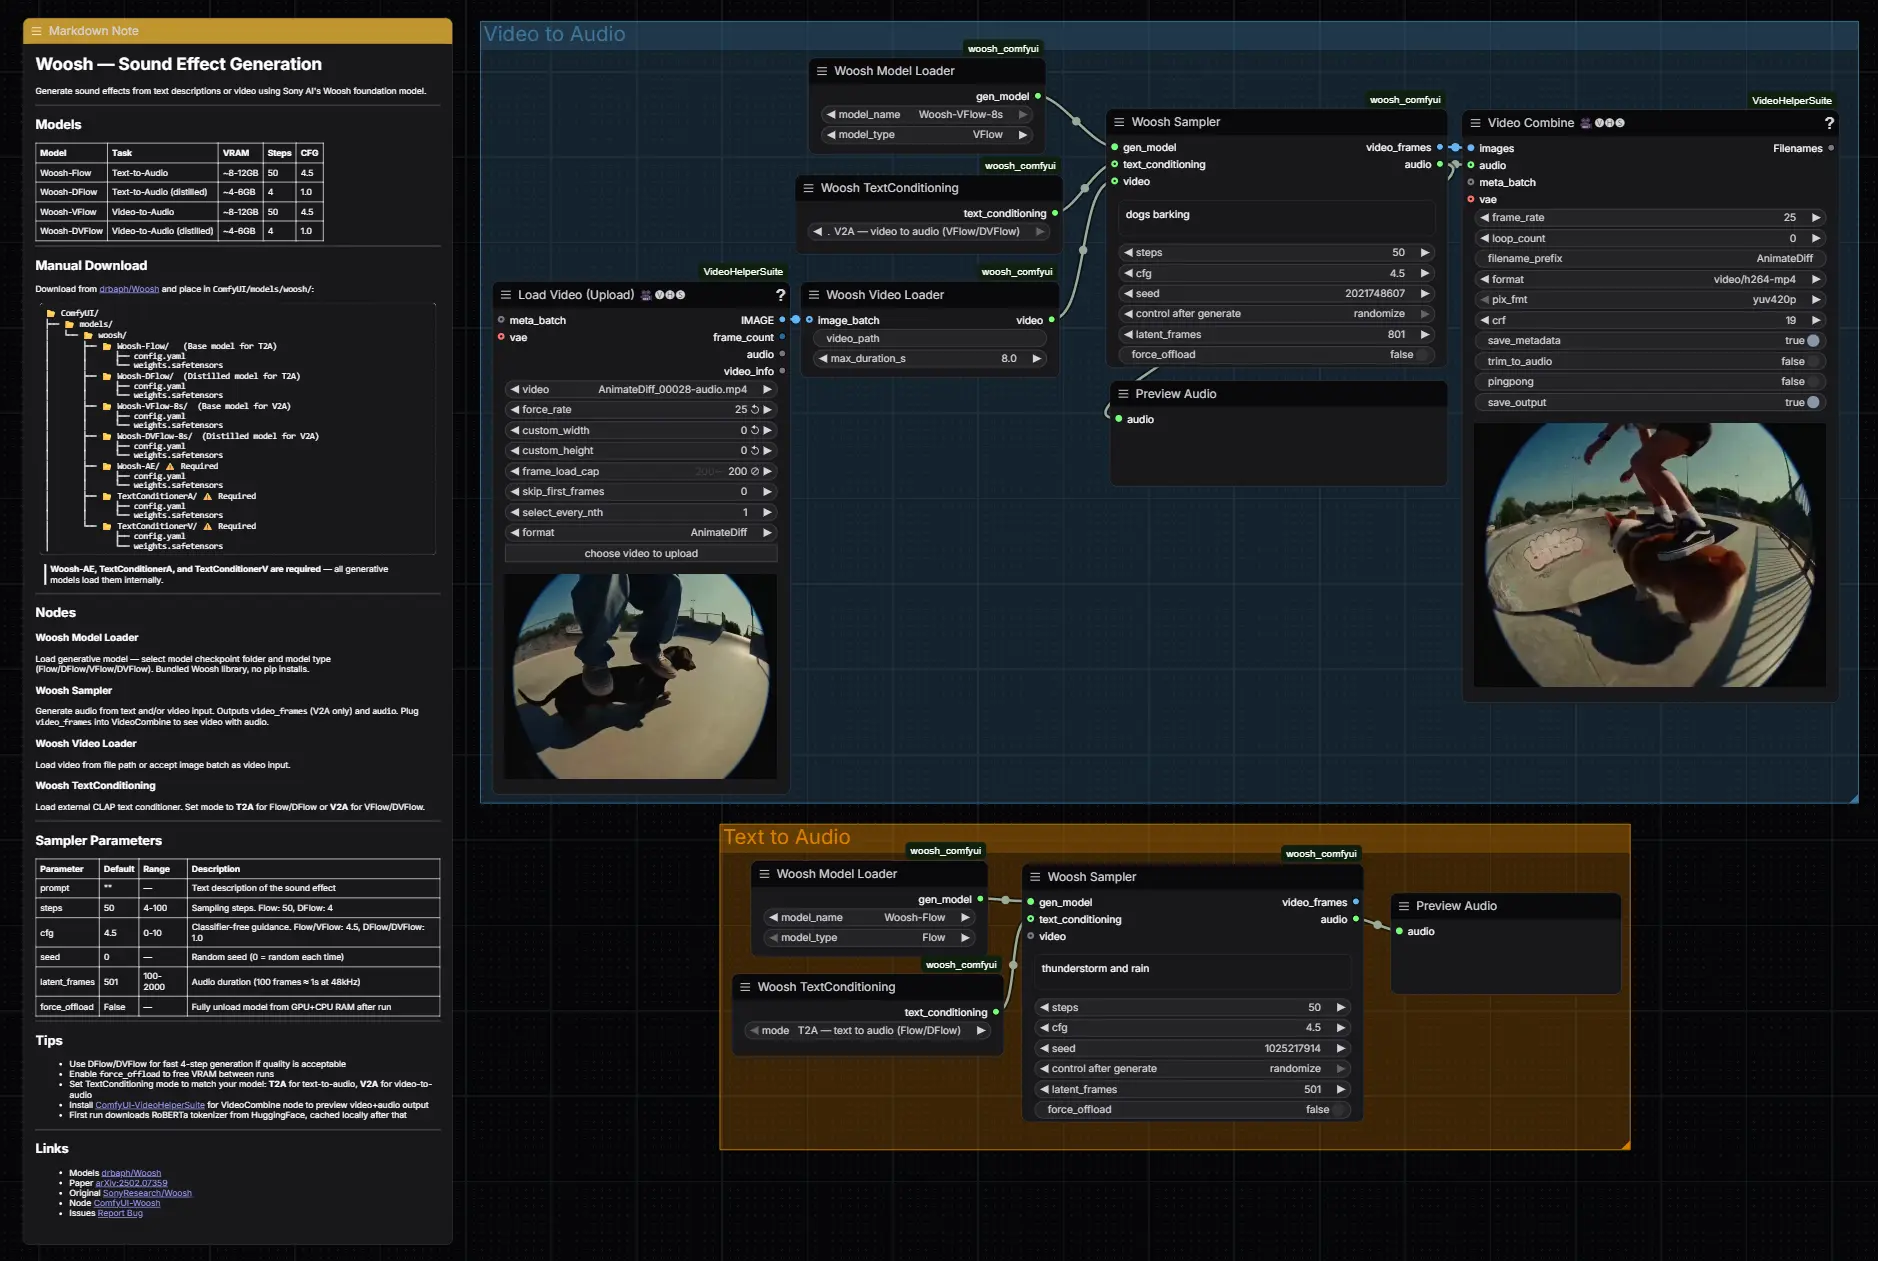
1. Woosh Model Loader
加载指定的生成模型。
- model_name: 选择已下载的模型文件夹。
- model_type: 选择
Flow,DFlow,VFlow, 或DVFlow。
2. Woosh TextConditioning
加载文本条件器,需与生成模型类型匹配。
- mode:
T2A: 用于 Flow/DFlow。V2A: 用于 VFlow/DVFlow。
3. Woosh Video Loader (仅 V2A)
加载视频文件或图像批次。
- video_path: 本地视频文件路径。
- max_duration_s: 限制视频时长(默认 8.0 秒)。
4. Woosh Sampler
核心生成节点。
- gen_model: 连接 Model Loader。
- prompt: 声音描述文本(T2A 必填,V2A 可选以增强语义)。
- steps: 采样步数。Flow/VFlow 推荐 30-50;DFlow/DVFlow 固定为 4。
- cfg: 引导系数。Flow/VFlow 推荐 4.5;DFlow/DVFlow 推荐 1.0。
- latent_frames: 控制音频时长(48kHz 下约 100 帧 ≈ 1 秒)。
- force_offload: 设为
True可在生成后释放显存。
输出:
audio: AUDIO 张量,可连接音频播放或保存节点。video_frames: IMAGE 张量(仅 V2A 模式),可连接VideoCombine。
显存需求参考
| 模型类型 | 推荐 VRAM | 备注 |
|---|---|---|
| Flow / VFlow | 8-12 GB | 高质量模式,显存占用较高。 |
| DFlow / DVFlow | 4-6 GB | 蒸馏模式,显存友好。 |
| 开启 CPU Offload | 2-4 GB | 速度稍慢,但可在低显存卡上运行。 |
典型工作流示例
文本转音效 (T2A)
Woosh Model Loader (Flow) → Woosh TextConditioning (T2A) → Woosh Sampler → Save Audio
视频转音效并合成 (V2A)
Woosh Video Loader→ 输出视频帧。Woosh Model Loader (DVFlow)→Woosh TextConditioning (V2A)→Woosh Sampler。Woosh Sampler输出video_frames和audio。- 连接
VideoCombine节点,将视频帧和音频合并为最终 MP4 文件。
© 版权声明
文章版权归作者所有,未经允许请勿转载。