语音交互正在从简单的指令识别迈向复杂的自然对话与任务执行。OpenAI 今日在 API 中正式推出三款全新的音频模型——GPT-Realtime-2、GPT-Realtime-Translate 和 GPT-Realtime-Whisper。
- 官方介绍:https://openai.com/index/advancing-voice-intelligence-with-new-models-in-the-api
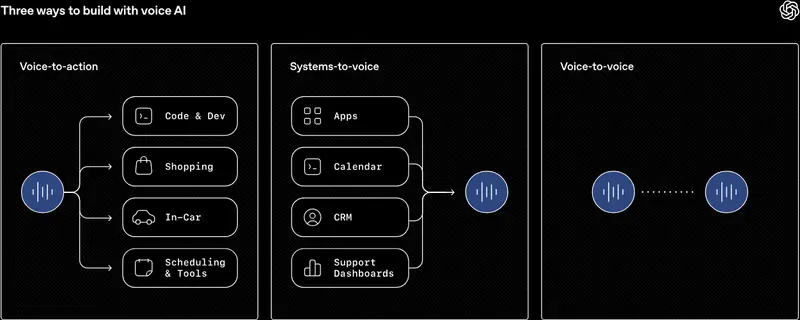
这些模型不仅提升了语音理解的深度,更实现了真正的实时推理、跨语言翻译和流式转录,为开发者构建“语音到行动”、“系统到语音”及“语音到语音”三类新一代应用提供了强大基础设施。
核心模型解析
1. 🧠 GPT-Realtime-2:首个具备 GPT-5 级推理能力的语音模型
这是 OpenAI 迄今为止最强大的实时语音模型,专为处理复杂请求和自然对话而设计。
- GPT-5 级智能:在音频智能评估中比 GPT-Realtime-1.5 高出 15.2%,指令遵循能力高出 13.8%。
- 实时推理与行动:
- 并行工具调用:能在对话进行中同时调用多个外部工具,并透明地展示过程。
- 可调节推理努力:开发者可根据任务复杂度调整模型的思考深度。
- 更强恢复力:能优雅处理用户的打断、更正或模糊指令,保持对话流畅。
- 长上下文代理工作流:支持更长的多轮交互记忆,适合复杂任务编排。
- 可控语气与表达:提供更细腻的情感控制和语调调整,使声音更具人性化。
2. GPT-Realtime-Translate:实时打破语言壁垒
专为构建无缝多语言语音体验而生,让全球用户能用母语自然交流。
- 广泛支持:支持 70+ 种输入语言 翻译成 13 种输出语言。
- 实时同步:翻译速度与说话者节奏保持一致,几乎无感知延迟,适用于跨国会议、实时字幕等场景。
3. GPT-Realtime-Whisper:超低延迟流式转录
新一代语音转文本模型,专注于极致速度与准确性。
- 流式处理:在用户说话的同时实时生成文本,无需等待句子结束。
- 低延迟体验:让语音输入型应用(如语音笔记、实时客服辅助)响应更灵敏、更自然。
三大新兴语音交互模式
随着这些模型的发布,语音 AI 应用正围绕以下三种范式加速创新:
| 模式 | 描述 | 典型应用 |
|---|---|---|
| 语音到行动 (Speech-to-Action) | 用户描述需求,AI 推理、调用工具并完成任务 | 智能助手预订机票、查询数据、控制智能家居 |
| 系统到语音 (System-to-Speech) | 软件将实时上下文转化为语音指导或反馈 | 导航实时指引、游戏 NPC 动态对话、无障碍辅助 |
| 语音到语音 (Speech-to-Speech) | AI 作为中间层,实现跨语言、跨任务的实时对话延续 | 实时翻译耳机、多语言客服、跨语言协作平台 |
安全、定价与可用性
- 安全防护:Realtime API 集成多层防护机制,防止滥用和恶意内容生成。
- 定价策略:
- GPT-Realtime-2:输入 $32 / 百万音频 token,输出 $64 / 百万音频 token。
- GPT-Realtime-Translate:$0.034 / 分钟。
- GPT-Realtime-Whisper:$0.017 / 分钟。
- 立即使用:所有模型现已在 Realtime API 中可用,开发者可通过 Playground 测试,并使用 Codex 快速构建应用。
© 版权声明
文章版权归作者所有,未经允许请勿转载。