网易有道正式发布了 Confucius4-R2T2,一款基于 Qwen3-ASR 架构的低延迟、高准确率真流式(True Streaming)自动语音识别模型。该模型的核心突破在于解决了传统流式 ASR 中常见的“文本回退”和“界面闪烁”问题,实现了输出即稳定的识别体验,为实时语音交互应用树立了新的标杆。
- 项目主页:https://r2t2.ai
- GitHub:https://github.com/netease-youdao/Confucius4-R2T2
- Hugging Face:https://huggingface.co/netease-youdao/Confucius4-R2T2
- 魔搭:https://modelscope.cn/models/netease-youdao/Confucius4-R2T2
- Demo:https://r2t2.youdao.com/demo
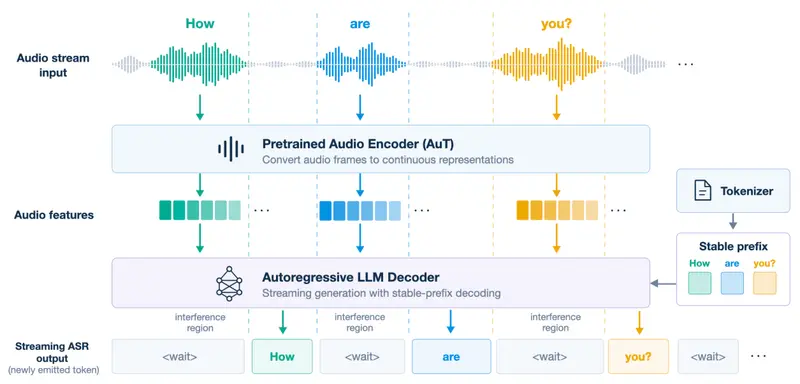
核心亮点:什么是“真流式” (R2T2)?
R2T2 (Real Real-Time Transcription) 的最大特点是已提交的识别文本稳定不变,无需后续修正。
- 传统流式 ASR 的痛点:为了追求低延迟,模型往往会在接收到更多音频上下文后修改之前输出的文字(即“回退”或“修正”),导致下游 NLP 任务出错或用户界面频繁闪烁。
- R2T2 的解决方案:通过引入 最长稳定前缀 (Longest Stable Prefix, LSP) 学习范式,模型能够动态判断何时可以安全地输出文本。一旦输出,即为最终结果。这不仅提升了用户体验,更确保了下游 LLM 智能体或同声传译系统接收到的输入是高质量且一致的。
关键性能指标
| 特性 | 描述 |
|---|---|
| 极低延迟 | 平均延迟仅 200 – 600 毫秒,接近人类感知极限。 |
| 高准确率 | 流式识别准确率接近离线识别水平,在开源模型中达到 SOTA。 |
| 灵活分块 | 支持 80ms 至 2s 的可配置音频步长,用户可根据场景权衡延迟与精度。 |
| 离线无损 | 增加流式能力并未牺牲离线识别的准确率,实现“一模型两用”。 |
| 多语言支持 | 针对中文和英文深度优化,同时广泛支持其他语言。 |
| 原生提示 | 支持上下文关联和热词提示,提升特定领域词汇识别率。 |
技术架构与训练创新
Confucius4-R2T2 构建于强大的 Qwen3-ASR 基础之上,并通过独特的数据构造技术进行强化训练:
- 稳定前缀数据:让模型学习哪些部分是可以立即确定的。
- 强制时间对齐数据:增强音频与文本的时间对应关系。
- 词元级音频切分数据:提供更细粒度的训练信号。
这种训练方式使模型具备了“知道什么时候该说,什么时候该等”的能力,从而在保证低延迟的同时最大化准确率。
部署与推理
为了方便开发者集成,网易有道提供了多种后端支持:
- vLLM 后端:提供高吞吐量的推理服务,适合大规模并发场景。
- Hugging Face Transformers:标准后端,方便快速测试和集成。
- 开源代码:仓库包含完整的推理代码和最小化使用示例,支持离线和实时流式两种模式。
应用场景
得益于其“真流式”特性,Confucius4-R2T2 特别适用于对稳定性和实时性要求极高的场景:
- 实时字幕与听写:无闪烁、无回退,提供流畅的阅读体验。
- LLM 智能体交互:为语音助手提供稳定的文本输入,避免因文本修正导致的指令解析错误。
- 同声传译:确保翻译引擎接收到的源文本是确定的,提高翻译质量和连贯性。
- 实时会议纪要:即时生成准确且不可变的会议记录。
© 版权声明
文章版权归作者所有,未经允许请勿转载。