香港科技大学研究团队在2024年推出 YuE 后,近日发布了其升级版 YuE2。这是一款开源的音乐生成模型,不仅在质量上足以与 Suno v5 等顶尖专有模型媲美,更通过引入可编辑的符号乐谱(Symbolic Score)作为中间层,解决了传统 AI 音乐生成“黑盒化”、难以精确控制的痛点。
- 项目主页:https://map-yue2.github.io
- GitHub:https://github.com/multimodal-art-projection/YuE
- 模型:https://huggingface.co/collections/m-a-p/yue2
YuE2首次实现符号乐谱 + 音频生成双链路统一创作。不仅综合音质跑分超越主流商业模型 Suno v5,更把 AI 音乐创作从“盲生成”带入了“可编辑、可复盘、可迭代”的专业制作时代。
相较于市面上大多数只能一键出歌的 AI 音乐工具,YuE2 最大的颠覆性优势,就是先作曲、后渲染。
简单来说:别的 AI 是直接生成音频,成品好坏全靠运气;而 YuE2 会先写出完整旋律、和弦乐谱,你可以随意修改编曲、调整旋律、优化和声,最后再渲染成人声+伴奏的完整歌曲,全程透明可控。
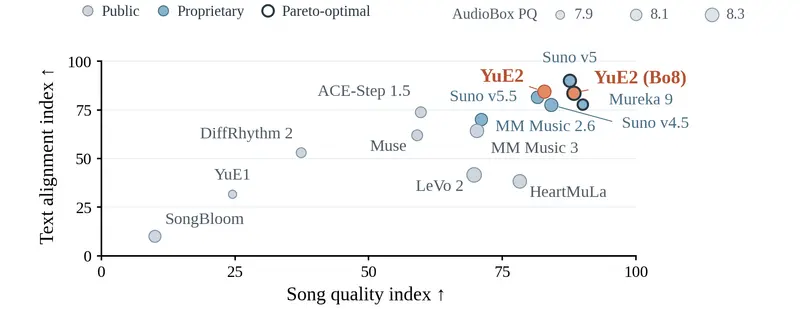
跑分登顶!开源模型逆袭超越商业旗舰 Suno v5
在权威音乐评测基准 WildSongBench 中,YuE2 交出了目前开源模型里的最强成绩单。
在 best-of-8 最优采样模式下,YuE2 综合得分 6.9632,全面超越商业模型 Suno v5 的 6.8721,拿下所有开源、闭源参评模型中的第一名。
这也意味着,免费开源的 YuE2,在歌曲完整性、旋律合理性、曲风贴合度、人声自然度等核心维度,已经达到甚至超越主流商用 AI 音乐的水准。
告别黑盒!YuE2 实现真正的「白盒音乐创作」
目前绝大多数 AI 音乐都属于“一次性黑盒生成”。生成不满意只能重刷,无法精准修改某一段旋律、和弦与编曲,极大限制了专业创作。
而 YuE2 彻底重构了生成逻辑,新增符号音乐规划能力,把 AI 作曲过程完全公开化:
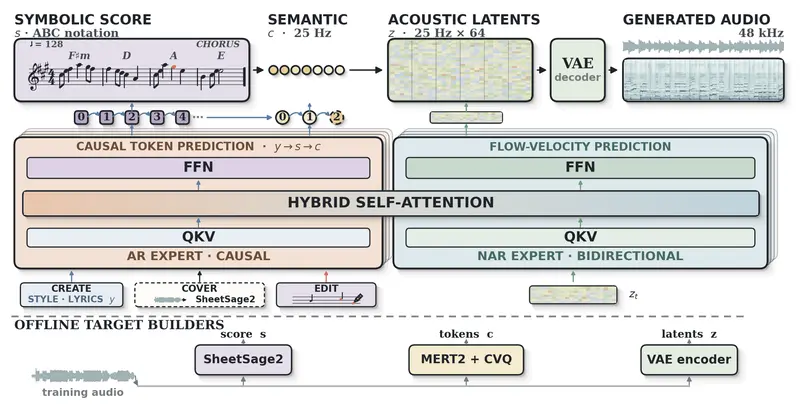
在输出音频之前,模型会先生成完整可编辑的乐谱方案,包含旋律走向、和弦编配、节奏结构。用户可以直接查看、播放、手动修改乐谱,也可以交由 AI 智能迭代优化。
从“靠运气出歌”,升级为“可控、可编辑、可精细化打磨”的专业创作流程,这也是 YuE2 区别于所有同类模型的核心壁垒。
三大核心能力:创作、翻唱、AI 智能迭代编辑
YuE2 一套模型打通了原创作曲、零样本翻唱、智能迭代优化三大场景,适配绝大多数音乐创作需求。
1、文本原创作曲
只需输入歌词+曲风描述,模型自动完成词曲创作,先输出标准化 ABC 乐谱,再渲染出带人声、完整伴奏的立体声成品歌曲,全程自动化、结构完整、曲风统一。
2、零样本风格翻唱
支持导入任意原唱音频,AI 自动提取核心旋律乐谱,保留原曲结构的同时,一键重构曲风、和声、编曲,实现无损跨风格翻唱,无需训练微调。
3、AI 代理对话式编辑
这是最具创新性的功能。你可以用自然语言提出修改意见,AI 会自动解读需求,反向修订乐谱、歌词、编曲和曲风,多轮迭代打磨成品。
官方演示将《The Last Train》从普通话流行曲风,经过 9 轮迭代、14 个版本优化,最终改成英文爵士版本,全新编排和声、新增萨克斯独奏,全程可追溯每一轮的乐谱、提示词和歌词变化。
轻量化部署 + 完整开发者能力
相比一众高门槛 AI 音乐模型,YuE2 的本地部署门槛非常友好:仅需 24GB 显存 GPU,即可直接生成 48kHz 高清立体声歌曲,无需量化压缩、无需特殊适配。
同时面向开发者开放全套能力:支持 Hugging Face 快速加载、CFG 文本精准调控,还拆分出独立的规划、合成、解码 API,开发者可以自由搭建专属作曲、编曲、翻唱工具。
技术原理:分层式 AI 作曲架构
YuE2 采用 AR-NAR 混合 MoE Transformer 主干架构,创作逻辑高度模拟人类音乐人:
先通过自回归方式预测乐谱、语义令牌,完成整首歌的结构规划;再通过流匹配算法生成声学潜变量,最终由 VAE 解码输出高清立体声音频。
原创、翻唱、编辑三种模式,仅乐谱来源不同:由模型原创生成、由音频转写提取、由 AI/人工修订优化,底层统一架构,效果稳定可控。
整套工作流对外开放分段式 Python API,用户可以单独复用乐谱规划、单独合成音频,灵活度拉满。
© 版权声明
文章版权归作者所有,未经允许请勿转载。