由巴黎综合理工学院和上海交通大学联合研究团队推出的 TinyMU,是一款革命性的轻量化音乐理解大模型。它旨在解决当前音乐 AI 模型参数量巨大、运行成本高、难以部署在边缘设备上的痛点,让“听懂音乐”的 AI 能力真正普及到手机、智能耳机等日常终端。
- GitHub:https://github.com/xiquan-li/TinyMU
- 模型:https://huggingface.co/AndreasXi/TinyMU
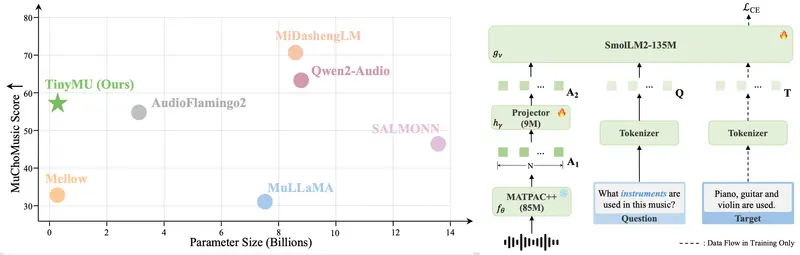
核心突破:小而强
1. 极致轻量,边缘部署
- 超小体积:仅拥有 2.29 亿参数,是顶尖音乐大模型(如 MusicLM 或大型多模态模型)的 1/35。
- 低成本运行:训练和推理成本极低,无需依赖强大的云端服务器,即可在手机、嵌入式设备上流畅运行。
- 隐私保护:本地化处理意味着用户音乐数据无需上传云端,更好地保护隐私。
2. 性能不打折
尽管体量微小,TinyMU 在专业基准测试中表现惊人:
- 综合效能:达到顶尖大模型 82% 的性能水平。
- 乐器识别:准确率高达 95.1%,超越所有对比模型。
- 风格识别:准确率达到 65.7%,远超同量级小模型。
- 复杂推理:在深度音乐分析任务中取得 58.6% 的准确率,证明其具备真正的理解而非简单的模式匹配。
主要功能
TinyMU 不仅能“听”,还能“说”和“想”:
- 风格与乐器识别:精准分辨流行、古典、摇滚等风格,以及钢琴、吉他、小提琴等具体乐器。
- 音乐描述生成:自动为音乐片段生成贴合语义的描述性文字,说明其特点、情绪和氛围。
- 智能问答交互:回答关于节奏快慢、情绪特点、演奏方式等各类音乐相关问题。
- 深度音乐推理:超越简单标签,能对音乐结构、情感变化进行逻辑分析和推理。
工作原理:三步实现“听懂”
TinyMU 采用高效的架构设计,将音频信号转化为语言理解:
- 特征提取:使用专用的音频编码器,从原始波形中提取旋律、节奏、音色等关键细节。
- 模态对齐:通过一个轻量级的线性转换器(Projector),将音频特征“翻译”成小型语言模型(LLM)能理解的嵌入向量。
- 语言作答:小型 LLM 结合音乐信息和用户提问,生成自然、准确的文本回复。
训练数据:基于包含 350 万条记录的音乐问答数据集(MusicQA),涵盖选择题、判断题和开放问答题,确保模型学习的全面性。
测试结果亮点
| 测试维度 | TinyMU 表现 | 对比优势 |
|---|---|---|
| 乐器识别 | 95.1% | 超越所有对比模型 |
| 风格识别 | 65.7% | 远超同量级小模型 |
| 复杂推理 | 58.6% | 达到顶尖大模型 82% 的水平 |
| 描述生成 | 高语义贴合度 | 接近顶尖大模型效果 |
关键发现:
- 混合训练更有效:同时使用多种问答格式(选择、判断、开放)训练,比单一格式效果显著提升。
- 全量微调更强:对语言模型部分进行全量微调,比仅微调投影层或部分参数能带来更强的理解能力。
应用前景
- 智能音乐助手:集成到手机音乐 App 中,提供实时的歌曲介绍、风格分析和个性化推荐解释。
- 可穿戴设备:在智能耳机中实现本地化的音乐识别与互动,无需联网即可回答“这是什么乐器?”
- 音乐教育工具:帮助学生快速识别乐曲结构、乐器配置,提供即时反馈。
- 无障碍辅助为视障人士提供详细的音乐场景描述,增强听觉体验。
© 版权声明
文章版权归作者所有,未经允许请勿转载。