由 MOSI.AI、OpenMOSS 团队和上海人工智能实验室联合打造的 MOSS-Audio 正式开源。这是一款专为复杂现实世界音频设计的统一理解模型,不仅支持语音转录,更能深度解析环境声、音乐、情感及时间线索,具备强大的多步推理能力。
- 模型:https://huggingface.co/collections/OpenMOSS-Team/moss-audio
此次发布包含四个模型变体:4B/8B 参数量级,分别提供 Instruct(指令遵循)和 Thinking(思维链推理)版本。其中,MOSS-Audio-8B-Thinking 在多项权威基准测试中超越了所有开源模型,甚至媲美部分闭源巨头。
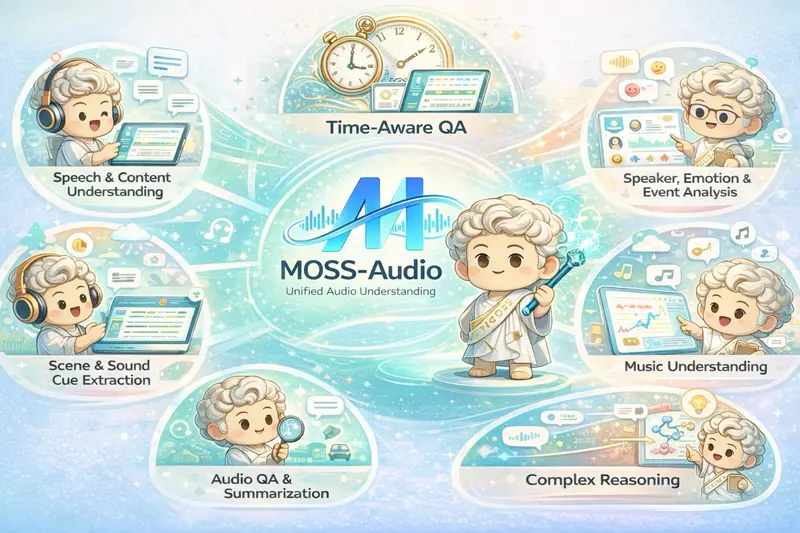
核心亮点
1. 全能音频理解
MOSS-Audio 打破了传统 ASR(自动语音识别)的局限,实现了从“听清”到“听懂”的跨越:
- 语音与内容:高精度转录,支持词级/句级时间戳对齐。
- 场景与情感:识别说话人特征、情感状态,提取背景噪音、环境声及音乐线索,推断场景氛围。
- 复杂推理:基于思维链训练,能回答关于播客、会议录音的多跳推理问题,生成结构化摘要。
2. 极致的时间感知
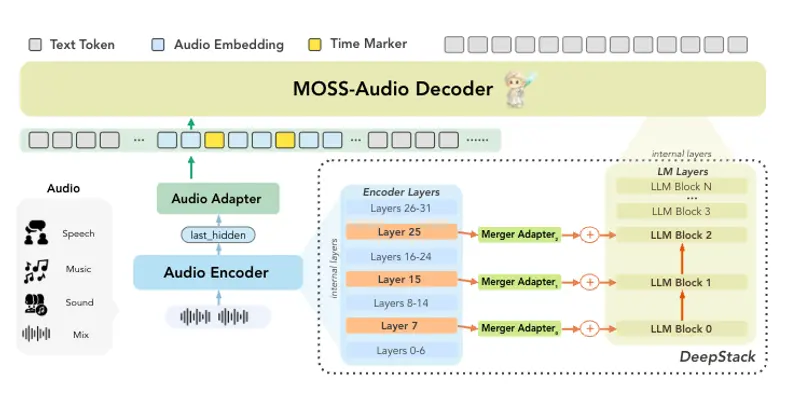
- 时间标记插入策略:在预训练阶段引入显式时间 Token,使模型天然具备“何时发生何事”的感知能力。
- SOTA 时间戳 AS9:在 AISHELL-1 中文基准上,MOSS-Audio-8B-Instruct 的 AAS(平均绝对误差)仅为 35.77,大幅优于 Qwen3-Omni (833.66) 和 Gemini-3.1-Pro (708.24)。
3. 创新架构:DeepStack + 专用编码器
- 从头训练的编码器:不依赖现成前端,自研 MOSS-Audio-Encoder,提供更鲁棒的声学表示。
- DeepStack跨层注入:将编码器的早期、中间层特征(保留韵律、瞬态细节)与高层语义特征共同注入 LLM,解决传统模型丢失低级声学细节的问题。
性能评估:小身材,大能量
1. 通用音频理解 (Accuracy ↑)
在 MMAU、MMAR 等综合基准上,MOSS-Audio-8B-Thinking 平均准确率达到 70.80,超越所有开源模型(如 Kimi-Audio, Qwen2.5-Omni),并接近 Step-Audio-R1 (33B) 的水平。
| 模型 | 大小 | 平均准确率 |
|---|---|---|
| MOSS-Audio-8B-Thinking | 8B | 70.80 |
| MOSS-Audio-4B-Thinking | 4B | 68.37 |
| Step-Audio-R1 | 33B | 70.67 |
| Qwen3-Omni-30B-A3B | 30B | 67.91 |
| Kimi-Audio | 7B | 61.14 |
2. 语音识别 (CER ↓)
在涵盖方言、歌唱、嘈杂环境等12个维度的 ASR 测试中,MOSS-Audio-8B-Instruct 取得最低整体字符错误率 (11.30),尤其在方言、歌唱及健康状态(如咳嗽、呼吸声)识别上表现卓越。
3. 语音描述质量
MOSS-Audio-Instruct 变体在 13 个细粒度语音描述维度中的 11 个上领先,8B-Instruct 获得最佳平均分 (3.7252),能生成更自然、细节更丰富的音频文字描述。
模型家族
| 模型名称 | 主干 LLM | 总参数量 | 特点 |
|---|---|---|---|
| MOSS-Audio-4B-Instruct | Qwen3-4B | ~4.6B | 轻量级,指令遵循优化,适合端侧部署 |
| MOSS-Audio-4B-Thinking | Qwen3-4B | ~4.6B | 增强推理能力,适合复杂逻辑分析 |
| MOSS-Audio-8B-Instruct | Qwen3-8B | ~8.6B | 综合性能平衡之选,ASR 精度极高 |
| MOSS-Audio-8B-Thinking | Qwen3-8B | ~8.6B | 开源最强音频理解模型,推理能力顶尖 |
应用场景
- 智能会议助手:精准区分多说话人,生成带时间戳的会议纪要,识别关键决策点。
- 多媒体内容检索:通过自然语言搜索视频/音频中的特定事件(如“找到背景音乐响起且主角大笑的片段”)。
- 无障碍辅助为视障人士提供包含环境声、情感语调在内的丰富场景描述。
- 影视后期制作:自动标注音效位置,辅助剪辑师快速定位素材。
- 安全监控:识别异常声音事件(如玻璃破碎、呼救声)并结合上下文进行报警。
© 版权声明
文章版权归作者所有,未经允许请勿转载。