Miso Labs 正式发布了 MisoTTS,一款拥有 80 亿参数的开源文本转语音(TTS)模型。作为首款采用残差向量量化(RVQ)技术的开放权重 TTS 模型,MisoTTS 不仅实现了低至 110 毫秒的推理延迟,更通过引入音频上下文条件化,能够根据对话者的语气生成富有情感和表现力的语音,彻底打破了传统 TTS 的“机械感”与“恐怖谷”效应。
- 官方介绍:https://www.misolabs.ai/blog/miso-tts-8b
- GitHub:https://github.com/MisoLabsAI/MisoTTS
- 模型:https://huggingface.co/MisoLabs/MisoTTS
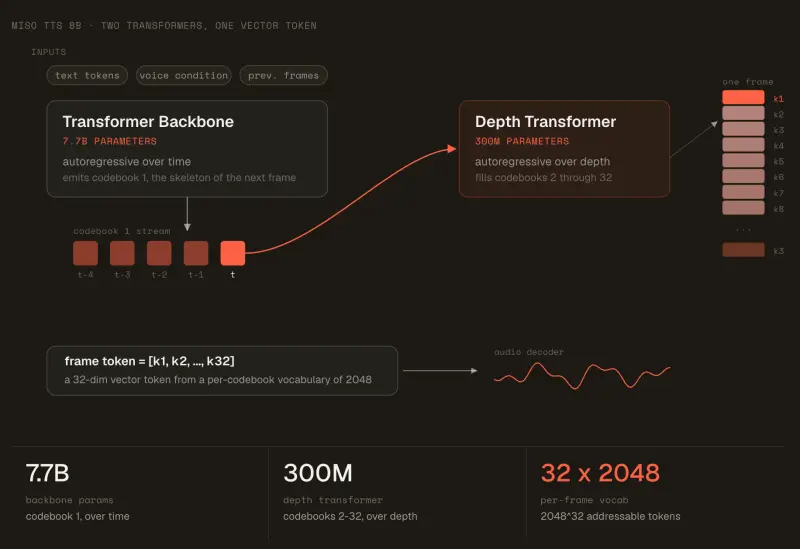
核心亮点:RVQ 架构与极致表现力
1. 残差向量量化(RVQ):指数级声音空间
- 解决词汇表瓶颈:传统 TTS 受限于固定离散 Token 词汇表,难以覆盖人类语音在音调、节奏、情感上的无限变化。MisoTTS 采用 RVQ 技术,每个音频 Token 由 32 个码本索引组成(每个来自 2048 路码本)。
- 参数高效扩展:在不增加模型参数的前提下,将可寻址的 Token 空间扩展至约 2048³² (≈10¹⁰⁵),远超传统方法,实现了极高的声音丰富度与细腻度。
2. 音频上下文条件化:拒绝“恐怖谷”
- 双向条件输入:模型不仅以文本为条件,还接受先前的音频片段作为输入。这使得 MisoTTS 能够感知说话者的语气、情绪及对话节奏,并做出自然回应。
- 交互式对话体验:通过交错排列文本与音频 Token,主干网络能利用完整的对话历史,生成更具连贯性和情感共鸣的语音。
3. 超低延迟:110ms 实时响应
- 双 Transformer 架构:
- 主干网络(77B 参数):随时间自回归运行,预测第一个码本索引及隐藏状态。
- 解码器(3B 参数):在深度上自回归运行,复用相同参数逐位预测剩余码本索引。
- 性能对比:实测延迟仅 110ms,显著优于 ElevenLabs (700ms) 和 Sesame (300ms),为实时语音交互提供了坚实基础。
技术架构详解
| 组件 | 规格/功能 |
|---|---|
| 主干网络 | 77 亿参数 Llama 3.2 风格 Transformer,处理文本与音频序列 |
| 音频解码器 | 3 亿参数小型解码器,负责 RVQ 码本的深度预测 |
| 音频分词器 | Mimi,最大序列长度 2,048 |
| 词汇表 | 文本 128,256 Tokens + 32 个音频码本 |
| 精度 | torch.bfloat16 |
| 许可协议 | 修改后的 MIT 许可(开放权重) |
优势与挑战
✅ 核心优势
- 开放权重:发布即开源,支持本地部署,确保敏感音频数据不出域。
- 高表现力:RVQ 技术赋予模型极高的声音动态范围与情感捕捉能力。
- 低延迟:110ms 的响应速度使其适用于实时对话场景。
- 透明度高:架构细节与数学原理已在博客中完整公开。
⚠️ 当前局限
- 半双工限制:目前仅支持单轮交互,尚未实现无缝的轮次交替(Full-duplex)。
- 硬件要求:80 亿参数模型需要具备足够显存的 CUDA GPU 才能高效运行。
- API 待发布:官方 API 访问权限尚未开放,需自行部署推理。
- 第三方验证 pending:延迟与音质声明仍需社区广泛测试验证。
适用场景
- 实时语音助手:低延迟特性使其成为构建自然对话型 AI 助手的理想选择。
- 影视与游戏配音:高表现力与情感控制能力适用于需要细腻情绪表达的角色配音。
- 企业客服与培训:本地部署保障数据隐私,适用于金融、医疗等敏感行业的语音交互应用。
- 有声书与内容创作:生成富有感染力且自然的朗读音频,提升听众体验。
© 版权声明
文章版权归作者所有,未经允许请勿转载。