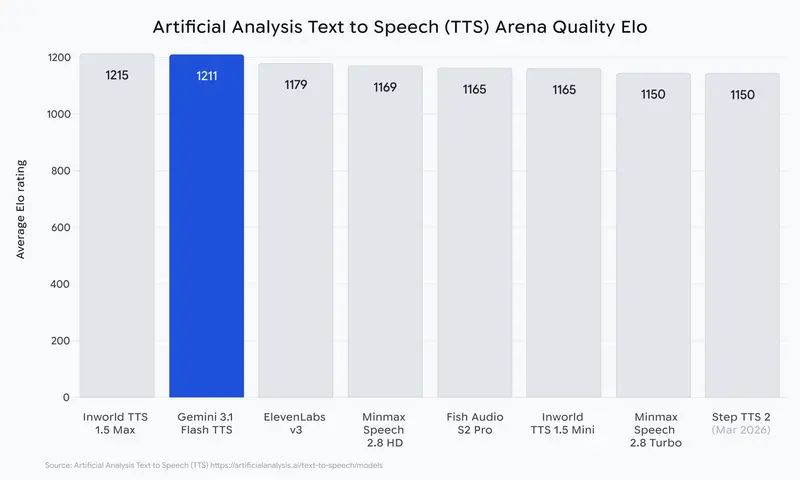
谷歌正式推出 Gemini 3.1 Flash TTS(文本转语音)预览版模型。这不仅是语音质量的提升,更是一次从“黑盒生成”向“细粒度指令控制”的范式转变。该模型在 Artificial Analysis TTS 排行榜上取得了 1,211 的 Elo 得分,成为谷歌迄今为止最自然、最具表现力的语音模型,并被定位为“高质量与低成本”的理想平衡点。
- Google AI Studio:http://aistudio.google.com/generate-speech
- Vertex AI:https://console.cloud.google.com/vertex-ai/studio/media/speech
- Google Vids:https://docs.google.com/videos/create?usp=blog
核心突破:像导演一样指挥 AI 声音
1. 音频标签 (Audio Tags) 与自然语言控制
开发者不再依赖静态配置,而是可以通过自然语言提示和内联音频标签直接指导语音表演:
- 风格与语调:指示模型根据场景调整情绪(如“兴奋地”、“低声耳语”)。
- 节奏与重音:精确控制语速、停顿和强调,满足叙事需求。
- 口音与方言:利用对 70+ 种语言的原生支持,捕捉本地化细微差别。
- 场景指导:通过定义环境背景(World-building),让角色在多轮对话中保持“入戏”,实现更自然的互动。
2. 原生多说话人对话
- 单次调用生成:无需多次 API 调用来拼接不同角色的声音。Gemini 3.1 Flash TTS 可原生处理多角色对话,自动区分说话人并保持对话流的连贯性与自然度。
- 角色特异性:为每个说话人设置独特的音频配置文件(Casting),并可在句子级别通过标签临时切换表达方式。
3. SynthID 水印:安全与透明
- 不可感知嵌入:所有生成的音频均内置 SynthID 水印,不影响听感体验。
- 可靠检测:帮助平台和内容创作者识别 AI 生成内容,防止虚假信息传播,确保数字生态系统的透明度。
技术规格与性能
| 特性 | 详情 |
|---|---|
| 模型名称 | Gemini 3.1 Flash TTS (Preview) |
| Elo 得分 | 1,211 (Artificial Analysis TTS 排行榜) |
| 语言支持 | 70+ 种语言,高保真本地化发音 |
| 核心控制 | 音频标签、自然语言指令、多说话人原生支持 |
| 安全性 | 集成 SynthID 不可感知水印 |
| 可用平台 | Gemini API, Google AI Studio, Vertex AI, Google Vids |
应用场景与开发者工作流
1. 沉浸式游戏与影视配音
通过“场景指导”功能,开发者可以为 NPC 或角色设定复杂的背景故事和情感状态,AI 能据此生成具有电影质感的表演,而非机械朗读。
2. 全球化内容本地化
支持 70 多种语言的高保真输出,使得跨国企业能快速将培训视频、营销内容转化为带有当地口音和情感色彩的语音版本,大幅提升用户亲和力。
3. 交互式 AI 助手
原生多说话人支持使得构建多人参与的 AI 互动场景(如虚拟会议、角色扮演聊天机器人)变得极其简单且成本低廉。
4. 无缝导出与复用
在 Google AI Studio 中调试好的“导演笔记”和参数可直接导出为 Gemini API 代码,确保在不同项目和平台间保持一致的语音品牌形象。
© 版权声明
文章版权归作者所有,未经允许请勿转载。